デジタルにつながったこの時代、私たちは誰もが毎日、膨大な数のデータポイントを生み出している。何を検索するか。どのように検索するか。何を買い、何を読むか。何を好み、何を好まないか。誰と付き合うことを選ぶか、そしてそれ以外にも数え切れないほどある。そうしたデータは絶え間なく流れ続け、数値化し、選別し、他の人々のデータとまとめて分析することで、これまで隠れていたパターンを明らかにできる。ときには、自分自身についてさえ気づいていないことが見えてくる。
そうしたデータは、社会として人々が本当はどのような人なのかを真に理解するための、よりよい方法をもたらすかもしれない。著者セス・スティーブンス=ダビドウィッツは、新著でこの考えを提示している。『誰もが嘘をつく:ビッグデータ、新しいデータ、そしてインターネットが明かす本当の私たち』元Googleのデータサイエンティストで、ウォートン校の客員講師でもあるスティーブンス=ダビドウィッツは、次の番組に出演した。Sirius XMのチャンネル111「Knowledge@Wharton Show」適切に分析されたビッグデータから、私たちの政治的見解や健康、偏見などについて何が明らかになるのかを語るためだ。
以下は、会話を編集した transcript である。
Knowledge@Wharton:私たちのデジタル上の足跡が、私たちのことを多く物語るのは間違いありません。しかし、こうした情報からこれほど多くのことが分かるという考えを、今もある程度、懐疑的に受け止める人がいるように感じます。
スティーブンス=ダビドウィッツ:そうですね。データとはこういうものだという従来の考え方を持つ人もいます。代表性のある調査のようなものを思い浮かべるのです。明確な質問があり、回答者はチェックボックスに分かりやすく答えられる。インターネットという予測不能な世界では、データはもっと非構造的で、慣れ親しんだものとは少し違うので、居心地の悪さを感じるのだと思います。
Knowledge@Wharton:人々は、自分のデータが実際よりも安全に守られていると、今も信じているように感じますか?
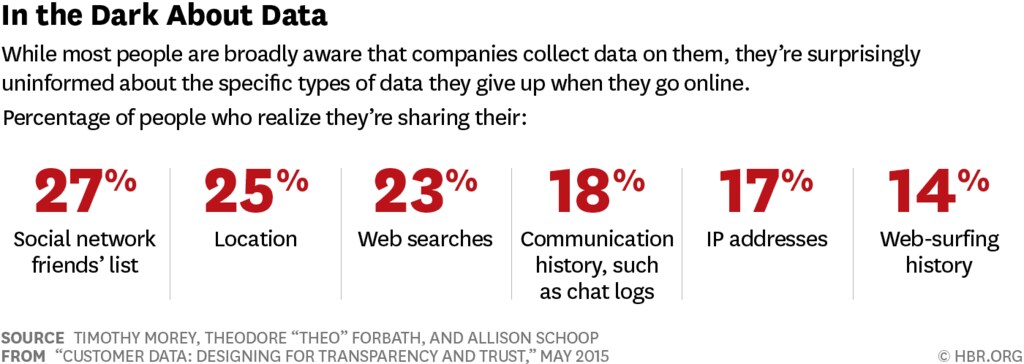
スティーブンス=ダビドウィッツ:ビッグデータの力については、確かに懸念があります。データには高い予測力があるため、企業はそれを使って人々につけ込む可能性があります。本でも取り上げています。たとえば、融資を申し込むと、申込書で使った言葉だけから、返済するかどうかを企業が予測できます。融資の申請で「神」という言葉を使う人は、債務不履行になる可能性、つまり返済しない可能性が2.2倍高いのです。だから企業は、申請の最後に「神のご加護を」と書く人に融資しないことで、経費を節約できるかもしれません。かなり恐ろしいことです。
Knowledge@Wharton:本書では、人種差別や児童虐待など、社会が抱える大きな問題をいくつか取り上げています。こうした分野には、どちらか一方に傾くさまざまなデータポイントがあります。
スティーブンス=ダビドウィッツ:そうですね。今はウェブ上に膨大な情報があります。私がよく注目するGoogleのような情報源もあります。人々は本当に率直で、ほかの誰にも話さないようなことをGoogleには伝えます。ですから、今おっしゃったような非常に重要な分野について、私たちが何者なのかを新たな視点から深く知ることができます。
Knowledge@Wharton:あなたが考察している分野の一つは、性に関することですね。
スティーブンス=ダビドウィッツ:ビッグデータの力で、私はセックスの専門家になったと言うことがあります。もともと私の専門分野ではありませんでしたから。性は気まずく、タブー視される分野なので、嘘が多いのは当然です。人々が何を好むかについて、Google検索からはもっと多くのことを学べると思います。
Knowledge@Wharton:人種差別についても調べていますね。2008年の大統領選の最中より、オバマ大統領の当選直後に人種差別がより顕著に表れたと述べています。
スティーブンス=ダビドウィッツ:このデータには不穏な側面があります。一般に、人々が自分をよく見せるために嘘をつくなら、私たちは人々を実際以上に楽観的に捉えてしまいます。しかし真実を知れば、残念ながら多くの分野で、人々の暗い面を知ることになります。人種差別もその一つです。衝撃的です。このデータを見てすぐに分かった、最も意外なことの一つは、人々が人種差別的な検索を驚くほど多く行っていたことです。基本的には、アフリカ系アメリカ人を嘲笑するジョークを探していました。そして確かに、オバマの当選直後には、彼に関する非常に悪質な検索が大きなテーマとなっていました。
Knowledge@Wharton:人種差別は南部に多い現象だという見方が長くありましたが、あなたのデータは必ずしもそうではないことを示しました。
スティーブンス=ダビドウィッツ:そうです。調査で尋ねたり、一般通念に従ったりすれば、人種差別は南部の問題と見なされます。しかし、南部では人種差別を隠す必要があまりないことが理由かもしれません。より率直なGoogle検索データを見ると、人種差別の度合いが特に高い地域の多くは北部です。ペンシルベニア州西部、オハイオ州東部、ニューヨーク州北部、ミシガン州の工業地帯などです。今日の人種差別をめぐる本当の境目は南部対北部ではなく、東部対西部です。
Knowledge@Wharton:人々や企業がこのデータを、より一貫性のある、より効果的な方法で使えるようになったら、国や社会全体にどのような影響があると思いますか?
スティーブンス=ダビドウィッツ:楽観的なシナリオと悲観的なシナリオがあります。どちらが現実になるかは分かりません。悲観的なシナリオでは、企業がこのデータを使って人々につけ込み、持っていないお金まで使わせたり、必要もないのに自社のウェブサイトに長く滞在させたりします。楽観的なシナリオでは、健康、人種差別、セクシュアリティといった非常に重要な分野について知見が得られ、社会を改善する方法を本当に学べるでしょう。
Knowledge@Wharton:健康に関する側面は非常に興味深いですね。病気の治療法につながる情報を得たり、より効果的な予防策を講じたり、病気が悪化する前に発見したりできるという考えは、この国の人々にとっても、医療をめぐる経済にとっても、計り知れない影響をもたらすでしょう。
スティーブンス=ダビドウィッツ:私のお気に入りの研究の一つでは、検索データを使い、「膵臓がんと診断されたばかり」といった検索をした人々を見つけました。こうした検索をする人は、膵臓がんと診断されたばかりだろうと分かります。次に、その人たちを膵臓がんと診断されたことのない似た人々と比較し、診断前の数か月間にどんな症状を検索していたのかを調べます。すると、将来膵臓がんと診断されることを予測する、非常に微妙なパターンが見つかりました。
たとえば、「消化不良」に続けて「腹痛」を検索することは、膵臓がんのリスク要因です。一方、「消化不良」だけを検索することはリスク要因ではありません。これは非常に微妙なパターンで、膨大なデータセットがなければ見つけにくく、新しい種類の医療を示唆しているようでもあります。
Knowledge@Wharton:あなたが著書で取り上げているGoogleトレンドは、ビッグデータとその理解に革命をもたらしたものの一つかもしれません。
スティーブンス=ダビドウィッツ:そうですね。興味深いことに、Googleトレンドでは、さまざまな語句がどこで検索され、どの地域でより頻繁に検索されるかが分かり、時間の経過とともに検索傾向がどう変わるかも見られます。登場した当初は、ちょっとした冗談のように受け止められていました。学術的な情報源とは見なされず、むしろGoogleの楽しい広報用の情報源という位置づけだったのでしょう。いろいろ試して、どんなファッションや有名人が人気かを知ることができました。しかし、これは冗談ではないと、私たちはますます理解するようになっています。私が言うように、人間の心理についてこれまでに収集された中で、おそらく最も重要なデータセットであり、研究者が注目すべき非常に重要なツールです。
Knowledge@Wharton:それとは対照的に、データを掲げる多くの調査結果は、発表側が示唆するほど正確とは限らないようですね。
スティーブンス=ダビドウィッツ:そうですね。調査には大きな欠陥があると思います。調査を見れば見るほど、懐疑的になります。些細なことでもそうです。最近、自動車を購入する可能性に関する調査データと、実際の購入を比べてみましたが、まったく一致しませんでした。人々は買わない車を買うと言ったり、実際に買う車を買うとは言わなかったりします。ですから、調査は大幅に過大評価されてきたと思います。こうした新しいインターネットのデータソースがより利用しやすくなるにつれて、将来、調査が果たす役割はずっと小さくなるでしょう。
Knowledge@Wharton:そのため、多くの企業が分析を重視し、消費者の考えをより正確に理解するためにデータを見るようになっているのですね?
スティーブンス=ダビドウィッツ:そうです。ただ、慎重さも必要です。どんなデータソースについても、これはどのような情報源なのか、このデータを提供する人々にはどんな動機があるのか、と考えなければなりません。多くの人は数字やデータを見ると、「ああ、信頼できる」と言います。でも、データソースの多くはひどいものです。失礼な言い方ですが。信頼性の低いデータも多くあれば、信頼できるデータも多くあります。しかし、人々が何をクリックし、何を買い、何を検索するかは、考えられる他の多くの情報源より価値があります。
Knowledge@Wharton:政治の話に戻ると、本では、インターネット上にあったデータが、トランプ大統領が共和党予備選だけでなく本選でも勝つことを示唆していたと述べていますね?
スティーブンス=ダビドウィッツ:確かに手がかりはあったと思います。少し難しい問題です。よく受ける質問の一つに、「Google検索で選挙を予測できますか?」というものがあります。少し難しいのは、Google検索データが使えるようになってから、まだ選挙が4回しか行われていないからです。そのため、モデルの予測力を判断するのは容易ではありません。
しかし、4年から8年以内には、このデータを使って選挙を非常に高い精度で予測できるようになると思います。選挙直前に私が気づいていて、トランプが勝つと示唆していた手がかりについては、すでにいくつか話しました。手がかりは二つほどありました。一つは、選挙前に人々が「投票方法」や「投票所の場所」を検索するかどうかから、実際に投票に行くかを見極められることです。調査で投票すると答える人をそのまま信じることはできません。誰もが投票すると言いますが、多くの人は投票しません。ところが、データからはアフリカ系アメリカ人の投票率が過去の選挙より大幅に低くなることが分かりました。これは選挙でヒラリー・クリントンに大きな痛手となりました。
もう一つ、非常に微妙で興味深い手がかりがあります。候補者をどの順番で検索するかから、どちらに投票するかを推測できます。「トランプ/クリントン 世論調査」と検索する人は、トランプに投票する可能性がかなり高くなります。「クリントン/トランプ 世論調査」と検索する人は、クリントンに投票する可能性がかなり高くなります。中西部のいくつかの重要な州では、「トランプ/クリントン 世論調査」の検索がはるかに多くありました。
Knowledge@Wharton:では、検索にクリントンの名前が含まれているだけでも、トランプの名前も含まれているかどうかにかかわらず、何か推測できることがあったのでしょうか?
スティーブンス=ダビドウィッツ:いいえ。検索だけでは、彼女を好きだから検索したのか、嫌いだから検索したのか分からないので、何も明らかになりません。トランプも同じで、好きだから検索することも、嫌いだから検索することもあります。それだけでは何も分かりません。もう少し微妙な手がかりが必要です。ただ、候補者を検索する順番には予測力があります。本人が気づく前に、誰を支持するかが検索に表れている可能性さえあります。自分はまだ決めていないと思っていても、「トランプ/クリントン 討論会」「トランプ/クリントン 世論調査」「トランプ/クリントン 選挙」と検索していれば、トランプに投票する可能性が非常に高いのです。
Knowledge@Wharton:とはいえ、世の中にあるデータ全般について、人々の理解は深まっていると思いますか?こうしたデータを私たちは本当には理解していないという話をよく耳にします。全体像を把握するには、少しずつ進む必要があるのかもしれません。
スティーブンス=ダビドウィッツ:かなり急速に理解が進んでいると思います。もっと多くの人が必要です。インターネット上の行動から人々を理解できるという考えが、当初は非常に奇妙だと思われていたため、学術研究の対象として十分に取り上げられてきませんでした。しかし、研究は確実に増えており、この分野の方法論を専門とする人々も増えています。理解は本当に進んでいます。「これは面白い」という段階はすでに過ぎました。今では、このデータから私たちが何者なのかについて、非常に深い知見が得られています。
Knowledge@Wharton:では、分析を行い、このデータを企業や人々に実質的な効果をもたらすためにどう使うかを理解できる人材は、米国経済の成長分野になるでしょうか?
スティーブンス=ダビドウィッツ:間違いなくそうです。ただ、実際は人々が思うより微妙です。ウォートンの授業でもこの話題がよく出ました。「ビッグデータ」と聞くと、非常に技術的で、統計学が中心の、左脳を使うオタク的な仕事だと思うでしょう。確かに技術分野です。そこは否定しません。しかし、驚くほど創造的なプロセスでもあります。どんな質問をすべきかを知り、データの中から重要な情報をどう見つけるかを知ることが肝心です。それを教えるのは簡単ではありません。時間をかけて身につけ、磨いていく一種の技芸です。だから、データサイエンティストをこの課題に一人投入すれば解決する、というほど単純ではありません。もっと複雑なのです。
Knowledge@Wharton:そう考えると、今後数十年にわたり、データサイエンティストとさまざまな業界との連携が増えそうですね。水へのアクセスや病気との闘いなど、世界の大きな問題に取り組むため、データを活用して全体像を把握しようとするのでしょう。
スティーブンス=ダビドウィッツ:心躍る話です。可能性は本当に想像を超えるほど大きく、幅広い分野に及びます。この新しいデータが存在し、しかも率直なものだからこそ、大きな問いに取り組み、大胆な目標を掲げるのが理にかなっています。ビッグデータで小さな問いに取り組むのは、あまり意味がありません。
Knowledge@Wharton:人々が自分自身をもっと理解できるようになる可能性はどうでしょうか。このデータが他の人々や企業に及ぼす影響についてはよく話題になりますが、将来、人々は自分自身をよりよく理解できるようになるでしょうか?
スティーブンス=ダビドウィッツ:そう思います。データはしばしば、私たち自身よりも私たちのことをよく理解しています。たとえばNetflixは、創業初期に人々にこう尋ねていました。「今見ている動画は分かっていますが、これから数日間は何を見るつもりですか?週末に見たいものを、週末になったらすぐ見られるように用意しておきます」。尋ねられると、人々は「ドキュメンタリーを見る」「フランスの前衛映画を見る」と答えます。ところが金曜日になって、それが視聴リストに入っていても無視し、いつも見ているような低俗なコメディーや恋愛映画を見ます。Netflixは、人々の言葉を鵜呑みにするのではなく、実際の行動に注目し、アルゴリズムに実態を語らせるべきだと気づきました。
私たちは、将来の自分の行動についてひどく見当違いな予測をしがちです。ほとんど誰もが楽観的すぎます。データは、私たちを現実によりしっかりと引き戻してくれると思います。
Knowledge@Wharton:このデータによって、米国が中国やフランス、ドイツなどとどう違うのかも、より明確に理解できるかもしれません。ビジネスや政治など、さまざまな分野で世界的な視点から考えるときに影響します。
スティーブンス=ダビドウィッツ:間違いありません。このデータから明らかになる国ごとの差を比べるのは、本当に興味深いことです。また、ビジネスの観点から言えば、いくつかの国ではデータの質がひどく悪いのです。アフリカ最大の経済大国だと思いますが、ナイジェリアではGDPの推計に欠陥があると分かり、一晩で推計値を90%変更したことがありました。こうした国の従来のデータは、本当にひどいものです。登場しつつある新しいデータソースの中には、そうした国々への理解を大幅に深めてくれるものがあります。
夜間光データについても取り上げています。これは、どれだけの光が生み出されているかだけを基に経済を測ることができます。また、Premiseという企業についても述べています。同社は発展途上国を回って経済活動の写真を撮り、その画像からインフレ率や金利など、さまざまな数値を推計できます。
Knowledge@Wharton:これらのさまざまな要素がもたらす変化の可能性は計り知れません。世界各地の経済で成長を促したり、落とし穴を避けたりするために、より優れた予測手段を与えてくれそうです。
スティーブンス=ダビドウィッツ:そうですね。私はとても皮肉屋で懐疑的な人間だと思います。だから「ビッグデータ」という言葉や流行語を聞くと、「うんざりだ。こんなのはくだらない。最新の流行にすぎない」と思ってしまいます。でも、この分野を5年間研究し、現場の人たちと話してきました。そして、そこから分かることに何度も驚かされています。これは一過性の流行ではありません。人々と世界に対する理解を本当に変える革命です。
Knowledge@Wharton:ご自身を皮肉屋だとおっしゃいますが、人生をデータに捧げています。そして、本当にデータこそが真実なのですね?
スティーブンス=ダビドウィッツ:そうです。ある意味では、人々の言葉を信じてはいけないという私の懐疑心や皮肉な見方が裏付けられています。従来のデータソースの多くでは、データを提供する人々に何らかの動機があります。しかし、適切なデータに目を向ければ何が学べるかについて、私はまったく悲観していません。
Knowledge@Wharton:今では日々、このデータに深く関わっているのですね。つまり、今は対象が際限なく広がる分野で、何かに影響を与えたいと思えば、あらゆることについてデータがあります。文字どおり、企業を次々と訪ね、毎日データを集めることもできるのでしょうか?
スティーブンス=ダビドウィッツ:そうですね。ウォートンの授業の最後に、グループ発表を行いました。私は非常に幅広いテーマを与え、「教育分野で新しい事業を考えるか、健康分野で新しい事業を考えるか、政治分野で新しい事業を考えてください。そして、新しいデータやビッグデータのツールを使えば、その事業にどんな利点があるかを考えてください」と言いました。どの発表の終わりにも、学生たちはみな「なぜこれが存在しないのですか?おかしいですよね。これはあるべきです」と言いました。新しいものを考え出すのは、たいてい難しいことです。賢い人々が、存在すべきものや人々が求めるものを見つけようと、一生をかけて取り組んできたからです。しかし、ビッグデータがあれば、本当に大きな分野で、新しく重要なアイデアを考え出すのは驚くほど簡単だと思います。
Knowledge@Wharton:では、未来に期待しているのですね。社会に出ていく次世代の学生たちと一緒に働いています。彼らはこうしたデータポイントの重要性を理解し、これからもデータを築き、発展させていくでしょう。
スティーブンス=ダビドウィッツ:本当にわくわくします。確かに、唯一の懸念は倫理上の問題です。企業は強大になりすぎて、消費者について本人たち以上に知ることで、消費者から価値のすべてを搾り取れるようになるかもしれません。これは私が抱える大きな懸念です。
Knowledge@Wharton:それをどう防ぐのですか?
スティーブンス=ダビドウィッツ:大変な作業が必要になります。法律や倫理の分野にいる人の大半は、ビッグデータがこうした分野の一部でどれほど革命的なものか、まだ十分に理解できていないと思います。基本的に、私が考えるのは、あらゆるものが相関しているということです。あらゆるもの。相関が0.000というものはほとんどありません。つまり、あなたがすることはほぼ何でも、あなたが別にする何かを予測する手がかりになります。従来、企業がこうした予測に使える変数は3つか4つか5つにすぎませんでした。しかし今では、誰もがこれまでにしたことのほぼすべてを、予測に利用できます。これは非常に強力なものです。




