このトランスクリプトは音声認識ソフトウェアを使用して生成されたものであり、誤りが含まれている可能性があります。音声と照らし合わせて正確性をご確認ください。
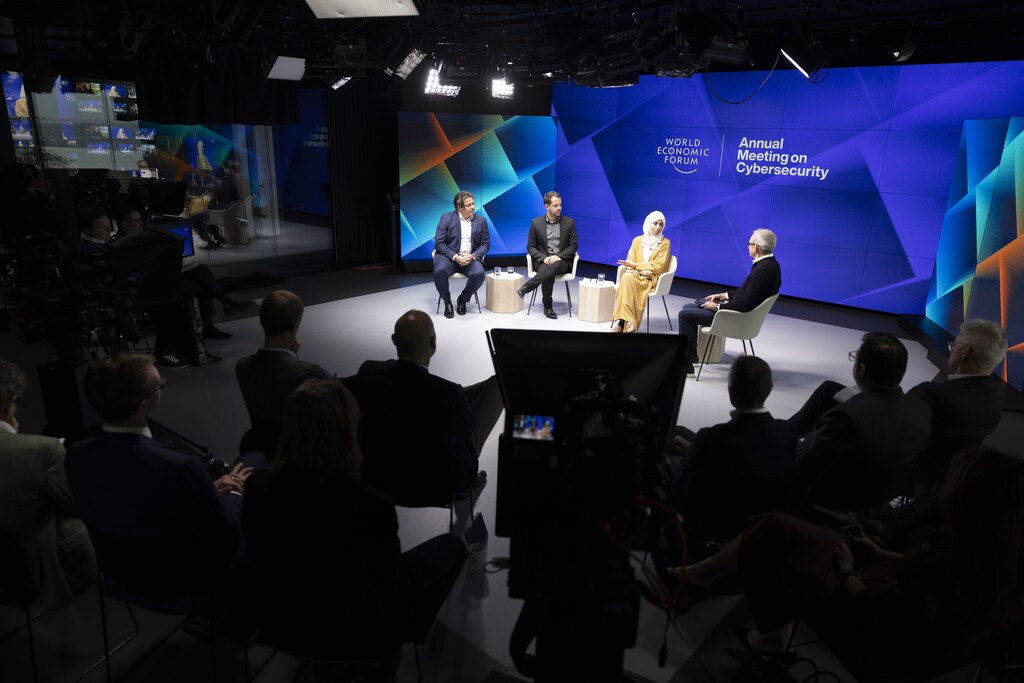
Grant Waterfall: おはようございます。本セッション「デジタルマインドの防御:AIエージェントが直面する新たな課題」へようこそ。
数週間前、私はベルリンにおり、Microsoftの AI ツアーに参加しました。そこでは Satya Nadella が登壇し、エージェント、自動化エージェント、パーソナライズされたエージェントがもたらす新たで変革的な世界について語りました。また、Copilot Studio を使えば、誰もがエージェントを作成でき、その技術は民主化されうるという話もありました。
これは今回のカンファレンス全体における大きなテーマでした。彼はまた、30年前、あるいは現在においても、組織内には何千、何万というスプレッドシートが存在し、ある意味で、エージェントがかつてスプレッドシートが担っていた役割を引き継ぐことになるだろうという例えを挙げました。
私はこれを素晴らしい例えだと思いました。なぜなら、それは、AIエージェントやパーソナライズされたエージェント、自動化の活用が、最終的にはエンドユーザーの文脈で民主化され、その結果、私たちにとって大規模な変革をもたらすことを示しているからです。
しかし同時に、私たちは皆、組織内に何千ものスプレッドシートがあることが、どれほど混乱を招くものであったかを覚えており、それらを排除し、より管理されたシステムに移行させるために何年も費やしてきました。
したがって、私は、これによって、機会と同時に、我々に解き放たれようとしているこの新しい世界をどのように管理するかという、多くのリスクの世界が開かれると考えています。
そして、先ほど話したように、エージェント型の世界は、私の予測では、かなり主流になるものだと思います。そのため、まもなく誰もが AI エージェントについて語るようになるでしょう。現時点では、それはおそらく誇大宣伝の領域であり、人々が熱狂しているのは、どちらかといえばテック分野でしょう。
ですから、一年か二年のうちに、Microsoft やその他のハイパースケーラーを含め、誰もがこの用語を民主化すると私は考えています。もちろん、これを行っているのは Microsoft だけではありません。大手テック企業はすべて、そして他の多くの小規模なテック企業も同様に行っています。本日は、そのうちの数社がここに来ており、コメントしていただけます。
本日は、このアジェンダの二つの側面を掘り下げていきます。第一に、エージェントの組織的な導入についてです。すでにその背景について少しお伝えしていますが、組織が多数のエージェントを導入し、多くの業務やパーソナルエージェントを自動化していく中で、より広い意味で何を意味するのか、そしてセキュリティ上の意味や、それをより適切に保護するにはどうすればよいかについてです。
次に、攻撃側の側面にも触れます。つまり、悪意ある攻撃者がエージェントを使い、攻撃的な文脈において AI エージェントを非常に容易に作成できるようになることについてです。それでは、パネリストを手短にご紹介します。
本日は非常に素晴らしいパネルをご用意しています。まず、ニューヨーク大学アブダビ校サイバーセキュリティセンターのディレクターである Hoda Al Khzaimi をご紹介します。ようこそ、Hoda。
Matan Getz は、Aim Security の最高経営責任者です。Aim は革新的なスタートアップ企業であり、組織内での AI の利用を保護することに取り組んでいます。そして Nic Chavez は、AI データプラットフォーム企業である DataStax の最高情報セキュリティ責任者(CISO)です。
このグループには非常に豊富な経験があることにご同意いただけると思います。皆さん全員に対して最初の質問から始めたいと思います。それは、皆さんそれぞれの立場から、AI エージェントは何を意味するのか、そして企業が AI エージェントの導入にあたって検討すべき影響や考慮事項は何か、ということです。では、Hoda からお願いします。
Hoda Al Khzaimi: AI エージェントは、この分野において特に新しいものではないと思います。皆さん自身を見てください。Siri や Amazon Echo、この種のデバイスを最後に使ったのはいつでしょうか、あるいは初めて使ったのはいつでしょうか。これらはパーソナライズされたアシスタントと見なされています。それもまた、AI エージェントのモデルの一つです。
自動運転車システムについて最後に聞いたのはいつでしょうか。自動運転の体験を実現したいと考えることも、結局はAIエージェントのモデルです。
したがって、AI エージェントの究極の能力とは、現時点ではソフトウェアの一部であることによって非常に制限されていると思いますが、将来的には、組織全体の大規模データ構造を分析し、人間の介在なしに自動的な意思決定を行うことができる、ソフトウェアとハードウェアの能力になるでしょう。
また、現時点では、環境上の膨大なデータセットを分析し学習することに伴う強化学習や多くの機械学習の側面を多用しているため、非常に本質的で重要な体験でもあります。
したがって、それらのモデルの精度は非常に重要です。本日の聴衆の中に、製造拠点で作業されている方が何人いるかは分かりませんが、工場周辺の構造を自動化する、この種の自動操縦システムを製造拠点で利用している方もいるでしょう。これもまた、AI エージェントの非常に良い例です。
Grant Waterfall: 他にも例をお願いします。ありがとうございます。それでは、まず Matan からお願いします。
Matan Getz: 本日はお話しする機会をいただき、ありがとうございます。私にとっては、非常にシンプルに言えば、AI エージェントとは、あなたに代わって動作するアプリケーションに過ぎません。Hoda が言ったことと同様に、Alexa や Siri は、ずっと前から存在していました。そして、変化はまさにあなたが述べたとおりです。私は、今や自分自身の AI エージェントを非常に容易に作成できるようになったことが変化だと考えています。
データサイエンティストである必要はありません。ソフトウェアエンジニアである必要もありません。すでにある様々なツールを使えば、いくつかの UI を操作するか、自然言語による説明や指示を与えるだけで、自分専用のエージェントを持つことができます。
ですから、変化とはあなたが説明した民主化です。そして、誰もが非常に多くの AI エージェントを作成できるようになった今、まさにここから、あらゆるセキュリティ上の懸念が生じているのです。なぜなら、かつて Alexa や Siri のようなものは大手企業によって所有されていたと私は考えているからです。しかし、今はもうそうではありません。今では、誰もがそれを行える能力を与えられています。ですので。
Grant Waterfall: 自分たちで作成できるということですね。素晴らしい。ありがとうございます、Matan。Nic、どうぞ。
Nic Chavez: おっしゃる通りで、AI エージェントの作成は非常に簡単です。それを行うために、当社では Langflow と呼ばれるものを使用しています。そして、AI データプラットフォーム企業の CISO という立場から、私はしばしば他の CISO と会い、それがどのようなものかを理解してもらう手助けをしています。
そこで、私が最も頻繁に説明するのは次のようなものです。最も価値のある従業員、あるいは一緒に働くのが特に楽しい同僚を想像してみてください。それが AI エージェントなのです。
そして実際、エージェントが得意とすることは三つのカテゴリーに分けられます。一つ目は、自律的であるということです。最初の指示を与えた後は、あなたからのわずかな入力だけで、自ら動いてくれます。二つ目は、適応性があるということです。あなたが何をすべきかを伝えると、それをどのように実行するかを考えようとします。もしできなければ、別の方法を試みます。
そして三つ目は、非常に目標志向であるということです。あなたがやりたいことや、どのように行うべきだと考えるかの説明を与えた後は、その目標を達成するまで実行し続けます。
さて、同僚は一人の人間として考えますよね。もし同じ同僚が十人いたらどうでしょうか。百人いたら?千人、あるいは百万人いたらどうでしょうか。そして、私たちの人間の脳に配慮して、千人の同僚がいて、あなたの言う通りのことを常に行い、目標を達成するまで続け、その後は別の作業に配置できると考えてみましょう。
これがエージェント型 AI であり、あなたが指示したものは何でも、そのベクトルデータベースストアとそれを動かす LLM とともに、あなたの目標を達成することになるのです。
Grant Waterfall: つまり、そこには大きな機会があるということですね。
Matan Getz: 実際、Nic の素晴らしい例えを活用させていただきたいと思います。人間とエージェントの間のこの類似性が大好きです。これこそが究極の目標だからです。
ただ、人間に対して抱いている期待について考えてみてください。たとえば、礼儀正しく振る舞うことを期待しますよね。期待される通りに、正しく振る舞うことを期待します。時には、私たちが知らないこともあります。だから、全員が時間通りにここに来ることを期待しますよね。特定の服装をすること、特定の話し方をすることも期待します。
機械に対しては、これらの期待はすべて実際に記述される必要があります。そして、これこそがみんなが話している、いわゆるガードレールなのかもしれません。そして、それがあなたが示唆した機会における複雑な部分なのです。
Nic Chavez: ええ、その点には同意します。IT の専門家や事業のステークホルダーとして、本当に考えなければならないのは、目標は何か、そして、大規模言語モデルプロバイダーなどによって何らかの信頼と安全性が組み込まれているクラウドを活用できるか、ということだと思います。
あるいは、ベクトル化されたすべての情報を格納するためのベクトルデータベースと組み合わせた、AI エージェントを備えたオンプレミスの、ほぼ小規模言語モデルを採用する必要があるのか、ということです。
そうすることで、クラウドベースの環境とは大きく異なるかもしれない、自社独自の信頼と安全性のガイドラインを用いて展開することができます。
Grant Waterfall: これで、組織内での AI エージェントの導入という道筋に入り始めました。Matan、まずはあなたからお聞きしましょう。誰もが AI エージェントを作成できるという、この能力に関連して存在するリスクについて、もう少し掘り下げてみましょう。そして、それが組織にとって何を意味しうるかについてです。
あなたの会社はこうした課題の解決に強く取り組んでいると承知しています。では、どのようなリスクがあると考えていますか。
Matan Getz: ええ。まず、リスクについて説明する前に申し上げたいのは、各社がそれぞれ独自の方針を定め、それを決めている段階は初期段階だということです。残念ながら、多くの企業は、ChatGPT が世に出たときと同じような対応をしています。つまり、可否の方針を決めているのです。それは誤ったやり方だと思います。
通常、企業が行うのは、ChatGPT や AI エージェントの利用をブロックし、その後、制約を導入することです。実際には、ビジネス上の価値を制限してしまい、それが正しい、あるいは素晴らしい価値を生むものであるにもかかわらずです。そして、利用を認める場合には、たいてい単に「許可する」と言い、必要とされる誰もが何でもできる、完全に開かれた遊び場のような状態にしてしまうことが多いのです。
AI エージェントには、ここに二つ、あるいは三つのリスクがあると考えています。第一に、その行動能力、つまり自律的な部分です。例えば、金融取引を実行したり、人間の確認を必要とせずにあなたに代わって意思決定を行う能力がある場合、それはリスクになります。これが第一の点です。
第二に、AI エージェントは、設計された目的を果たす際には非常に優れています。しかし、意図的か意図せずかにかかわらず、それらを操作し始めると、時に小さなデータのドリフトが生じ、望んだ通りに振る舞わなくなることがあります。
そして、ここで攻撃者はまさにこの予測不可能性を利用することがあります。あるいは、従業員がそれを行うこともありますし、人々が意図せずに行うこともあります。したがって、これが第二の点だと考えています。
そして第三の点です。これは主に、AI エージェントを採用する組織に関わるものです。それは、機密データに接続されたり、機密データで学習されたりすると、非常に効果的になります。しかし、AI が機密データに触れる場合、ここは非常に慎重になる必要がある領域です。攻撃や情報漏えいを防ぐために、適切な保護が導入されていることを確実にしなければならないからです。したがって、これが第三の点になります。
Grant Waterfall: なるほど。では理論上は、これらのエージェントを管理された状態で展開することによって、組織の攻撃対象領域を増やしている可能性があるということですね。
Matan Getz: まさにその通りです。
Hoda Al Khzaimi: はい。そして、Matan のご指摘に関連して申し上げると、ここにあるのは、プラットフォーム内でこれらのエージェントを適用することの有効性を理解しようとするジレンマだと思います。なぜなら、業務の効率化のためにシステム内の自律的な意思決定の構造を改善しようとする一方で、同時に脅威要素も導入しているからです。
システムに対する大規模な監視と分析の能力も、場合によっては導入していることになります。そして、どれほど無制限の構造で適用していたとしても、悪意ある攻撃者が AI エージェントの設定構造に侵入し、この敵対的生成ネットワークの構造を適用する可能性があるかどうかはわかりません。そこでは、敵対的モデルがエージェントにダウンロードされ、システムに対して改変や攻撃を行うために使われるかもしれません。
したがって、このような意図的な攻撃の空間は、どのような形であれ存在します。同時に、あなたは AI エージェントと構造の融合について議論されました。また、エージェントは厳密には LLM とだけ連携して動作するわけではなく、自動化構造として異なる機械学習の構造の一つと連携します。しかし、このような脆弱な空間を持つ能力があるのです。
LLM は、信頼性のための完全な空間ではなく、また、完全な空間を持っているわけでもありません。なぜなら、LLM は誤検知や見逃しに対して非常に弱いからです。では、自社の自動化された製造拠点の内部で、重大な意思決定の側面を導入するとしたら、何が起こるでしょうか。そして、わずかな改変が、組織全体に誤検知や見逃しを引き起こすかもしれません。
したがって、問題を解決するどころか、組織内に同様の現象を大規模に持ち込んでしまうことになり、単一の視点からそのような大規模な障害に対処することが非常に重要です。
ここで強調すべき二つ目のリスクは、AI エージェントのようなものは、インフラ上に特定のレベルのプライバシー保護の仕組みを適用する必要があるという事実です。これらのプライバシー保護の仕組みのほとんどは、大規模に使用されることを想定して設計されてはおらず、IoT センサーネットワークで使用されることも想定されていません。しかし、これらのエージェントの多くは IoT センサーネットワークと連携して動作します。
たとえば、フェデレーテッドラーニング、準同型暗号、差分プライバシーといった手法について話しています。これらは限定的な構造においてはうまく機能しますが、大規模に適用しようとすると、速度や複雑性の分析の面で問題が生じると思います。
では、それらにどう対処するのでしょうか。より広範な物事の全体像の中で、プライバシーやその他の側面を維持するために、環境にどのような新しいプロトコルを導入する必要があるのでしょうか。
Grant Waterfall: そこには多くのことが含まれていますね。
Matan Getz: 私が多くの企業に見られる非常によくある誤りを一つ挙げることができます。通常、起こるのは、AI エージェントの作成者が、それらのエージェントにこうしたすべての権限を与えることができるという方針が存在することです。
しかし、それが正しい方針かどうかはわかりません。人間が介在しているときには、機密データにアクセスできるかもしれません。しかし、それが自律的に動作し、大規模に実行されている場合、同じ権限を AI エージェントが引き継ぐべきかどうかはわかりません。それは同じ人物によって作成されたものです。非常にシンプルで、非常によくあるユースケースだとは分かっていますが。
Grant Waterfall: ええ、それは興味深い考え方ですね。一般的には、人間の権限が引き継がれると考えるでしょうが、よく考えてみると、それは別の種類の処理なのです。
Nic、あなたはこの種の問題について顧客に助言していますね。では、AI エージェントに関するリスクの観点から、どのような質問を受けていますか。
Nic Chavez: 最も多く受ける質問は、AI エージェント内で、いいですか、これはドラッグアンドドロップで操作でき、当社の製品では見たままが得られるため、「私のデータは安全ですか」というものです。保存時にも、転送中にも、データは安全なままですか。
つまり、API は安全ですか。それらはどのように保護されていますか。これは重要な質問です。表面的にはとても単純ですが、もう少し深く掘り下げると、データポイズニングは現実の問題です。あなた方お二人が言及していたのは、おそらくそのことだと思います。そして、それは何らかの悪意ある攻撃者の存在を意味します。
しかし、エージェントがどのように学習するよう設定されているかによっては、もう一つ、露出しうるリスクがあります。それは、エージェントが自己参照的である場合、情報を生成する際に幻覚を起こす可能性があるということです。
すると、不完全なデータセットが生まれ、完全な情報と不完全な情報を結びつけるベクトルをデータベース内に作成してしまうことになります。そして、それを体系化し、場合によっては拡大していくことになります。ですから、私たちは常に「悪いプロセスを拡大してはならない」と言っていますが、そうなってしまうことは十分にありえます。
Matan Getz: ええ、そうですね。
Hoda Al Khzaimi: もし、あなたを取り巻くシステム全体が、重要データや重要インフラのパフォーマンスに関わることを何か言うとしたら、想像してみてください。ですから、そのような状況においては制限が必要であり、AI エージェントの適用も限定的であるべきだと思います。しかし、どうすればそれを確実にできるでしょうか。
会話の冒頭で、あなたが言及していたと思いますが、それらの AI エージェントは単に機能のためだけにあるのではなく、人間と相互に関わり合うためにも存在していると思います。
したがって、人間と相互に関わるのであれば、運用のもう一つの側面、つまり、その場にいる人間の知性、その場にある感情的知性を理解すること、人々の幸福に注意を払うこと、そして他のすべての側面、全体にわたる倫理的配慮を取り入れる必要があります。特に、大規模に医療データのようなものに使われる場合にはなおさらです。
Matan Getz: 非常に実践的に言えば、私は、もし AI エージェントについてそれらの特性を本当に理解し定義できれば、特性をいくつか提案したいと考えています。ただ、それで安全になるとは思いません。しかし、あなたは正しい道を歩んでいます。安全性を確保するために申し上げたいのは、ほとんどの企業が苦労していると私が見ている最初の点は、AI エージェントの目的です。
AI エージェントは価値を生み出す必要があり、その価値は非常に具体的で明確に定義されている必要があります。例を挙げましょう。たとえば、オンラインショッピングのアシスタントです。服を買うという意味ですか、それとも化学薬品も含むのですか。AI エージェントの目的が非常に狭く、非常に具体的であるとき、それは同様にソフトウェアのようなものだと思います。
私たちは、非常に具体的なコンポーネントで構築され、マイクロサービスを用いて作られるソフトウェアを構築したいと考えています。AI エージェントも同様です。エージェントは可能な限り具体的であることが望ましいのです。したがって、目的が最初の要素です。
二つ目は説明責任です。説明責任は作成の日に終わるのではなく、むしろ逆に、作成の日に始まるのです。三つ目は、発見可能性です。すべてが監査可能である必要があります。そして四つ目は、私たちが皆話している部分だと思いますが、信頼できるものである必要があるということです。これについては、きっと議論することになると思います。
Grant Waterfall: 申し訳ありません、もう一度おっしゃっていただけますか。
Matan Getz: 信頼できるものです。
Grant Waterfall: 分かりました。それは非常に良いアドバイスですね。では、この点は一旦保留しておき、AI エージェントをサイバーセキュリティで使用することについて詳しく話す際に、この管理面に少し戻りましょう。その前に、Nic の見解を伺いたいと思います。
ここでの攻撃側の視点について、Nic、どう考えますか。
同じ技術を使う攻撃者の視点から見ると、あなたが言うように、今やドラッグアンドドロップやクリックで操作する仕組みが普及し、反対側でも民主化されていきます。では、これがどのように進化し、組織への脅威になるのか、どのように予測していますか。
Nic Chavez: 予測と言うと、少し強すぎる言葉かもしれません。なぜなら、そうなってほしくないからです。
Grant Waterfall: そうですね。
Nic Chavez: はい。ドラッグアンドドロップですね。昔のスクリプトキディでさえ、組織を攻撃するには、Linux や Bash の知識が少しは必要でした。ここで、自律的で適応性があり、目標志向の、勤勉で頼りになる同僚や従業員の例に戻りましょう。
私たちは皆、そうした資質を望んでいます。しかし、私たちが望まないのは、ドラッグアンドドロップで、関連するベクトル、例えば特定のデータセットをベクトルデータベースに投入し、そのエージェント型 AI を一回、十回、百回、千回、あるいは百万回と展開できるほど有能なハッカーです。
すると、突然、非常に知的で、自己参照的で、非常に適応性の高い、基本的には DDoS ツールのようなものが出来上がります。ファイアウォールに24時間攻撃し続け、決して休まず眠りもしません。そして、などなど。
いったん侵入すると、横方向への移動を行うことができます。なぜなら、そのように訓練されているからです。キーボードとインターフェースを使って人間にさせられることなら何でも、AI エージェントにもさせることができるのです。
さて、もしそのような存在が百万体もあなたに向かって常に押し寄せてきたらどうでしょうか。その導入コストは非常に低く、参入障壁も非常に低いのです。ですから、国家が何百万もの潜在的な攻撃者を支配することになるだけでなく、通り向こうの誰かが同じことをしている可能性もあります。
したがって、私たち業界全体として、そうなる前に、より優れた識別手段とより優れたツールを考え出し、それに対処する必要があります。なぜなら、それが起きたときには、消火するのが非常に困難な大火事になるからです。
Grant Waterfall: 分かりました。このテーマについて、他に何かご意見はありますか。
Hoda Al Khzaimi: 私は、大規模な分析と自動化を同時に行うあらゆる種類の技術について話すときには、信頼性の高い設計を重視し、安全で回復力のある設計を重視するという、設計ガイドラインを定めるべきだと思います。
つまり、人間が途中に介在しないため、大量分析や自動化された意思決定の中で悪意ある意図を捉えることができません。
今ご説明いただいた内容に関連してお話しすると、ニック、私は、AIエージェントに最初の段階から、そうした自己規制的な回復力を組み込むことが非常に重要だと考えています。AIエージェントが悪意ある目的で改変されようとしていることを検知し、直ちにその動きを止め、システムに対する何らかの攻撃が起きた場合には、自己進化または自己修復できるようにするのです。
それこそが、機能上のエラーであれ、人間による意図的な悪意ある行為であれ、システムに持ち込まれるあらゆる種類のリスクを停止し、抑制するために欠けている要素だと思います。
したがって、私たちが今日の自動化システムやAIに関連する大量技術の設計において欠けているのは、それらの技術を本質的に、設計段階から、責任ある回復力のあるものとし、そうした機能について自ら規制するよう、どうすれば確実にできるかということです。
興味深いことに、私たちは機能のために自動化したいと考えていますが、セキュリティのためにも自動化すべきなのです。それこそが目的です。安全で回復力があり、周辺の脅威マップを検知できるように自動化すべきなのです。
ニック・チャベス: それは素晴らしい指摘だと思います。実は私はもう白髪が多くなってきていて、数多くのERP導入を経験してきた世代です。
ERPの導入を設計する際には、まずセキュリティを優先し、設計段階からセキュリティを組み込む。それは正しいことです。ただ、AIエージェントの厄介な点は、非常に簡単に立ち上げられることです。極端に言えば、何かを作り、その後2分ほどで、それに対抗するAIエージェントを立ち上げることさえできてしまいます。
ですから、そのような仕組みが軽率に、あるいは安易に利用されないようにするために、私たちが合意すべき一定の体系的な枠組みが必要です。AIエージェントを作成する一人ひとりが、そうした対策を正しく行うための専門知識を備えているわけではないのですから。
したがって、それらは体系的に実装されなければならず、そのことは私たち全員、そして産業界が、規制当局や標準化団体と協調して決める必要があります。
マタン・ゲッツ: 緊急性だけでなく、ここにある機会についても強調したいと思います。そして、先ほどお二人がおっしゃったことに関連して、私の考えでは、セキュリティ部門は以前は非常に積極的でした。
あなたの質問のように、通常起きていたのは、私がセキュリティ責任者たちが、「AIエージェントからどのような価値が得られるかを見てみよう」と待っている姿を目にしてきたことです。「まずAIエージェントの導入状況を理解し、その後に優先順位リストに入れるかどうかを決めよう」というわけです。優先順位付けが常に問題であり、リスクはどこにでも存在するからです。
ですから、AIエージェントのための保護やセキュリティのガイドラインおよびポリシーに取り組み始めるのが適切な時期なのかどうか、私には分かりません。導入がどの程度進んでいるのか分からないからです。しかし、私たちは逆の視点で考えるべきだと思います。
これは、セキュリティリーダーが受け身ではなく、先を見据えて行動する機会です。まずガイドラインを定め、まず適切な設計を確立し、その後に初めて導入の先導役の一人になり、AIエージェントの活用事例を示すべきなのです。
そして私は、これは誤りであり、多くの場合に私が目にしている失敗です。AI全般、とりわけAIエージェントについては、ここに新たな機会があるのです。
ホダ・アル・クザイミ: ええ。そして、マタンのご指摘に関連して言えば、私たちは技術を、できるだけ早く、実際の環境や状況の中で設計し、リリースする傾向があると思います。ここで私たちが必要としているのは、AIエージェントを自由に設計できるインキュベーションのプロセス、またはサンドボックスの仕組みです。
同時に、そうした環境の中ではリスクが十分に抑え込まれていなければなりません。そして、その後に、規模を拡大するか、縮小するか、あるいは全く使用しないかを決めることができます。プラットフォームに特定の、いわば増幅されたリスクをもたらすのであれば、なおさらです。
グラント・ウォーターフォール: 興味深いことに、あなたがERPの例を挙げられましたが、私も長年この分野に携わってきました。結局のところ、管理され安全なシステムを確保する責任は、部分的にはソフトウェアプロバイダーにあります。
しかし実際には、企業側でそれを実際に構成し、導入し、その周りに監視と統制を整備するために、大きな労力が注がれていました。
ですから、これは共同の責任になると思います。そして、マタン、あなたの指摘のように、セキュリティの観点がこの問題で、被害を受ける前に先手を打つ必要があるというのは重要です。私はERPについて、何も問題は起きないという数多くの保証があったことを覚えていますが、実際には問題が起きてしまいました。そうですよね。ですから、良いことです。では、次に進みましょう。防御の側面に少し触れたいと思います。
つまり、AIエージェントがどのようにして企業をより安全にするために活用され得るか、ということです。これは検知と対応、そして対応の自動化にも関わります。もし私たちがそれらを活用し始めれば、そこには明らかに大きな機会があります。
また、自動化と統制の間にはいくつかのリスクもあり、その一部はすでにお話しいただいています。どなたから始めていただいても結構ですが、これをサイバーセキュリティでどのように活用できるでしょうか?
ニック・チャベス: 私の最初のコンピュータには鍵がかかっていて、電源を入れることができませんでした。そして、それは「ほら、誰もこれを突破できないだろう?」というような仕組みでした。ですから、どの産業であれ進歩するにつれて、攻撃と防御の巧妙さはより高度になっていきます。
そして今、CISOとして私たちが考えなければならないのは、ネットワークトラフィックの異常検知を行っているということです。これらのエージェント型AIは、攻撃対象となるシステム内の既存のネットワークトラフィックに似たトラフィックを生成し、シミュレートするようプログラムされ得るのです。
つまり、私たち防御側は、ネットワークに侵入するために既存のネットワークトラフィックをシミュレートしているAIエージェントを検知するために、AIエージェントを構築しなければならないのです。
そのことがいかに入り組んでいるか、そしてこうしたAIエージェントを開発する人々に必要となる専門性の水準を考えると、AIエージェントが持つ力の大きさと、エージェント型の防御をエージェント型の攻撃に対して開発する人物や人々に対して、どれほどの信頼を寄せる必要があるかが分かってくるのです。
グラント・ウォーターフォール: なるほど。それは多くの新しいスキルと、考え方の転換が必要だということですね。ホダ、いかがでしょうか?
ホダ・アル・クザイミ: また、AIエージェント内での情報の喪失や、情報の断片化についても注意すべきです。というのも、多くの場合、それらは一部のシナリオで分散型の方式で動作し、異常を分析して検知できるからです。サイバーセキュリティではそのように取り組んでいますよね?
攻撃の範囲がもたらす影響の痕跡が必要であり、それらを分析しなければなりません。しかし、もしそれらが同時に、規模を拡大し、次の攻撃サイクルを予測し、場合によってはその次の攻撃サイクルを模倣する能力も持ってしまったらどうなるでしょうか?
それもまた、単なる防御レイヤーのアプローチとみなされるのでしょうか、それとも、ネットワーク内で攻撃と防御を同時に行うという、異なる次元の複雑さをもたらすのでしょうか?
そして、それらのリソースの計算能力は議論すべき事柄です。通常の状況では、エッジコンピューティングデバイスには特定の制約があるからです。そして、多くの場合、特定の時点ですべてをクラウド上で実行することはできないと想定されます。
ですから、エッジセンサーやエッジコンピューティングデバイスにそれらを送り、デバイス上で計算し、デバイス上で学習させる必要があるでしょう。しかし、私たちのデバイスのうちどれだけが、そうした構造を広範囲に大規模監視し、より広い範囲で異常検知を行う能力を持っているでしょうか?
ですから、私の懸念は、現在私たちが持っている防御のシナリオを超えて規模を拡大する能力にあります。
グラント・ウォーターフォール: ああ。なるほど。
マタン・ゲッツ: あなたの質問に関連して言えば、私たちはサイバーセキュリティに有利なAIエージェントの利点について、すでに素晴らしい事例を数多く目にしています。2週間前、Googleのプロジェクト・ゼロは、初めてAIエージェントがゼロデイ脆弱性を発見したと発表しました。
これは素晴らしい事例であり、私はこれが、サイバーセキュリティを支え、その役割を担うAIエージェントの新たな導入の波の始まりに過ぎないと考えています。
グラント・ウォーターフォール: そこには大きな機会があります。あと約10分ありますので、ここで一度区切って、会場の皆さんから質問がないか伺いたいと思います。皆さんがAIエージェントの話にすっかり困惑されていなければ良いのですが。私には質問はありません。ただ、質問があるようです。実は2件あります。
会場からの質問者1: こんにちは、キャリー=アンと申します。お伺いしたいのは、AIの利用と、それらが互いに学習し合い、さらには互いに学習することで攻撃を仕掛け合う可能性について、今までの議論を踏まえてのことです。
箱の中の猫はすでに外に出てしまっている、つまり、規制やフレームワークについて話している一方で、技術はすでに利用されており、フレームワークに組み込まれるのは、他のサイバーツールと同様に、責任ある倫理的な利用だけになってしまう、そのような世界をお考えでしょうか。
例えば、ウェブの中にある企業が、技術を責任を持って使用することを拒む私たちに対抗する防御側として登場するような世界を想定されていますか?
皆さんのお話を聞いていると、私たちはまさにその地点に向かっているように思えます。人々が、皆さんがおっしゃったように、悪いAIを止めるために、別のAIを見つけるようAIを訓練するという状況に置かれるのでしょう。はい。
ですから、私が伺いたいのは、「最初に市場に出ることが重要だが、今度は市場を守らなければならない」というビジネスモデルを超えなければならない地点に至る世界を想定されているかどうか、ということです。
グラント・ウォーターフォール: 良い質問です。ええ、マタン、それからどうぞ。
マタン・ゲッツ: まず最初に言いたいのは、善は常に勝つ、善の側は常に勝利している、ということです。はい。ですから、私は恐怖をあおるのは好みません。はい。
グラント・ウォーターフォール: 箱の中の猫はまだ外に出ていないということですね。
マタン・ゲッツ: はい。そうです。ですから、私たちは善の側にいます。私は、外部規制や、この種の実践が遅れていると考えています。安全なAIの革新や導入を主導しているのが、企業が自ら行っていることであるのは驚きです。企業は自己ガバナンスを持ち、自己規制を持ち、自らのポリシーを支えています。さて、こうしたポリシーを定義するのは容易でしょうか?
いいえ、難しいです。時間がかかります。では、こうしたポリシーを実施するのは容易でしょうか? いいえ、非常に困難です。しかし、ここで私が目にしているのは、多くの金融機関や製造業の大手企業が、こうした技術をどのように安全に展開すべきかを実際に決める主導権を握っていることです。
彼らは、外部の枠組みや規制が策定されるのを待ってはいません。なぜなら、これらの種類の圧力がすべて背後にあることを理解しているからです。そして、もし彼らが待っていれば、遅れを取ることになるでしょう。
グラント・ウォーターフォール: ええ。それはとても心強いですね。
ホダ・アル・クザイミ: 私は長い間そう考えてきました。それは素晴らしい質問であり、防御を構築するための戦場と、エージェントの分野を示す見事な比喩だと思います。サイバーセキュリティの分野では、私たちは長い間、悪魔から逃げ続けてきたと思います。
そして、私たちの悪魔とは、私たちが複数の分野で構築している、さまざまな異種ネットワークやプラットフォームの中にあるガバナンス構造の欠如です。私たちは、エージェントを含む新たな革新や、その他多くの新興技術の概念に対するガバナンス構造に向き合わなければなりません。そして、機器に対する俊敏な規制の欠如も、間もなく大きな問題になるでしょう。
今、規制を策定して現場で施行するまでに3年かかっていますが、その間にも機器は次々に導入され、月単位で、場合によっては数週間で、さまざまなバージョンやアップデートが行われています。ですから、あっという間です。
したがって、私は、エージェントが自らを規制し、規制や構造、そして封じ込めの仕組みについて学習できるよう、俊敏な規制を構築する必要があると考えます。そうすれば、現在私たちが想定しているような、混沌とした戦場を避けられるでしょう。
残念ながら、今日私たちが目にしている大量のリスクは、セキュリティが欠けているからだと思います。エージェントやその他の新興技術の設計に関わる科学者、サイバー科学者、開発者たちのことを言っています。ツールについてもそう思います。
素晴らしい科学者や、同じく優れた開発者たちが、収益性のために技術を市場に投入しようと競っています。しかし同時に、私たちは倫理的な利用と、あらゆる分野での責任ある利用のために、責任ある技術を市場に投入する必要もあるのです。
グラント・ウォーターフォール: 非常に、非常に良い指摘です。ニック、何か付け加えることはありますか?
ニック・チャベス: はい、手短に。ハイパースケーラーが、この取り組みの入り口になることは必然だと思います。そうですよね?
というのも、「予算が1万ドルや10万ドルあって、データベースを導入してエージェント型AIの構築を始めたい」と言うのが、最も簡単だからです。そして、もし規制当局がどこかに焦点を当てるとすれば、おそらく批判も受けることになるでしょうが、まずハイパースケーラーと協力することを検討すべきかもしれません。
さて、マタンの指摘に関連して言えば、企業は新しい筋肉を築く必要があります。その新しい筋肉とは、自社の情報にどれだけの価値があるかを評価し、それを守るためにどれだけ支出する用意があるかを計算することです。なぜなら、攻撃者もまったく同じ計算をしているからです。
ですから、もしAIエージェントを立ち上げて、ハイパースケールや、あまり知られていないクラウドプラットフォームのいずれかで実行し、UnixやLinuxのマシンを構築して、動かせる状態にする能力があるなら、攻撃者は2万ドルを費やして、そのエージェントを通じて1,300万ドルを得るかもしれません。そうですよね。
ですから、企業は情報を特定し、その情報がどのように保護されているか、どのようにエージェント的に展開されているか、そしてそれを保護するためにどこまで投資する用意があるかを把握する、俊敏なプロセスを持つ必要があります。そして、それをほぼ継続的に行う必要があります。
今、それは変更管理の会議のようなものです。「では、今月、今週、あるいはこの期間について話し合いましょう」というようなことです。なぜなら、他の誰かが常にあなたの情報の価値を評価し、それを奪うのにどれだけ費用がかかるかを計算しているからです。
ホダ・アル・クザイミ: 素晴らしいですね。ニックの発言に付け加えると、オープンソースのプラットフォームを推進することは、非常に重要だと思います。内部で何が動いているのか、何が開発されているのかを確認でき、透明性を確保することで、GenAI内で想定している製品のセキュリティ状況を相互に分析し、検証することができるからです。
ニック・チャベス: 真のオープンソースですね。
ホダ・アル・クザイミ: そのとおりです。真のオープンソースです。同意します。
グラント・ウォーターフォール: パネリストと確認させてください。質問を受け付ける時間はまだありますか?もう一つだけ。ええ、はい。
会場からの質問者2: [聞き取り不能]私の質問は、先ほど少し触れられた内容を踏まえたものです。エージェントの運用は難しいですよね。エージェントを導く歴史を見ても、驚きはあまりありません。そして、それはサイバー空間でも今見られることです。
知的エージェントは、期待どおりにルールを守り続けるとは限りません。そして、どのように。しかし、彼らが構築される本来の意図との整合性は、信頼の前提であり、より重要な業務を任せるための前提でもあります。
AIの検証と妥当性確認は遠い将来の話なので、おそらく、エージェントの非生産的または望ましくない振る舞いを、より早い段階で監視し対応するための、その中間に位置する何かが必要なのではないでしょうか。
では、デジタルマインドが期待どおりに動作するよう保護するという点について、どうお考えでしょうか。
マタン・ゲッツ: ええ、まさにそれが私たちの取り組んでいることです。ご質問ありがとうございます。AIエージェントができることとできないことを制限する、インラインでリアルタイムの、深いリアルタイムのガードレールが必要です。これは私が話していた期待値です。
例えば、ローン審査の支援アシスタントであれば、そのようなアシスタントと議論すべきトピックは何か、またどのようなトピックは何らかの形で議論しないべきかを決める必要があります。
すべてを自然言語で記述できることは利点です。なぜなら、今では自然言語で期待値を設定できるからです。しかし、それを厳密に定義し、AIエージェントが必要なことを何でも行えるだけの余地を十分に持たせることは、簡単ではありません。
しかし、他のものに対して十分に限定されるだけの時間は必要です。そしてそれには専門知識が必要です。ですが、リアルタイムでAIエージェントを監視し保護する新しい技術が必要だというあなたの意見には同意します。そして、既存のセキュリティスタックでは、それを行うことはできません。
グラント・ウォーターフォール: それでは、このパネルを終了せざるを得ません。時間切れです。パネリストの皆さんに心から感謝します。非常に多様な視点を持つ、素晴らしいパネルだったと思います。
正直に言って、これは私たちにとって本当に大きな新しいテーマだと思います。皆さんにも明確に伝わったことを願っています。そして、皆さんはここで最初に耳にしたことになります。ありがとうございました。パネルを閉じましょう。ご参加いただいた皆さん、そしてオンラインの皆さんにも感謝します。
自律的な意思決定に伴う脆弱性からAIを活用した攻撃まで、AIエージェントの急速な進歩は、組織や社会に新たな脅威をもたらす可能性があります。
新たなサイバーセキュリティリスクを最小限に抑えつつ、AIエージェントを効果的に活用するために、企業はどのような責任に基づく戦略を採用すべきでしょうか?
これは、2024年11月13日にジュネーブの世界経済フォーラムで開催された討論の全音声です。動画は、フォーラムのデジタル会員が次のリンクで視聴できます: https://toplink.weforum.org/event-mode/a0PTG0000004wNC2AY/sessions/a0WTG000000TESb2AO/defending-the-digital-mind-the-emerging-challenges-of-ai-agents
登壇者:
Grant Waterfall、PwC 欧州・中東・アフリカおよびドイツ パートナー、サイバーセキュリティ・プライバシー部門リーダー
Hoda Al Khzaimi、ニューヨーク大学アブダビ校サイバーセキュリティセンター ディレクター
Matan Getz、Aim Security 最高経営責任者(CEO)
Nic Chavez、Datastax 最高情報セキュリティ責任者(CISO)
その他のポッドキャスト:
すべてのポッドキャストは以下でご覧いただけます wef.ch/podcasts:
YouTube: - https://www.youtube.com/@wef/podcasts
Radio Davos - 購読: https://pod.link/1504682164
Meet the Leader - 購読: https://pod.link/1534915560
Agenda Dialogues - 購読: https://pod.link/1574956552
下記の「World Economic Forum Podcast Club」: https://www.facebook.com/groups/wefpodcastclub