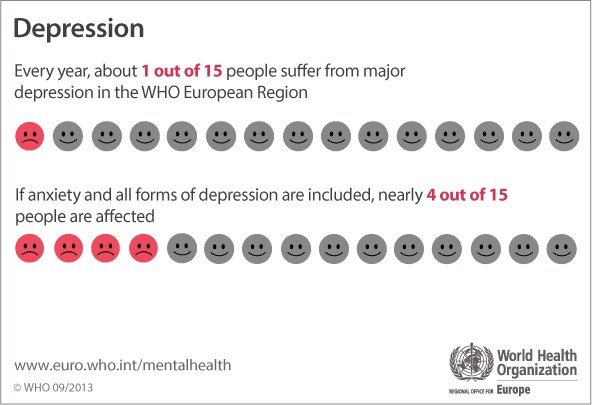
うつ病を診断するために、臨床医は患者に面接を行い、例えば過去の精神疾患、生活習慣、気分などについて特定の質問をし、患者の回答に基づいて病状を特定します。
近年、機械学習は診断を補助する有用な手段として推奨されてきました。例えば、うつ病を示す可能性のある言葉や抑揚を検出できる機械学習モデルが開発されています。しかし、これらのモデルは、特定の質問に対する特定の回答に基づいて、その人がうつ病かどうかを予測する傾向があります。これらの手法は正確ですが、どのような質問がされるかに依存するため、利用の方法や場面が限られています。
Interspeech会議で発表される論文において、MITの研究者たちは、面接の生の テキストと音声データに適用して、うつ病を示す音声パターンを発見できるニューラルネットワークモデルを詳述しています。新しい被験者が与えられた場合、質問と回答に関する他の情報を必要とせずに、その人がうつ病かどうかを正確に予測できます。
研究者たちは、この手法を自然な会話の中でうつ病の兆候を検出するツールの開発に活用できることを期待しています。将来的には、例えばこのモデルがユーザーのテキストや音声を監視して精神的苦痛を検知し、警告を送信するモバイルアプリに活用される可能性があります。これは、距離、費用、あるいは何らかの問題があるかもしれないという認識の欠如により、初期診断のために臨床医を受診できない人々にとって、特に有用となるでしょう。
「人が幸せ、興奮、悲しみ、あるいはうつ病のような深刻な認知状態にあるかどうかを示す最初の手がかりは、その人の話し方にあります」と、コンピューターサイエンス・人工知能研究所(CSAIL)の研究者で筆頭著者のTuka Alhanai氏は述べています。「[うつ病検出の]モデルを拡張可能な方法で導入したい場合……使用するデータに対する制約をできるだけ少なくする必要があります。どのような通常の会話にもモデルを導入し、自然なやり取りから個人の状態をモデルに把握させたいのです。」
もちろん、この技術は、臨床の現場における日常的な会話での精神的苦痛の特定にも依然として使用できる、と共著者でありCSAILの上級研究科学者であるJames Glass氏は付け加えています。「患者一人ひとり話し方は異なりますが、モデルが変化を捉えれば、医師への注意喚起になるかもしれません」と同氏は述べています。「これは、臨床医を支援する何らかの補助的な手段を提供できるかどうかを探る、一歩前進です。」
この論文のもう一人の共著者は、医療工学・科学研究所(IMES)のメンバーであるMohammad Ghassemi氏です。
文脈に依存しないモデリング
このモデルの重要な革新性は、うつ病を示すパターンを検出し、その後、追加情報なしにそれらのパターンを新しい個人に当てはめる能力にあります。「私たちはこれを『文脈に依存しない』と呼んでいます。なぜなら、探している質問の種類やそれらの質問に対する回答の種類に、制約を一切設けていないからです」とAlhanai氏は述べています。
他のモデルには、特定の質問セットが与えられ、うつ病でない人がどのように回答するか、うつ病の人がどのように回答するかの例が与えられます。例えば、「うつ病の既往歴はありますか?」という単刀直入な質問です。これらの正確な回答を用いて、同じ質問をされた新しい個人がうつ病かどうかを判断します。「しかし、自然な会話はそのようには進みません」とAlhanai氏は述べています。
一方、研究者たちは、音声処理によく用いられるシーケンスモデリングと呼ばれる手法を用いました。この手法では、うつ病の人とそうでない人の両方の質問と回答から得られたテキストと音声データのシーケンスを、一つずつモデルに入力しました。シーケンスが蓄積するにつれ、モデルはうつ病の有無にかかわらず人々に現れる音声パターンを抽出しました。例えば「悲しい」「沈んだ」「落ち込んだ」といった言葉は、より平坦で単調な音声信号と組み合わさることがあります。うつ病の人は話すスピードが遅く、単語間の間隔が長くなることもあります。精神的苦痛に関するこれらのテキストおよび音声の識別子は、以前の研究でも検討されてきました。いずれのパターンがうつ病を予測するものかどうかを判断するのは、最終的にはモデル次第でした。
「モデルは単語の配列や話し方のシーケンスを観察し、これらのパターンがうつ病の人かそうでない人に見られる可能性が高いと判断します」とAlhanai氏は述べています。「そして、新しい被験者に同じシーケンスが見られれば、その人もうつ病かどうかを予測できます。」
このシーケンス手法は、モデルが会話全体を捉え、時間の経過とともに、うつ病の人とそうでない人の話し方の違いに気づくことも助けます。
うつ病の検出
研究者たちは、メンタルヘルスの問題を抱える患者と人間が操作するバーチャルエージェントとの面接の音声、テキスト、映像を含む、Distress Analysis Interview Corpusからの142件のやりとりのデータセットを用いて、モデルを訓練し検証しました。各被験者は、Personal Health Questionnaireを用いて、0から27までの尺度でうつ病の程度を評価されます。中等度(10~14)と中等度から重度(15~19)の間の基準値を上回るスコアはうつ病と見なされ、その基準値を下回るその他すべてのスコアはうつ病ではないと見なされます。データセット内のすべての被験者のうち、28名(20パーセント)がうつ病とラベル付けされています。
実験では、モデルは適合率と再現率の指標を用いて評価されました。適合率は、モデルが特定したうつ病の被験者のうち、実際にうつ病と診断された人の割合を測定します。再現率は、データセット全体において、うつ病と診断されたすべての被験者を検出するモデルの正確さを測定します。適合率はモデルが71パーセント、再現率では83パーセントのスコアを記録しました。誤りを考慮した、これらの指標の平均総合スコアは77パーセントでした。ほとんどの検証において、研究者らのモデルは、ほぼすべての他のモデルを上回りました。
Alhanai氏によれば、この研究の重要な知見の一つは、実験中に、モデルが音声からうつ病を予測するには、テキストよりもはるかに多くのデータを必要としたことです。テキストの場合、モデルは平均7組の質疑応答シーケンスを用いてうつ病を正確に検出できます。音声の場合、モデルには約30シーケンスが必要でした。「これは、うつ病を予測する、人々が使う言葉のパターンが、音声よりもテキストの方が短い時間枠で現れることを意味します」とAlhanai氏は述べています。このような知見は、MITの研究者や他の研究者がモデルをさらに改良するのに役立つ可能性があります。
この研究は「非常に有望な」試験的なものであるとGlass氏は述べています。しかし現在、研究者たちは、膨大な量の生データにわたって、モデルがどのような特定のパターンを識別しているのかを明らかにしようとしています。「現在のところ、これは一種のブラックボックスです」とGlass氏は述べています。「しかし、これらのシステムは、何を捉えているのかについての説明があれば、より信頼性が高まります。……次の課題は、モデルがどのデータに着目したのかを突き止めることです。」
研究者たちはまた、認知症など他の認知状態を抱えるはるかに多くの被験者からの追加データで、これらの手法を検証することも目指しています。「うつ病の検出というより、日常的な音声信号から、誰かに認知機能障害があるかどうかを評価するという、類似した概念です」とAlhanai氏は述べています。