最近の発言を受けて イーロン・マスク や スティーブン・ホーキングに加え、 機械超知能に関する新著 がオックスフォード大学教授ニック・ボストロムによって刊行され、人工知能(AI)がいつか人類の存亡を脅かすかもしれないという懸念に、メディアが沸き立っている。私たちは心配すべきだろうか。
まず、専門家の見解から始めよう。 最近実施された調査 では、世界で最も多く引用されている現役AI科学者を対象に、三つの主要な結論が得られた。
AI科学者は、「高水準の機械知能」(HLMI)、つまり「典型的な人間と少なくとも同程度に、ほとんどの人間の職業を遂行できる」AIが今世紀中に構築されると強く予想している。しかし、それが今世紀のいつ実現するかを予測するのは非常に難しいと考えている。
HLMIがいつか構築されると仮定すると、AI科学者は、機械超知能、すなわち「ほとんどの職業において、あらゆる人間の能力を大幅に上回る」AIが、その後数十年以内に続くと予想している。
HLMIが人類にプラスの影響をもたらすか、マイナスの影響をもたらすかについて、AI科学者の意見は分かれている。回答者は、「存亡の危機にかかわる破局」から「極めて良い」まで、五つの異なる結果の分類に確率を割り当てた。割り当てられた平均確率が最も高かった結果の分類は「総じて良い」(40%)だった。「存亡の危機にかかわる破局」に割り当てられた平均確率はわずか8%だった。
第一に、HLMIと機械超知能の実現時期に関する専門家の見解を信頼すべきだろうか。結局のところ、AI科学者は軍用ドローン、AppleのSiri、Googleの検索エンジンや自動運転車のような実用的なAIシステムを作る専門家であって、長期予測の専門家ではない。さらに、AIの進歩を予測してきた実績は せいぜいまちまちだ。だから、このような調査をあまり重視すべきではないのかもしれない。
しかし、専門家の見解より良い方法はあるだろうか。 1,000件を超える技術予測を遡及的に分析した研究 は、モデルや定量的な傾向分析が、短期予測と長期予測の双方で専門家の見解を上回る傾向にあることを示している。残念ながら、そうした手法を高水準の機械知能の予測に用いるのは難しい。 ムーアの法則 や、コンピューターハードウェアにおける類似の傾向に基づく予測は、比較的良好な結果を残してきたが、これらの傾向は ほとんど何も教えてくれない 。HLMIの実現時期は、利用可能なハードウェアだけでなく、予測が難しいAIアルゴリズムの飛躍的進歩にも左右されるからだ。
こうした不確実性を踏まえれば、HLMIがすぐに到来するという自信に満ちた主張も、はるか先のことだという自信に満ちた主張も、懐疑的に受け止めるべきだ。
第二に、社会への影響はどうだろうか。結論を出す前に、AIが(いずれ)人類の存亡を脅かすという 標準的な議論 について、よくある二つの誤解を解いておくことが重要だ。
今日、対処に値する存亡の脅威としてAIを論じる際、HLMIがすぐに到来するとも、AIの能力が「指数関数的に」向上するとも前提としていない。
ニック・ボストロムと私は、AIは(いずれ)対処に値する存亡の脅威になると考える人々の一員だ。しかし、私たちはAIの能力が一般に「指数関数的に」進歩するとは 考えていない 。実際、私たち二人とも、HLMIの実現時期について、AI科学者が想定するよりも遅い見通しを持っている。HLMIが今後20年以内に到来する可能性が高いと考えるからではなく、人間を超えるAIシステムから良い結果を確保するには、気候変動への対処などと同様に、数十年にわたる研究と協調の取り組みが必要になる可能性が高いと考えるからこそ、こうしたリスクを理解し、軽減するための研究をさらに進めるよう提唱している。今日取り組める技術面および戦略面の研究の一覧は、 こちら と こちらを参照。
懸念されているのは、HLMIが突然「目覚め」、私たちを滅ぼそうとすることではない。むしろ、目標を追求するために利用可能なすべての資源を合理的に使うHLMIにとって、人類の滅亡が副作用となる可能性が懸念されているのだ。
HLMIが突然「目覚める」ことはおそらくないし、悪意を持つこともおそらくない。そうしたシナリオはAIシステムを過度に人間になぞらえている。しかし、今日の単純なAIシステムとは異なり、HLMIは、目標がクリップの生産を最大化することでも、選挙に勝つことでも、世界中の潜在的なテロリストを検知することでも、その目標を追求する計画を自律的に立案し、実行することになる。そして、『 世界を代表するAI教科書』の共著者であるカリフォルニア大学バークレー校のコンピューター科学者スチュアート・ラッセルが 説明しているように、問題は次の点にある。
[AIの目標]は、人類の価値観と完全に一致しない可能性がある。人類の価値観は、そもそも(せいぜいの場合でも)特定するのが非常に難しい。
十分な能力を持つ知的システムはどれも、自らの存続を確保し、物理的資源と計算資源を獲得しようとするだろう。それ自体が目的なのではなく、割り当てられた任務を達成するためである。
あるいは、MIRIの同僚エリエザー・ユドコウスキーがかつて 書いたように、「AIはあなたを愛しても憎んでもいないが、あなたはAIが別の用途に使える原子でできている」。
しかし、これらの点だけでは、AIが人類に深刻な存亡の脅威をもたらすとは言えない。AI研究がさらに数十年進めば、技術的な安全性の課題はそれほど難しくないように見えてくるかもしれない。リスクが目前に迫ったとき、世界が団結し、オゾン層を破壊するクロロフルオロカーボンの問題を モントリオール議定書の後に解決したように、問題を解決するかもしれない。
朗報は、AIリスクをめぐる議論が本格的に始まり、リスクの深刻さや軽減策を学ぶために、規模は小さいながらも増加する資源が投じられていることだ。長期的なAIリスクの研究は、1980年までのクロロフルオロカーボン研究と同じ段階に達しており、悲観論者が恐れていたほど克服が難しい課題ではないと、まもなく分かるのかもしれない。あるいは、1975年までの気候変動研究と同じ段階に達したのかもしれない。当時は合意がなかったものの、この問題に取り組む少数の科学者が、人為的温暖化の根拠を最初にまとめていた。時が経てば分かる。
著者:ルーク・ミュールハウザーは、Machine Intelligence Research Instituteのエグゼクティブ・ディレクターであり、世界経済フォーラムの 人工知能・ロボティクスに関するグローバル・アジェンダ評議会のメンバーである。
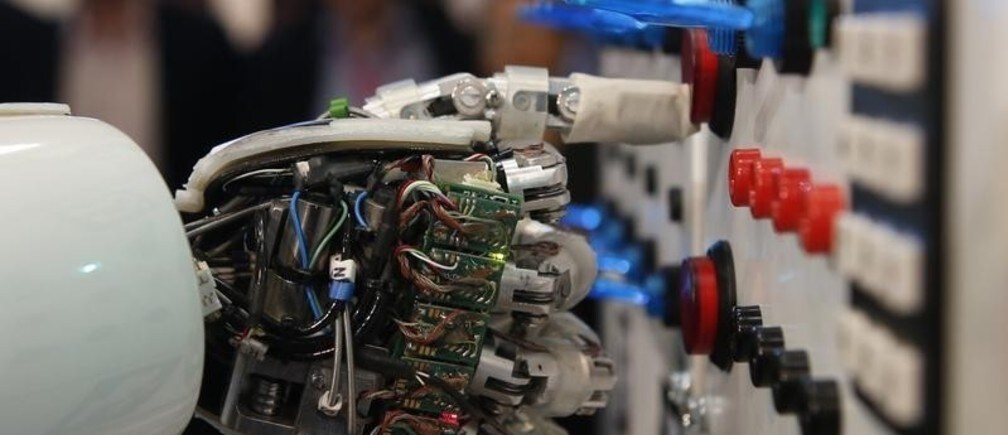
画像:人型ロボットAILA(人工知能を搭載した軽量アンドロイド)の手が、2013年3月5日にハノーバーで開催されたCeBITコンピューター見本市において、ドイツ人工知能研究センターによるデモンストレーション中に、配電盤を操作している。REUTERS/Fabrizio Bensch。




