この記事は The Conversationとの協力により掲載されています。
イギリスなまりで話しているとみられる、覆面をした「イスラム国」の戦闘員の最新動画により、彼は 暫定的に特定され た。イースト・ロンドン出身でイスラム教に改宗したSiddhartha Dharとされる。報道によると、音声認識の専門家が音声分析を用いて英国の情報機関と協力していたという。しかし、この技術はどのように機能し、何ができるのだろうか。
私たちの多くは、よく知っている声を聞くと、ほんの数語で誰が話しているかを認識できる。あまり馴染みのない声の場合は、もう少し時間がかかるかもしれない。話されている言葉の文脈や内容が馴染みのあるものであれば、さらに容易になる。一般的に、機械も録音を比較して一致するものを見つけようとする際には、同様の制約に直面する。
声から人物が誰であるかを特定することを目指す計算システム – 話者識別 – は、既知の単一話者の存在を検出すること、既知の複数の話者のいずれかに音声を照合すること、未知の録音から認識可能な内容を検出すること、あるいは音声の録音が実際に想定された話者によるものであることを検証することのいずれを目指すかによって異なる。
現代のシステムは、ビッグデータ・アプローチを採用する傾向にある。機械学習アルゴリズムは、既知の大量の録音データで学習させることで、個々の話者の声の特徴を認識できるようになる。その考え方は、異なる話者を区別する重要な特徴が自動的に学習されるというものである。対照的に、従来の手法では、話者間で比較するために重要と考えられる音声の言語的・音声学的特徴の種類をあらかじめ指定していた。
音声認識にとって最適な特徴の組み合わせが何であるかは実際のところ分かっていないが、それらは音響的特徴か言語的特徴のいずれかに分類できる。
音響的特徴と言語的特徴
音響的特徴とは、人間が音声を発する仕組みに関する特徴である。話すとき、空気は肺から排出され、気管を上って、喉頭を通り、口と鼻から外に出る。空気は通過する際に声帯を振動させ、声帯は緩んだり収縮したりすることで振動数を変化させ、それによって声の高さが変わる。
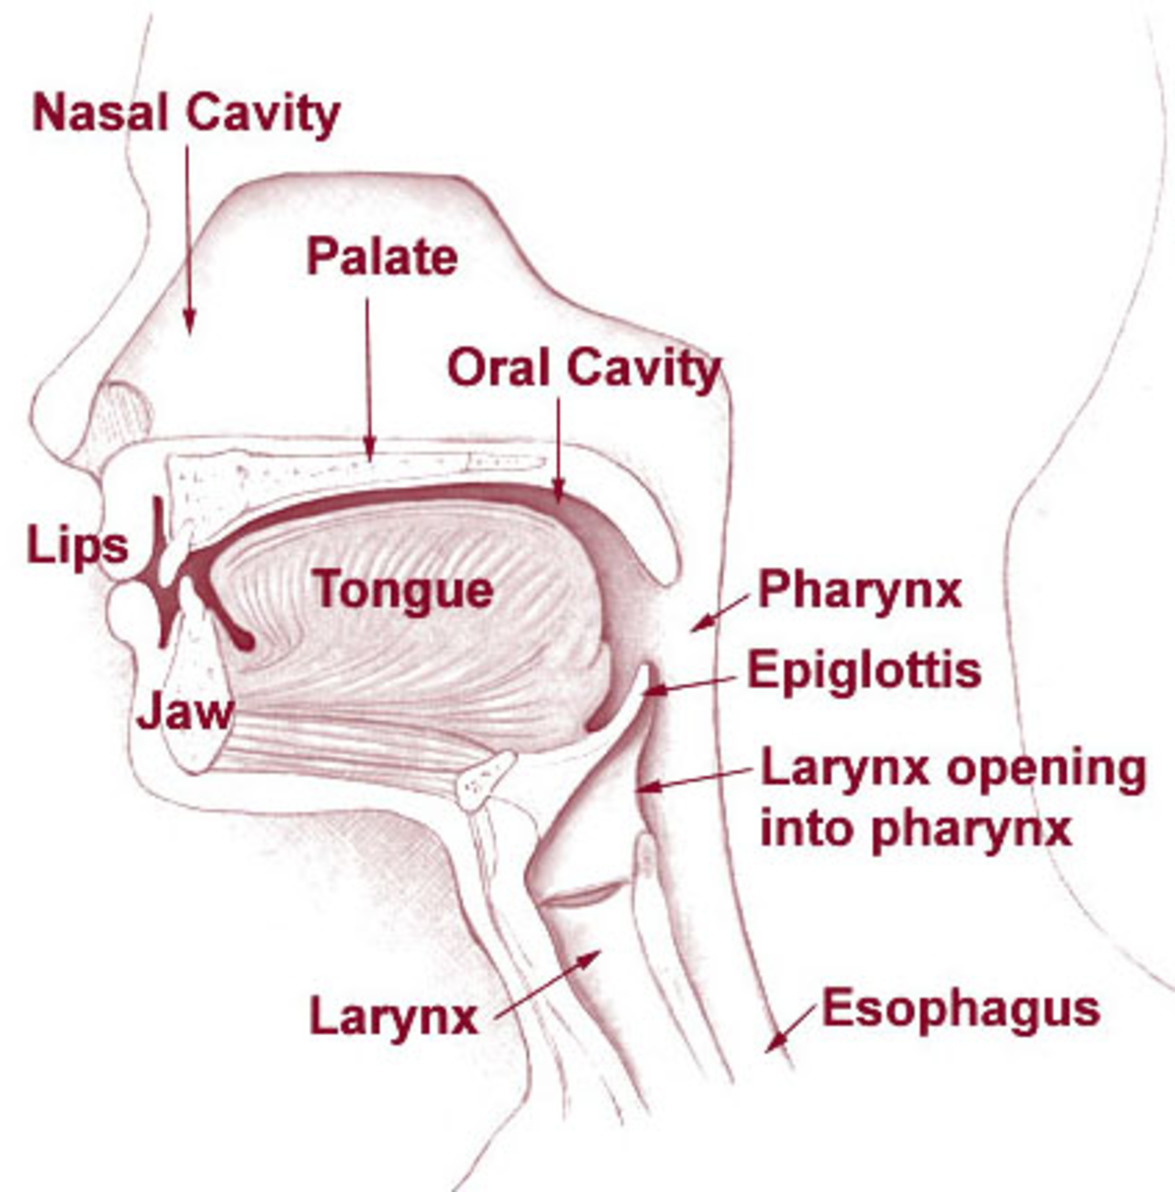
出典:National Cancer Institute
舌、歯、唇など、声道と鼻腔の内部にあるいくつかの部位 – 調音器官と呼ばれる – は、音を変化させて異なる共鳴 – フォルマントと呼ばれる – を生み出し、音声のその他の可変的な特徴を作り出す。私たちが音声として聞いているものは、空気がこれらの腔を通過し、これらの身体の部位の上や間を通る際のこうした相互作用のすべての組み合わせである。
私たち一人ひとりには固有の話し方の特徴がある。肺から息を吐く仕方、声帯が共鳴する仕方、調音器官が働く仕方はいずれも、固有の音を生み出す。ある人の「a」は、別の人の「a」とは大きく異なりうるし、それは英語に存在する44の音素(単語を構成する音の最小単位)のうちの一つに過ぎない。音素をどのように混ぜ合わせ、ある音素から次の音素へとどのように移るかも人によって異なり、その速さも同様である。安定したテンポと丸みを帯びた母音を持つ英国の田舎のなまりと、大都市でよく聞かれるより速く歯切れのよい話し方との違いを考えてみてほしい。
言語的特徴は、音素がどのように生成されるかではなく、どの音素をどのような順序で選んで使うかに関係する。私が「tomahto」と言い、あなたが「tomayto」と言うなら、私たちは同じ単語を、異なる音素の選択で発音したことになる。親しみや、しばしば地域差や世代差に基づいて、代替的な発音は非常に多く存在する。単語の選択、異なる語彙、文法パターン、特徴的な間や強勢、文構造や言い回しも、異なる話者を識別する手がかりとなる。
さらに高いレベルにあるのは、言葉そのものの意味である。私たちは何を言うか、そしてどのように言うかについて異なる選択をする傾向がある – 話し方が率直か、対立的か、回避的か、知的か、といった点である。もしあなたが誰かに会って、その人が弁護士、教師、芸術家のように話すと感じたことがあるなら、あなたが認識するそのパターンは、コンピュータも認識できるのである。

フレーズ‘I owe you’の時間・周波数スペクトログラム。 Jonas.kluk
すべてを理解する
計算の観点からは、まず言語的特徴と音響的特徴が切り出され、膨大なデータが、その重要な微妙な違いを簡潔に捉える、扱いやすい特徴の集合へと圧縮される。次に、パターンマッチングを用いて、これらを別の録音から得られたものと比較する。
自動的に抽出できる音声の特徴には、声の高さ、フォルマント周波数、声道の長さ、音節が発話される速度などがある。現代の一部の手法は、処理が少なく、人間の耳にとっての固有の意味が少ない低次の特徴を用いたほうがうまく機能する。これらは通常、スペクトログラムのような、時間と周波数の二次元マップである。
複雑な音声がより単純化された代表的な特徴の集合に縮約されると、一般化されたパターンマッチングの手続きが適用され、どのように比較するのが最善か、またパターンがどの程度一致するかが確かめられる。分析に足る十分な質の高い音声があれば、少数の容疑者の中から話者を一人に説得力をもって絞り込むことができる。比較するために両方の集合からより多くの音声があるほど、一致の精度は高まる。本件では、専門家は 英国にまだいた時期にインタビューに応じたダールの複数の録音を 持っていた。
容疑者がいなければ、この作業はほぼ不可能で、干し草の山から針を探すようなものだろう。しかし、録音から話者について学び推測できることそのものが、干し草の山をより扱いやすい大きさにまで縮小しうる。例えば、熟練した聞き手は、出身地域、年齢、性別、感情を絞り込み、話者の学歴について何かを推測することさえできるかもしれない。場合によっては、音声の専門家は、話者がどこで生まれたのか、両親が別の言語を話していたかどうか、そして最近までほかの場所に住んでいたかどうかを特定できることもある。おそらく英国をいつ離れたのかさえ分かるかもしれない。
SFか現実か?
多くが秘密のベールに包まれているものの、話者識別技術は、英国のGCHQ、米国のNSA、中国のPublic Security Bureauなどの国家安全保障機関によって使用されていると考えられている。また、一部の国では空港の入国審査カウンターで声紋が採取されているとも広く信じられており、そのことが、手続き中に意味のない質問を一つ二つされることがある理由をおそらく説明している――結局のところ、顔認証はすでに空港で広く普及しているのだから、声にも使われないわけがあるだろうか。
GoVivace、iFlytek、IBM、Nuanceなどの企業による商用の声照合技術は、政府が使用する技術に比べておそらく少なくとも一世代遅れている。現時点でこの技術がどの程度有用かは議論の余地があるが、金融機関では日常的に、 話者検証 という手段として利用されている――すなわち、自分が名乗るとおりの本人であることの証明を提供するものである。
声紋分析は1970年代から刑事事件で使用されてきたが、成功の度合いはまちまちであり、通常は、特定の録音の音声が特定の話者のものであることを証明するという、より負荷の少ない作業に用いられてきた。正しい一致が含まれていないかもしれない膨大な候補から一人の話者を照合しようとすることは、はるかに困難である。しかし、不可能というわけではなく、システムは改善されつつある。
掲載は、世界経済フォーラムによる見解の支持を意味するものではない。
Agendaの最新情報を把握するには、 週刊ニュースレターに登録する。
執筆者:Ian McLoughlinは、ケント大学のコンピューティング教授であり、スクール長(Medway)を務める。
画像:トルコ軍の車両がシリアの町コバニ近くに配置についている中、「イスラム国」の黒旗の近くを「イスラム国」の戦闘員が歩いている。REUTERS/Umit Bektas.




