公共政策の効果は、その対象をどれだけ効果的に選定できるかに一部依存する。機械学習は、利用可能な情報量が増加していることを活用することで役立つ可能性がある。本コラムでは、イタリアのデータを用いて、政策によって大きな恩恵を受けると見込まれる集団を対象とするために機械学習を活用する2つの事例を紹介する。また、少数の任意に選ばれた特性に基づく大まかな政策割当てルールを用いる従来の慣行と比較して、機械学習によるターゲティングの利点を示す。
政策立案に資するためには、因果関係に関する問いと予測に関する問いの両方に対する答えが必要である。Kleinberg et al.(2015)は、両者の違いを理解する助けとなる例を挙げている。干ばつへの対策を講じる政策立案者は、雨乞いの儀式が意図した効果をもたらすかどうかを知る必要があるかもしれない。これは純粋に因果関係に関する問いである。一方、傘を配布するかどうかといった他の雨に関する意思決定では、傘を持つことの利益が(少なくともある程度の近似においては)既知であるため、悪天候の可能性について良好な予測があれば足りる。Kleinberg et al.(2015)はこれを「予測政策問題」と呼んでいる。
政策評価の文献の大半は、因果関係に関する問いに焦点を当ててきた。計量経済学における「信頼性革命」(Angrist and Pischke 2010)は、公共プログラムの因果効果を事後的に推定するための手法を我々にもたらした。とはいえ、政策の効果はまた、その対象をどれだけ効果的に選定できるかにも依存する。資源が限られている場合、どの対象がより大きな成果をもたらすかを予測することは極めて重要となり得る。ここで機械学習が役立つ。統計学およびコンピュータサイエンスで開発された機械学習アルゴリズム(Hastie et al. 2009)は、予測タスクにおいて特に強力であることが証明されている(Mullainathan and Spiess 2017)。1
我々は、政策によってより大きな恩恵を受けると見込まれる集団を対象とするために機械学習を活用する2つの事例を提示する。2 これらの事例は、任意に選ばれた観測可能な特性に基づく大まかな割当てルールを実施する従来の慣行と比較して、機械学習によるターゲティングの利点を示している。もっとも、予測に基づくターゲティングが意図された効果をもたらすかどうかを最終的に示すのは、事後評価手法のみである。本コラムではまた、公共政策に機械学習アルゴリズムを用いる際に生じる、透明性や操作など、いくつかの問題についても論じる。
機械学習によるターゲティングの事例
Andini et al.(2018a)では、家計消費を押し上げることを目的として2014年にイタリアで導入された税額還付制度を検討している。イタリア政府は大まかなターゲティングルールを選択し、年間所得が8,145ユーロから26,000ユーロの間の従業員にのみ還付を提供した。政策目的を踏まえると、ボーナスからより多くを消費すると想定される消費制約のある家計をターゲットとすることも選択肢となり得た。
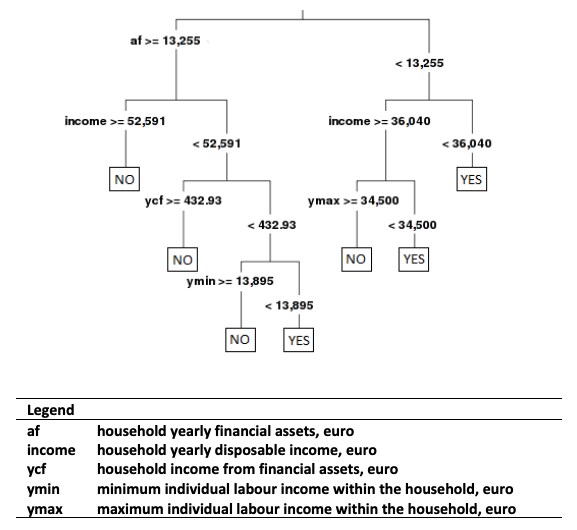
調査には、消費制約の代理指標として使用できる自己申告による測定値が含まれることが多い。我々は、イタリア銀行の「家計所得・資産調査(SHIW)」の2010年および2012年の調査回を用いた。同調査は、家計にやりくりの状況について尋ねている。我々は、ターゲティングに潜在的に用いられ得る多数の変数に基づいてこの状態を予測するために、既製の機械学習手法を採用する。我々が好む手法は決定木であり、図1に示される割当てメカニズムに至る。これは、主に家計所得と資産を指すごく少数の変数のみを選択する。例えば、金融資産が13,255ユーロ未満で、かつ家計の可処分所得が36,040ユーロ未満の家計は、消費制約があると予測される。その他に消費制約があると予測される集団は、図を見ることで容易に把握できる。
図1. 消費制約の状態に関する決定木予測モデル
消費制約があると予測された家計が還付金から消費する可能性が高いと信じる理由があるとしても、それが実際にそうであることを保証するものは何もない(Athey 2017)。こうした懸念を和らげるため、我々は2014年のSHIWデータを用いて、消費制約があると予測された家計と、そうでない家計それぞれについてボーナスの効果を別個に推定する。そのために、我々は標準的な計量経済学に立ち返り、観測可能な変数による選択を仮定して回帰分析を行う。
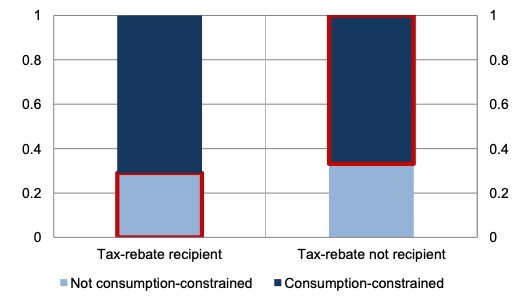
推定された効果は、消費制約があると予測された家計においてのみ、正であり有意である。税額還付の受給者の分布からは、機械学習をターゲティングに用いることで大きな成果が得られ得ることが示唆される(図2、赤枠で示す)。実際の受給者のおよそ3分の1は消費制約がないと予測される一方、非受給者のおよそ3分の2は制約があると予測される。
図2. 税額還付の受給者の状態別にみた、消費制約があると予測された者の割合
第2の事例(Andini et al. 2018b)では、企業への公的信用保証の割当てという「予測政策問題」に焦点を当てる。これらの制度は、公的資金による担保を提供することで、企業の銀行信用へのアクセスを支援することを目的としている。原則として、保証制度は、信用力があり(制度の財政的持続可能性を確保するため)、かつ信用割当てを受けている(他の企業は信用を得られる可能性が高いため)企業を対象とすべきである(World Bank 2015)。実際には、既存の保証制度は通常、信用力の低い借り手を除外する単純な規則に基づいている。我々は、信用力と信用割当ての両方を明示的に扱う、機械学習による予測に基づく代替的な割当てメカニズムを提案する。
本調査はイタリアを対象としており、同国では2000年から公的保証基金が運用されている。信用登録簿のミクロデータ(信用割当て3と不良債権の発生の両方の指標を含む)を用いて、仮想的な対象企業を特定し、その状態を予測する機械学習モデルを推定する。本事例では、我々が好む機械学習アルゴリズムはランダムフォレストであり、これは本質的には多数の決定木の平均である。
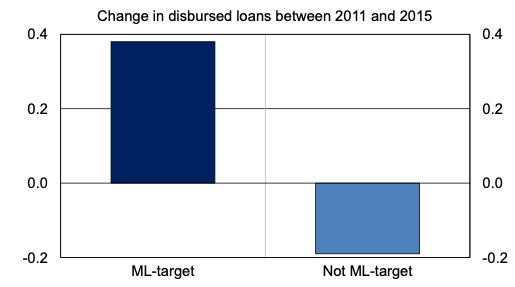
これらの企業をターゲットとすることで、制度の信用供与への影響が改善されるかどうかを評価するため、まず保証を受けた企業の集合を考慮し、機械学習がそれらをターゲットとすると予測したかどうかに基づいて2つのグループに分ける。保証の提供後の数年間における銀行融資の実行額の伸び率を単純に比較すると、機械学習でターゲットとされたグループの方が良好な成果を上げたことが示される(図3)。この結果は、より厳密な回帰不連続デザイン(de Blasio et al. 2018に準拠)を適用することで確認され、機械学習によるターゲットグループにおいて、保証が信用供与に与える影響がより大きいことが示される。
図3. 機械学習によるターゲット状況別にみた保証基金の受益企業の業績
機械学習によるターゲティングの問題点
政策ターゲティングに機械学習手法を適用するには、いくつかの論争的な論点に対処する必要がある。1つの懸念は、判断ルールの解釈可能性に関するものであり、これは精度を犠牲にする可能性がある。一部の用途では、税額還付の事例における決定木のように、単純なアルゴリズムで十分な正確性が得られる。他のケースでは、前述の公的保証制度におけるランダムフォレストのように、望ましい機械学習ターゲティングルールはブラックボックスのようなものとなる。ブラックボックス型ルールの解釈可能性の欠如は、対象から外された主体が、どのような根拠で対象とされなかったのかを容易に理解できない可能性があるため、透明性への脅威とみなし得る(Athey 2017)。精度と透明性の間のトレードオフは、個別の用途に依存する。
しかし、実質的透明性(substantive transparency)と呼ばれ得る透明性の一側面が存在する。これは、政策立案者が効果的な方法で公的資金を用いるという使命を果たす説明責任に関わるものである。この点において、機械学習によるターゲティングは、大まかな割当てルールを明らかに凌駕する。
もう1つの懸念は、機械学習に基づくターゲティングルールが、特定の成果(例:企業の信用へのアクセスの改善)を目標として構築されるという点である。この目標に到達するため、ターゲティングルールは特定の集団(対象)を選択し、他を選択しない。この選択は、他の政策目標を損なう可能性がある(「見落とされた成果」(omitted payoffs);Kleinberg et al. 2018を参照)。例えば、保証基金の事例を敷衍すると、公的保証は景気後退への対抗策としても強く推奨された。我々の機械学習ターゲティングルールが、危機による打撃がより大きかった南部地域に所在する企業を最終的に除外してしまうのではないかと疑問に思う向きもあるかもしれない。これは当てはまらない。機械学習に基づくルールは南部を優先する一方、保証基金の実際のルールは北部を優遇する。
最後の懸念は、ターゲティングルールが既知である場合、主体が政策から利益を得るために観測可能な特性を操作し得るというものである。もっとも、これはあらゆる種類のターゲティングにおいて当てはまる。例えば、税額還付について決定木と実際のルールを比較すると、ボーナスを得るためには、潜在的な受給者は(最も単純な場合には金融資産と所得の双方といった)複数の変数を操作する必要がある一方、実際の措置は所得のみに基づいていることがわかる。




