これまでに、潜在的な雇用主へ何百通、あるいは何千通もの履歴書やカバーレターを送ったことがあるのではないでしょうか。この見方は、米国労働統計局によると、米国の賃金労働者が現在の雇用主のもとで働く期間は平均4.2年であるという事実に裏付けられています。しかし、25~34歳の若年労働者では平均わずか2.8年で、転職が増える労働者層の一員として、より頻繁に求職活動をすることに慣れていることがうかがえます。
この傾向は、日本のような顕著な例外を除き、他の国々でも見られます。その結果、世界各地の多くのミレニアル世代が、ほぼ絶え間なくカバーレターや履歴書を送り続けるという新しいキャリアモデルにますます慣れてきています。
やがて、こうした応募を通じて、生活の質を左右する仕事のオファーを受け入れることになるかもしれません。収入、友人や家族と過ごせる時間、そして暮らす地域が決まります。
しかし、応募した仕事に採用される可能性が、体系的な偏りの影響を受ける場合もあります。例えば、米国の労働市場では、アフリカ系米国人の名前が体系的に差別される一方、白人の名前の応募者は面接の連絡をより多く受けることが示されています。しかし、偏りが見られるのは人為的ミスだけが原因ではありません。採用担当者がますます利用するアルゴリズムも中立ではなく、むしろ排除するはずの人間の過ちを再現しています。例えば、Amazonが2014年から2017年にかけて応募者の選考に使っていたアルゴリズムは、応募者の履歴書にある「女性」などの語や女子大学の名称を不利に扱ったと報じられています。同様に、ノースイースタン大学、カリフォルニア大学、および公益擁護団体Upturnの研究者らは、Facebookの住宅広告と求人広告の配信が、ジェンダーや人種に関するステレオタイプに沿っていることを実証しました。
どうすればよいのでしょうか?
こうした偏りがあるなか、履歴書やカバーレターを面接につなげる可能性を高めるには、どのような対策を取れるでしょうか?
現在、ターゲット、ヒルトン、シスコ、ペプシコ、アマゾンなどの大企業の採用担当者は、予測型採用ツールを使っています。採用にかかる時間と費用を減らし、理論上は新規採用者の質と勤続期間を高めるためです。採用プロセスのどの段階でアルゴリズムが使われるかを理解すれば、偏りの発生源を特定しやすくなります。
通常、採用は単一の決定ではなく、内定に至るまでの多くの小さな判断を伴うプロセスです。最初の段階は「ソーシング」と呼ばれ、優れた応募者層を形成することを目的とします(図1参照)。広告、積極的なヘッドハンティング、魅力的な求人情報などを通じて行います。通常、人工知能(AI)は求人広告の表示や文面の最適化に使われます。「文章作成支援」を提供する企業がその例で、Textioなどがあります。
第二段階の選考は重要です。ここでアルゴリズムの偏りが、応募を不採用にするかどうかに大きく影響する可能性があるからです。選考ではアルゴリズムを使ってカバーレターや履歴書を体系的に解析し、その情報を企業の人事データベースに保存します。情報には、経験年数、話せる言語、取得した大学の学位、勤務した国などが含まれる場合があります。その後、アルゴリズムによって候補者を自動的に絞り込みます。適任者を積極的に選ぶのではなく、条件に合わない人を除外する形です。例えば、企業CVViZは、機械学習アルゴリズムを用いて履歴書のキーワードを文脈に沿って選別し、候補者間の相対的な順位を作成しています。
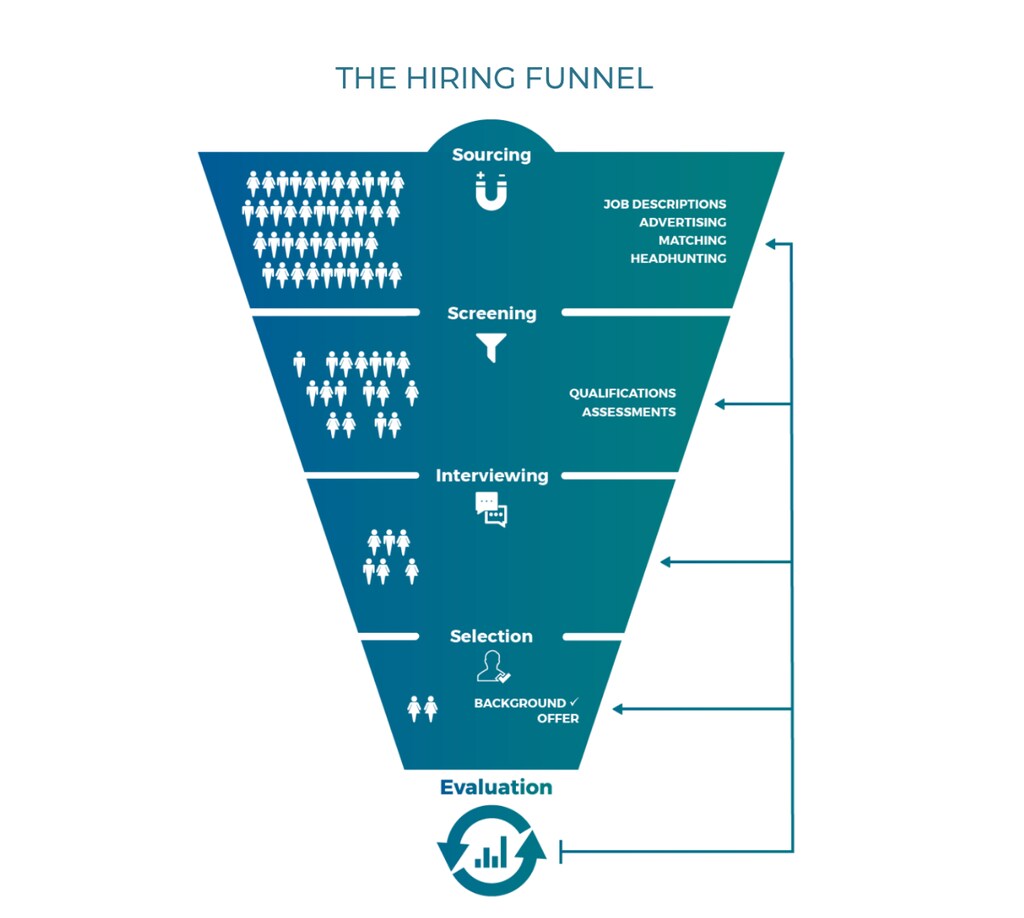
選考を通過すると、雇用主の最終選考を支援する別のアルゴリズムが使われる面接に招かれることがあります。HireVueは米国を拠点とする企業で、ビデオ面接で候補者が使うキーワードや表情、声の調子をもとに評価します。ビデオ面接の後に対面面接が行われ、最終的に内定を得ることもあります。
こうした各段階で機械学習アルゴリズムを使うと、AI主導の採用システムが公平かどうか疑問が生じます。前述のFacebookの例のように、求人広告が潜在的な従業員にどのように届けられるかに偏りがあるかもしれません。また、ウェブクローラーが公開オンライン情報をスキャンして求人情報に合う候補者を探す場合もあります。この場合、応募を妨げるわけではないため不公平さは限定的だと言えるかもしれませんが、選考プロセスにはすでに克服しにくい強い偏りが表れている可能性があります。
アルゴリズムは特定の形式の履歴書を読み取るよう学習されることが多く、そのため履歴書が適切に評価されない場合があります。例えば、日本では多くの応募者が共通の履歴書様式(履歴書)を使います。中国では、応募者は職歴を新しい順に記載します。米国と欧州の履歴書にも文化的な違いがあります。米国の履歴書は通常、写真なしの1ページですが、欧州では写真を載せ、2~3ページになることがあります。
履歴書の解析、つまり機械可読データへの変換がうまくいくと、別のアルゴリズムが履歴書とカバーレターの情報をもとに、他の応募者と比較して応募者を順位付けします。経験年数、言語、ソフトウェアのスキル、使用する語句など、成功を測る指標の一部にすぎませんが、それぞれの要素は過去にうまくいったと推定される内容に応じて重み付けされます。過去の採用判断を使ってアルゴリズムを訓練し、誰が「適切な」応募者である可能性が最も高いかを評価します。この方法はしばしば、AI採用ツールが登場する前から存在していた偏りをそのまま再現します。訓練データのジェンダー構成に大きな不均衡があると、応募書類にジェンダー情報が含まれていなくても、アルゴリズムがその不均衡を再現する可能性があります。例えば、Amazonの事例のように、ジェンダーの大きな不均衡が専攻分野と相関していることもあります。訓練データの偏りは、データ品質の低さや、多様性に乏しい非常に小さなデータセットから生じることもあります。世界規模で事業を展開せず、ニッチな人材を探している企業では、そうした状況が起こりえます。
同様に、対面でのやり取りの前に行うビデオ面接の評価も、性別、年齢、宗教などの属性について十分に検証されていない場合、訓練データに由来する偏りを再現する可能性があります。
提言
応募者と雇用主の双方がいくつかの対策を取ることで、最終的な採用判断を行う人間に適切な応募書類を読んでもらえる可能性を高められます。
応募者が取るべき対策:
1)履歴書は現地の慣例に沿った形式にしましょう。長さ、レイアウト、写真の有無、書式のうち、どれが最適か検討してください。アルゴリズムが読み取れない可能性のある図や凝ったフォントは避けましょう。
2)職務経験を詳しく記載し、求人情報で使われている言葉に合わせましょう。
3)履歴書に重要な情報を必ず記載しましょう。書かれていないことは評価できません。例えば、職歴には年だけでなく、月と年を記載してください。
4)適切な専門用語を使い、オンライン上での自分のブランドを最適化しましょう。希望する職種群に合った言葉を使ってください。例えば、IT職には「フルスタック開発者」などさまざまな職名があり、C++やPHPなどのプログラミング言語と関連付けて使われることがよくあります。
採用プロセスで機械学習アルゴリズムを使う雇用主にとって、公平性の確保が鍵となります。次の概念は、デルフト工科大学で行われた最近の研究をもとにした指針となるでしょう。
正当化:特定の規模で特定の採用ニーズを持つ組織にとって、データ要件や偏りを是正する必要性を踏まえても、AI採用ツールを導入することは妥当でしょうか?
説明:AIツールは判断の理由を説明し、その説明を採用担当者と応募者に提示していますか?アルゴリズムに関する情報が独占的なものである場合、反実仮想による説明は考慮されていますか?
予見:偏った判断を報告する仕組みはありますか。また、どのような救済手段が用意されていますか?
省察:組織は自らの価値観の変化と、それが使用データにどう反映されるかを認識していますか?データはどのように収集され、どのような限界が明らかになりますか?
包摂:チームの多様性や評価結果における多様性について考慮していますか?
監査可能性:訓練データは公開されていますか。それとも第三者による検証を受けていますか?




