新たな研究によると、脳には曖昧な音を解釈し直す際に働く「自動修正」機能があります。
「人が聞こえたと思う音は、耳に届く実際の信号と必ずしも一致しません……」
この研究は、脳が最初の音を検知した後に得た情報を、音声理解にどう役立てるかを明らかにしています。『Journal of Neuroscience』に掲載されたこの研究結果は、音声理解を助けるために情報や文脈を活用する新たな仕組みを示しています。
「人が聞こえたと思う音は、耳に届く実際の信号と必ずしも一致しません」と、筆頭著者でニューヨーク大学心理学部博士課程の学生、かつNYUアブダビの言語神経科学研究所の研究者であるローラ・ウィリアムズ氏は説明します。
「私たちの結果が示すのは、脳は後続する音声を聞くたびに、必要に応じて解釈を更新するため、音声の解釈を再評価するということです」とウィリアムズ氏は述べます。
「注目すべきことに、聞き手が知覚の変化にまったく気づかないまま、最大1秒後に生じる文脈によって聴覚が影響を受けることがあります。」
「例えば、『b』と『p』のような曖昧な語頭音は、『parakeet』という単語に含まれるか、『barricade』という単語に含まれるかによって、どちらかの音として聞こえます」と、研究を主導したアレック・マランツ氏は付け加えます。同氏は言語学部と心理学部の教授で、研究が行われた言語神経科学研究所の共同所長です。
「曖昧さを意識していなくても、こうしたことが起きます。曖昧さを解消する情報が現れるのは、3音節目の途中になってからです。」
研究者たちは、こうした刺激の例を作成しました。音声はこちらで聴くことができます。
鍵となるのは文脈
音声の知覚は、単語、文、その他の音声といった周囲の文脈によって決まることがよく知られています。多くの場合、こうした文脈情報は最初の感覚入力より後に聞こえます。
「興味深いのは、解釈される音の後に文脈が現れても、それを使って音の知覚を変えられるという点です……」
これは日常生活でも起きています。会話では、実際に発する言葉がしばしば曖昧です。例えば、友人が車に「dent(へこみ)がある」と言ったとき、「tent(テント)」と聞こえることがあるかもしれません。こうした曖昧さは頻繁に起こりますが、聞き手である私たちはほとんど気づきません。
「脳が曖昧さを自動的に解消してくれるからです。脳はいずれかの解釈を選び、私たちはそれを聞こえたものとして知覚します」とウィリアムズ氏は説明します。「脳は周囲の文脈を使って、話し手が何を意味している可能性があるかを絞り込みます。」
この研究で研究者たちは、脳が後から得られる情報をどのように使い、最初に聞いた音の知覚を変えるのかを理解しようとしました。
聞いてみよう
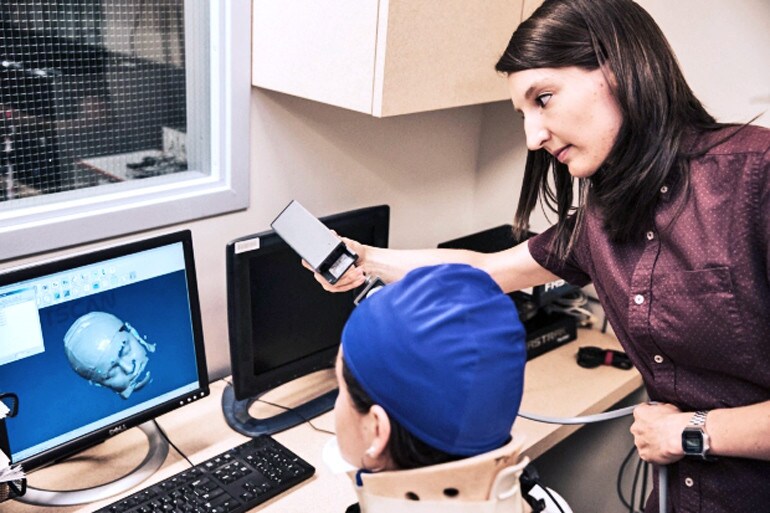
そのために、被験者が単独の音節や、似た響きの単語(例:barricade、parakeet)を聞く一連の実験を行いました。被験者の脳活動を測定するため、研究者たちは脳磁図法(MEG)を用いました。これは、脳が生み出す電流によって発生する磁場を記録し、神経活動を地図化する手法です。
電磁石を参加者の頭部に取り付け、装置内で頭部がどこにあるかを特定します。(クレジット:Kate Lord/NYU)
研究から、主に次の3つの知見が得られました。
脳の一次聴覚野は、音の開始からわずか50ミリ秒後に、音声がどの程度曖昧かを感知します。脳は後続する音声を解釈する際に、先行する音声を「再生」します。これは、単語の残りが展開するにつれて解釈を再評価することを示唆しています。脳は約0.5秒後に、信号の解釈について「最善の推測」を確定します。
「興味深いのは、解釈される音の後に文脈が現れても、それを使って音の知覚を変えられるという点です」とウィリアムズ氏は付け加えます。
例えば、同じ音でも「kiss」の語頭では「k」、「gift」の語頭では「g」と知覚されます。曖昧な音の後に来る単語の違い(「ss」と「ft」)によって、知覚が変わるのです。
「具体的には、聴覚系が聴覚野で音響信号を積極的に保持する一方、同時に、聞こえている単語の特定について推測を行っていることが分かりました」とウィリアムズ氏は述べます。「この処理方法により、メッセージの内容にすばやくアクセスできると同時に、聞き間違いを減らすため音響信号を再分析することもできます。」
この研究は、NYUアブダビ研究所、欧州研究会議、フランス国立研究機構、米国国立衛生研究所の助成を受けました。
NYUとジョンズ・ホプキンス大学の研究者もこの研究に貢献しました。




