世界中の人々がCOVID-19の感染と死亡のモデル、そして「カーブを平らにする」という概念に馴染みがありますが、どのモデルを信頼できるのかを知るのは困難です。
モデルは、保健当局、政策立案者、市民の行動を劇的に変えました。
こうした行動の変化によって死亡者数が減少したため、当初のモデルの推計が不正確であるように見えています。
人類の歴史において、COVID-19の感染曲線と死亡曲線ほど広く認知されたデータモデルはおそらくないでしょう。インドの農家から米国疾病予防管理センター(CDC)の所長に至るまで、ほぼ全員がこれらに馴染みがあります。
しかし、モデルには一貫性の欠如に対する批判も寄せられています。ロンドン大学インペリアル・カレッジが開発した初期のモデルの一つは、米国で220万人を超える死者を予測しましたが、その後のモデル(例:ワシントン大学のIHME(保健指標評価研究所))は、死者数をはるかに低く見積もりました。どのモデルを信頼できるのでしょうか。
COVID-19は、恐ろしく猛烈な勢いで世界中に広がり続けており、それに伴い誤情報も拡散しています。政府、組織、そして人々は、防護策、効果的に反撃する方法、そしてこの悪夢がいつまで続くのかについての真実を切実に求めています。これらの答えを得るには、正確で包括的なモデルが必要です。そしてそのようなモデルを得るには、モデルが実際にどのように機能するのかを正確に見ていく必要があります。
「すべてのモデルは誤りだが、中には有用なものもある。」
この言葉は英国の統計学者ジョージ・ボックスの言葉とされており、彼は後に「すべてのモデルは近似である」と記しました。
したがって、私たちが問うべきは「そのモデルは真実か?」ではありません。(真実であることは決してありません。)問うべきは「そのモデルは、この特定の用途に十分な精度があるか?」です。
モデルは、その定義上、特定の構成要素を強調し、他を無視したシステムの表現です。そのため、現実のすべての側面を反映することは決してできません。
しかしながら、モデルがいつ、なぜ誤るのかを理解することは依然として有益です。
モデルは、以下に基づいています。前提(現実のどの要素を含め、どの要素を除外するか)に基づいています。また、モデルの異なる構成要素がどのように相互作用するかという前提にも基づいています。例えば、疫学モデルには、疾病の一部の側面を含み、他を無視するモデルのファミリーがあります。SIRモデルは個人の感受性(Susceptibility)、感染(Infection)、回復(Recovery)に着目します。一方、SISモデルは感受性(Susceptibility)、感染(Infection)、再び感受性(Susceptibility)に着目します。これは一般的な風邪の再発のようなものです。SIRDモデルはSIRモデルに「死亡(Deceased)」を加えたものであり、SEIRモデルは感染症に潜伏期間がある場合の「曝露(Exposure)」を考慮します。SEIRモデルとSIRDモデルは、COVID-19に一般的に使用されている2つのタイプです。
データは、モデルを構築し、その正確性を検証するために不可欠です。不正確なデータをモデルに入力すると、不正確な結果が生じます。COVID-19の場合、コロナウイルスによる症例数、入院数、死亡数を、国、州、および/または郡のレベルでモデルに入力する必要があります。データが不完全な場合(例:遠隔地ではデータの収集と共有が困難な場合がある)や、データが不正確な場合(例:パンデミックの初期段階では、死亡が他の二次的な疾患に関連付けられ、誤って分類されている可能性がある)があります。
最後に、最善の努力にもかかわらず、不確実性が存在します。これはモデルの中で、私たちが知らない、そしておそらく確実に知ることができない側面です。COVID-19の感染率、潜伏期間、回復率には依然として多くの不確実性があり、これらはすべて再生産数に影響を与えます。さらに、ウイルスが人口の異なる層に与える影響についても、まだわかっていません。疾病の不確実性に加え、政策や行動の不確実性もあります。異なる政府や機関がこの危機にどのように介入するのか、また市民や従業員がこの緊迫した状況でどのように行動するのかを断言することはできません。
では、モデルが誤りうるのであれば、なぜ構築するのでしょうか。それらはどのような目的に役立つのでしょうか。
モデルは伝統的に、以下の用途を念頭に置いて構築されてきました。
説明。多くのモデルは、特定の現象を説明するため、現実世界の「煩雑さ」から抽象化するため、あるいは将来のシナリオに活用できる洞察を導き出すために構築されています。例えば、エボラ出血熱や鳥インフルエンザといった過去の感染症の流行における再生産数を理解するためのモデルを構築することは、介入策の策定に役立ちます。2003年に複数の国でSARS-CoV(重症急性呼吸器症候群)がどのように広がったかを知ることは、COVID-19、すなわちSARS-CoV-2に関する有用な手がかりを提供し得ます。
予測。モデルは、十分な過去のデータがあり、比較的安定した環境にある場合に将来を予測するために用いられます。しかし、不確実性が高い場合には、固有の不確実性を反映した一連の結果を予測するためにモデルが用いられることが多くあります。ウイルスやそれに対する私たちの反応についての理解が深まるにつれて、この不確実性を低減することができます。現在のCOVID-19モデルは、通常、症例数、入院数、死亡数の範囲を示しています。
行動の変化。モデルは、人々の行動を変えるために用いることができます。どの本を読むべきか、どの製品を買うべきかを推奨するモデルには、私たち全員が馴染みがあります。同様に、COVID-19モデルは、保健当局、政策立案者、政府機関、そして市民の態度や行動を変えてきました。
したがって、COVID-19モデルは「誤り」であったと主張することもできますが、それでも有用であることが証明されました。
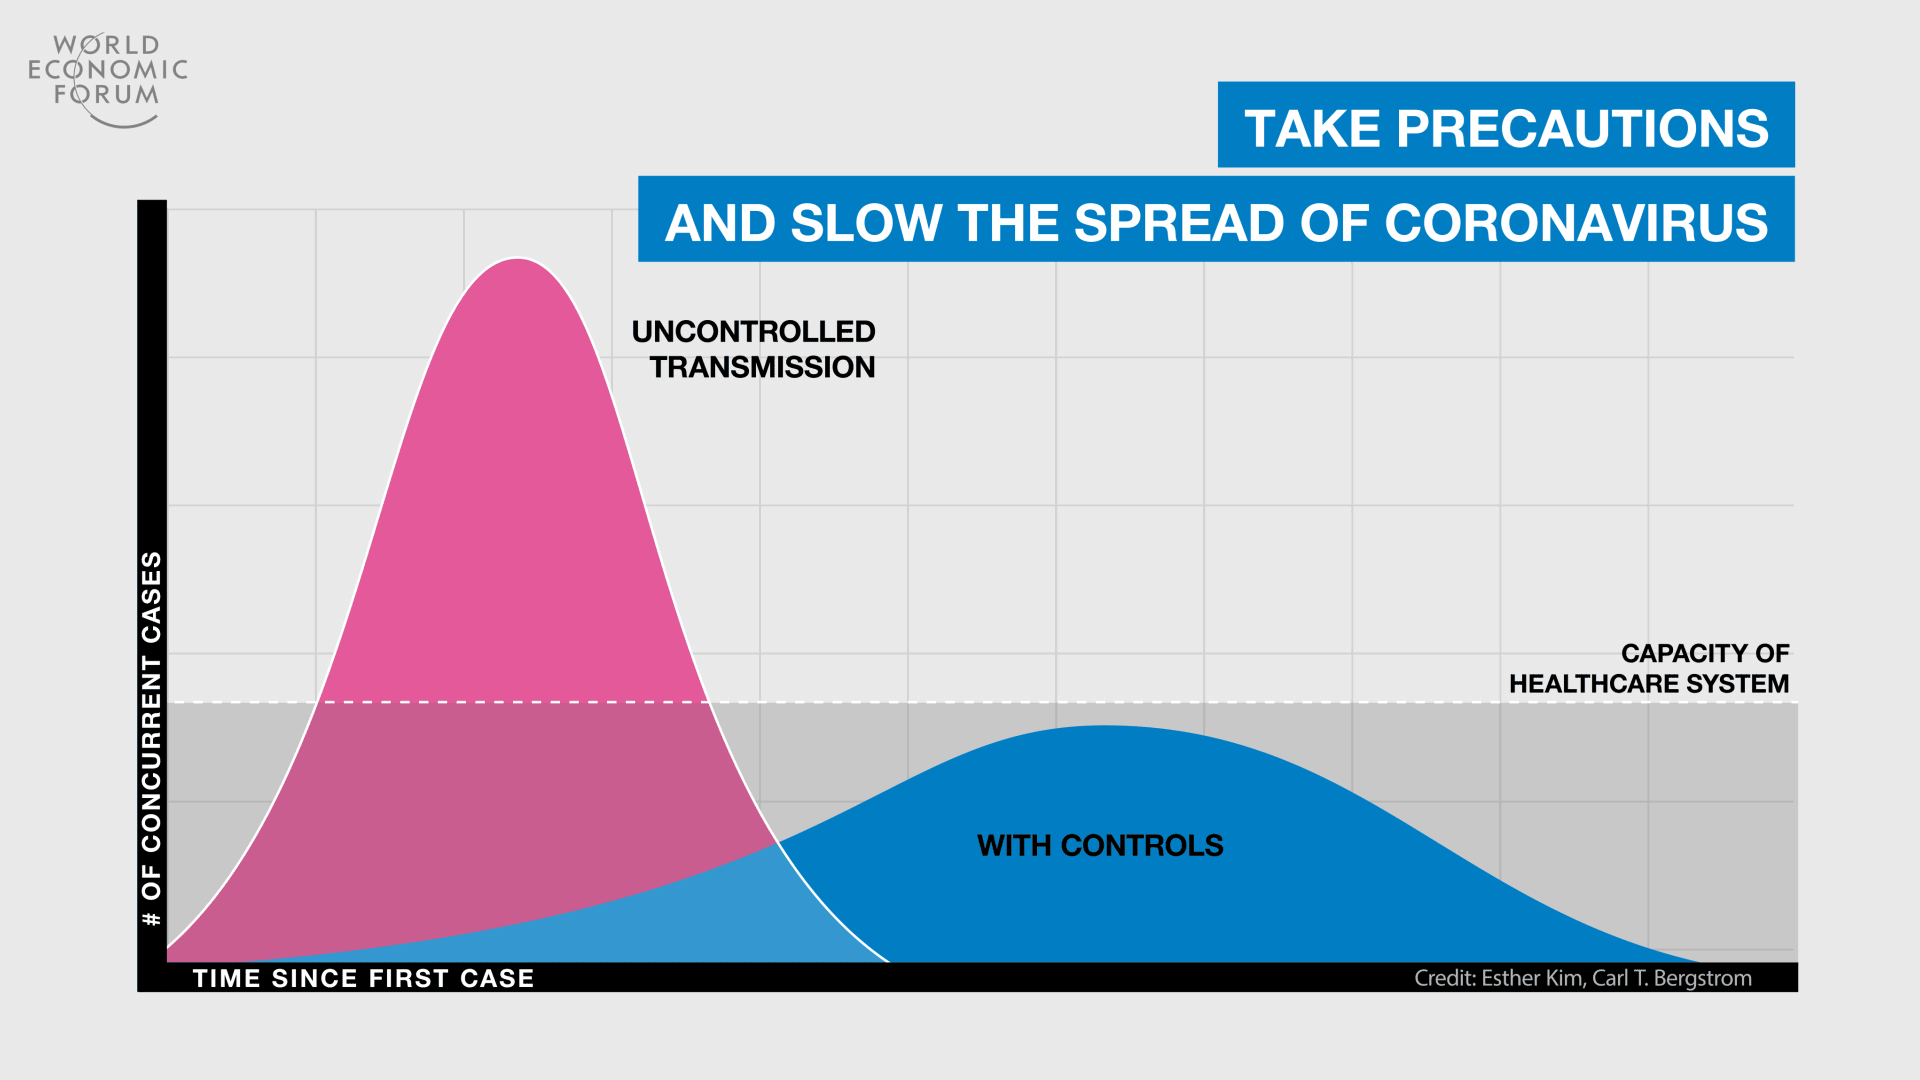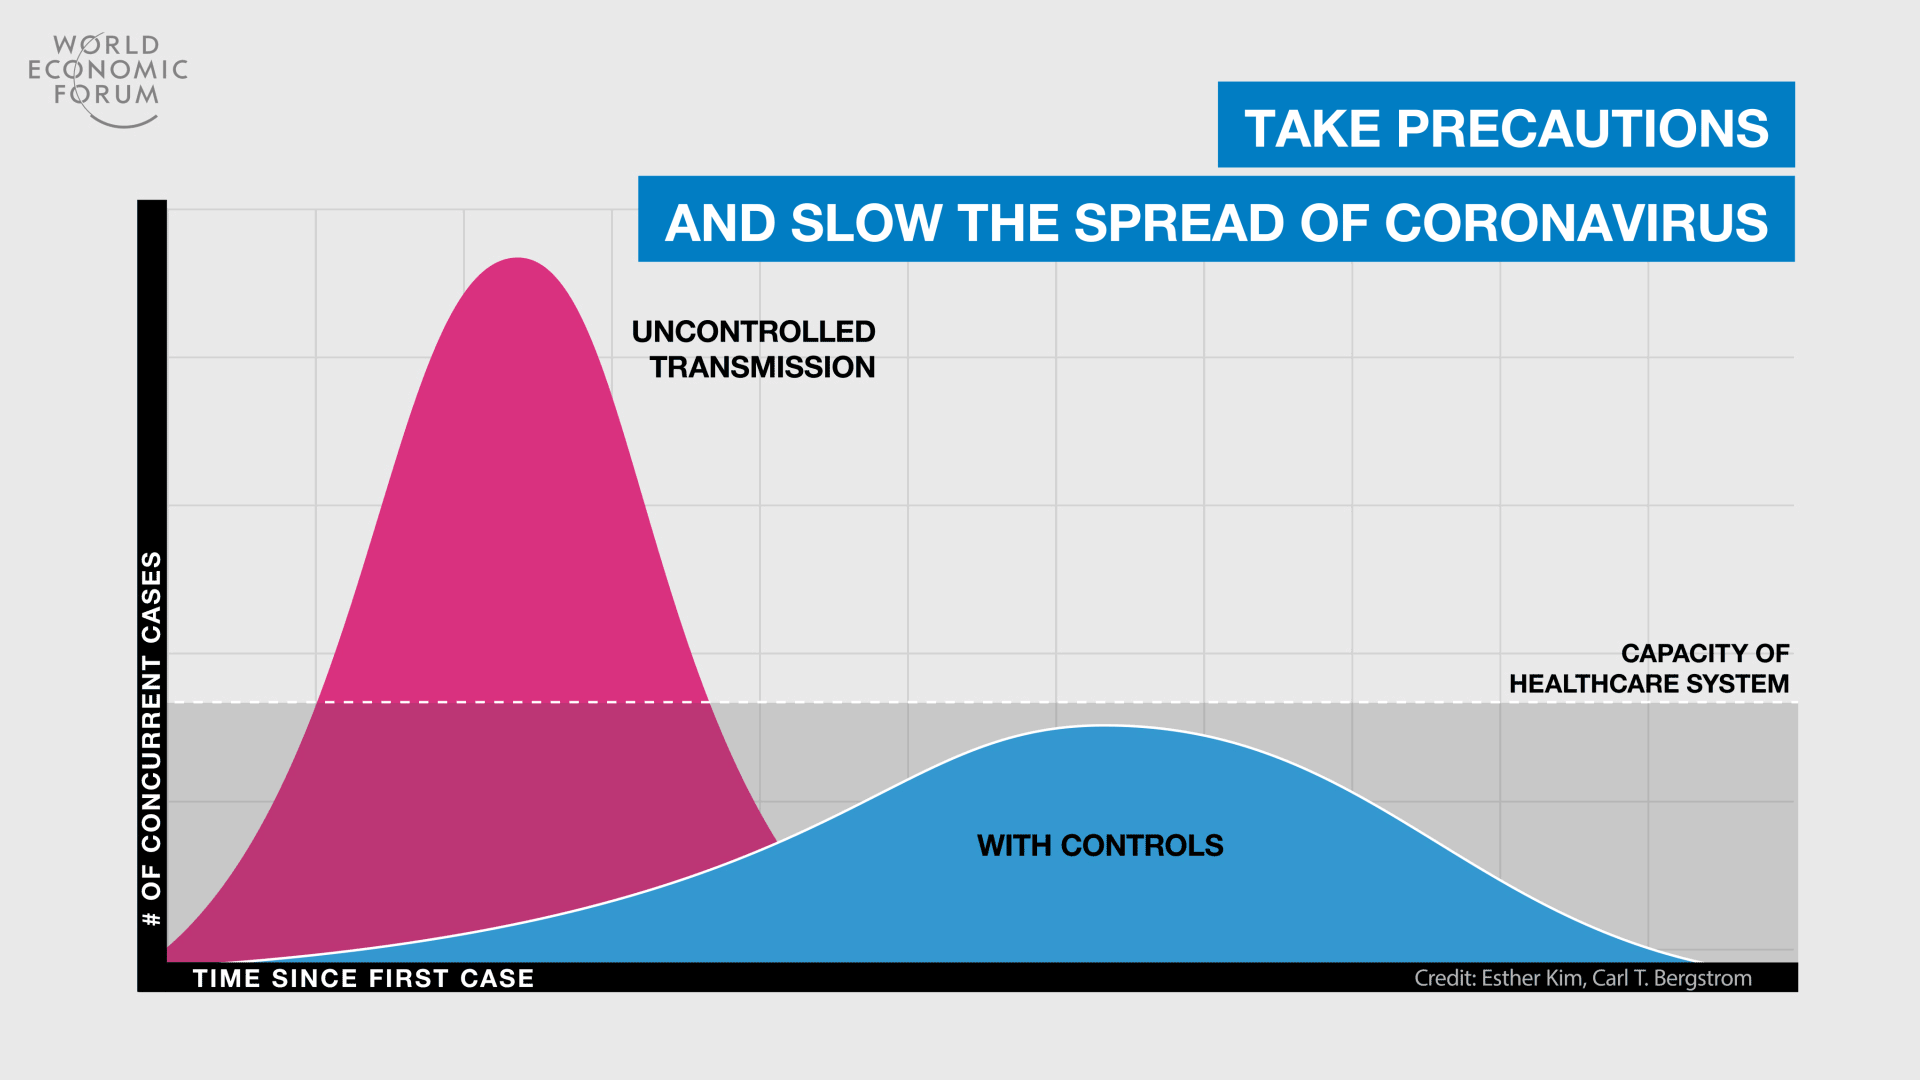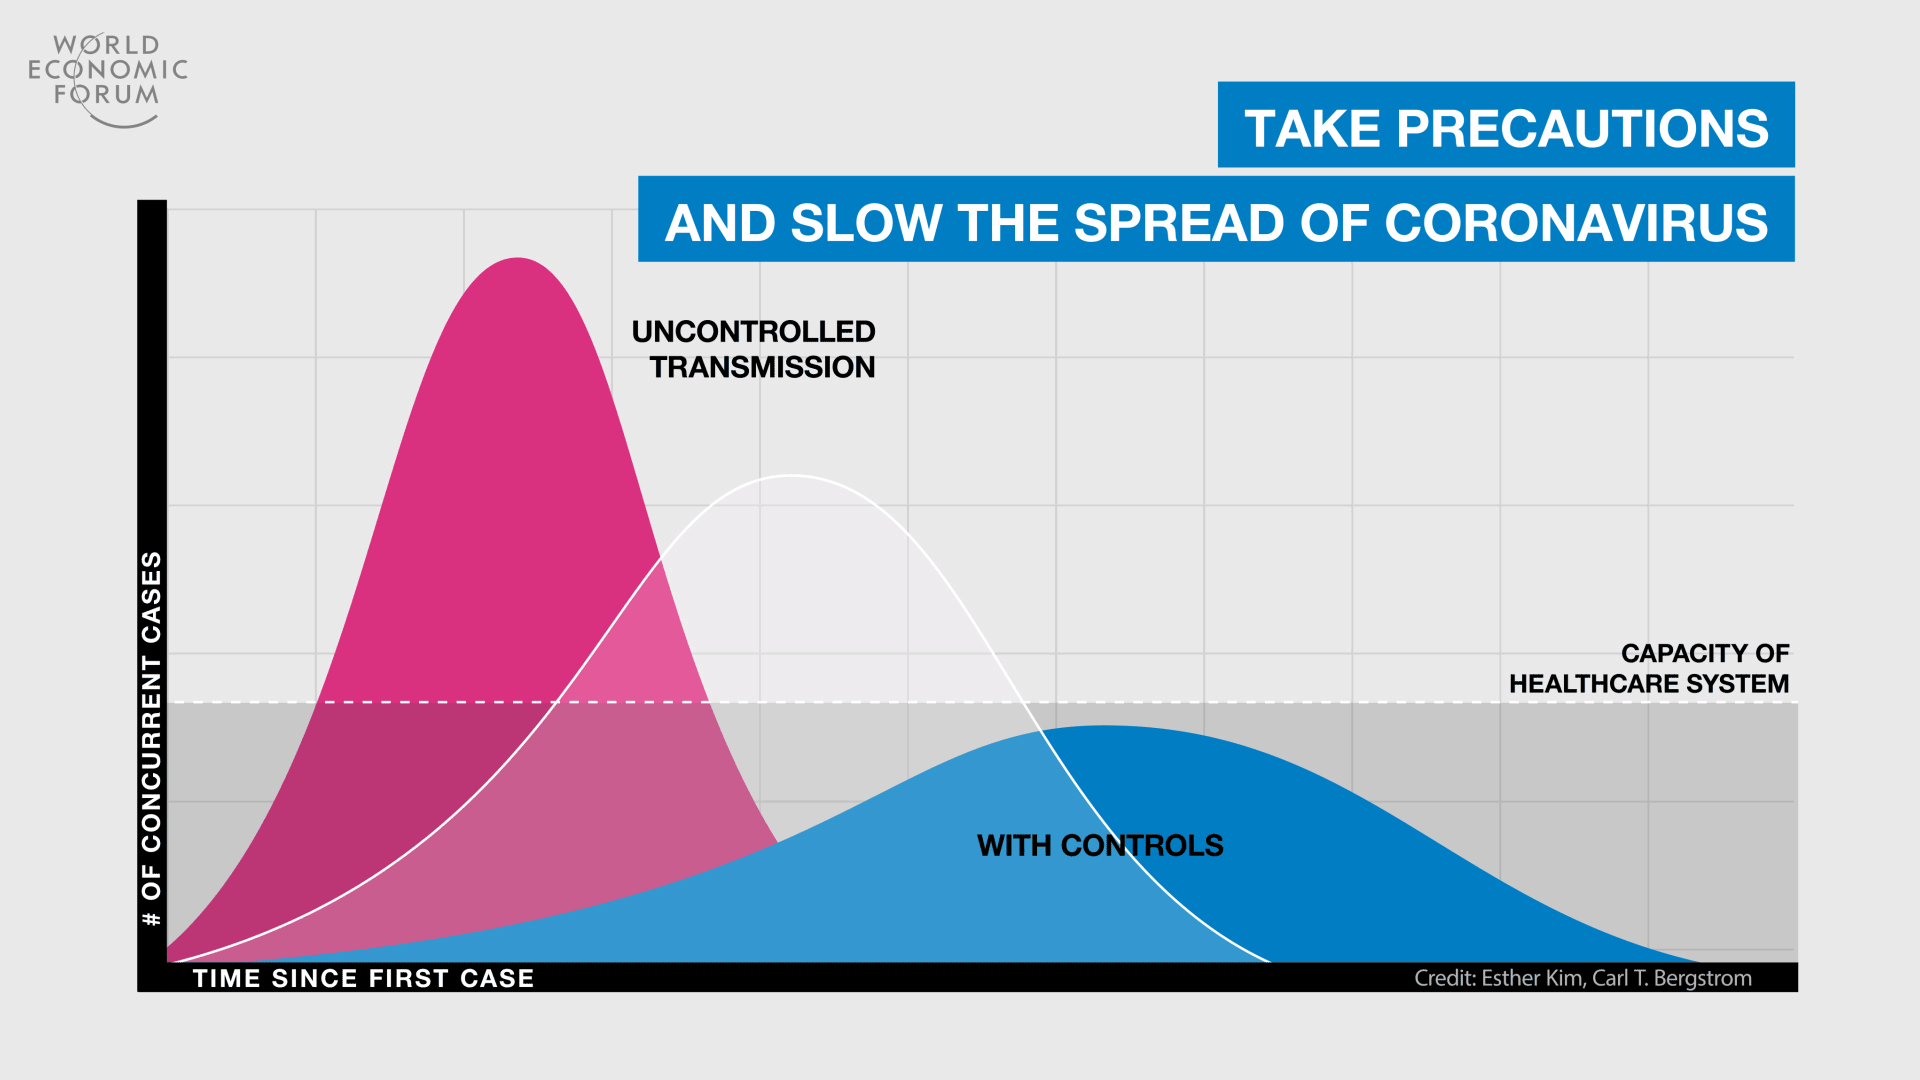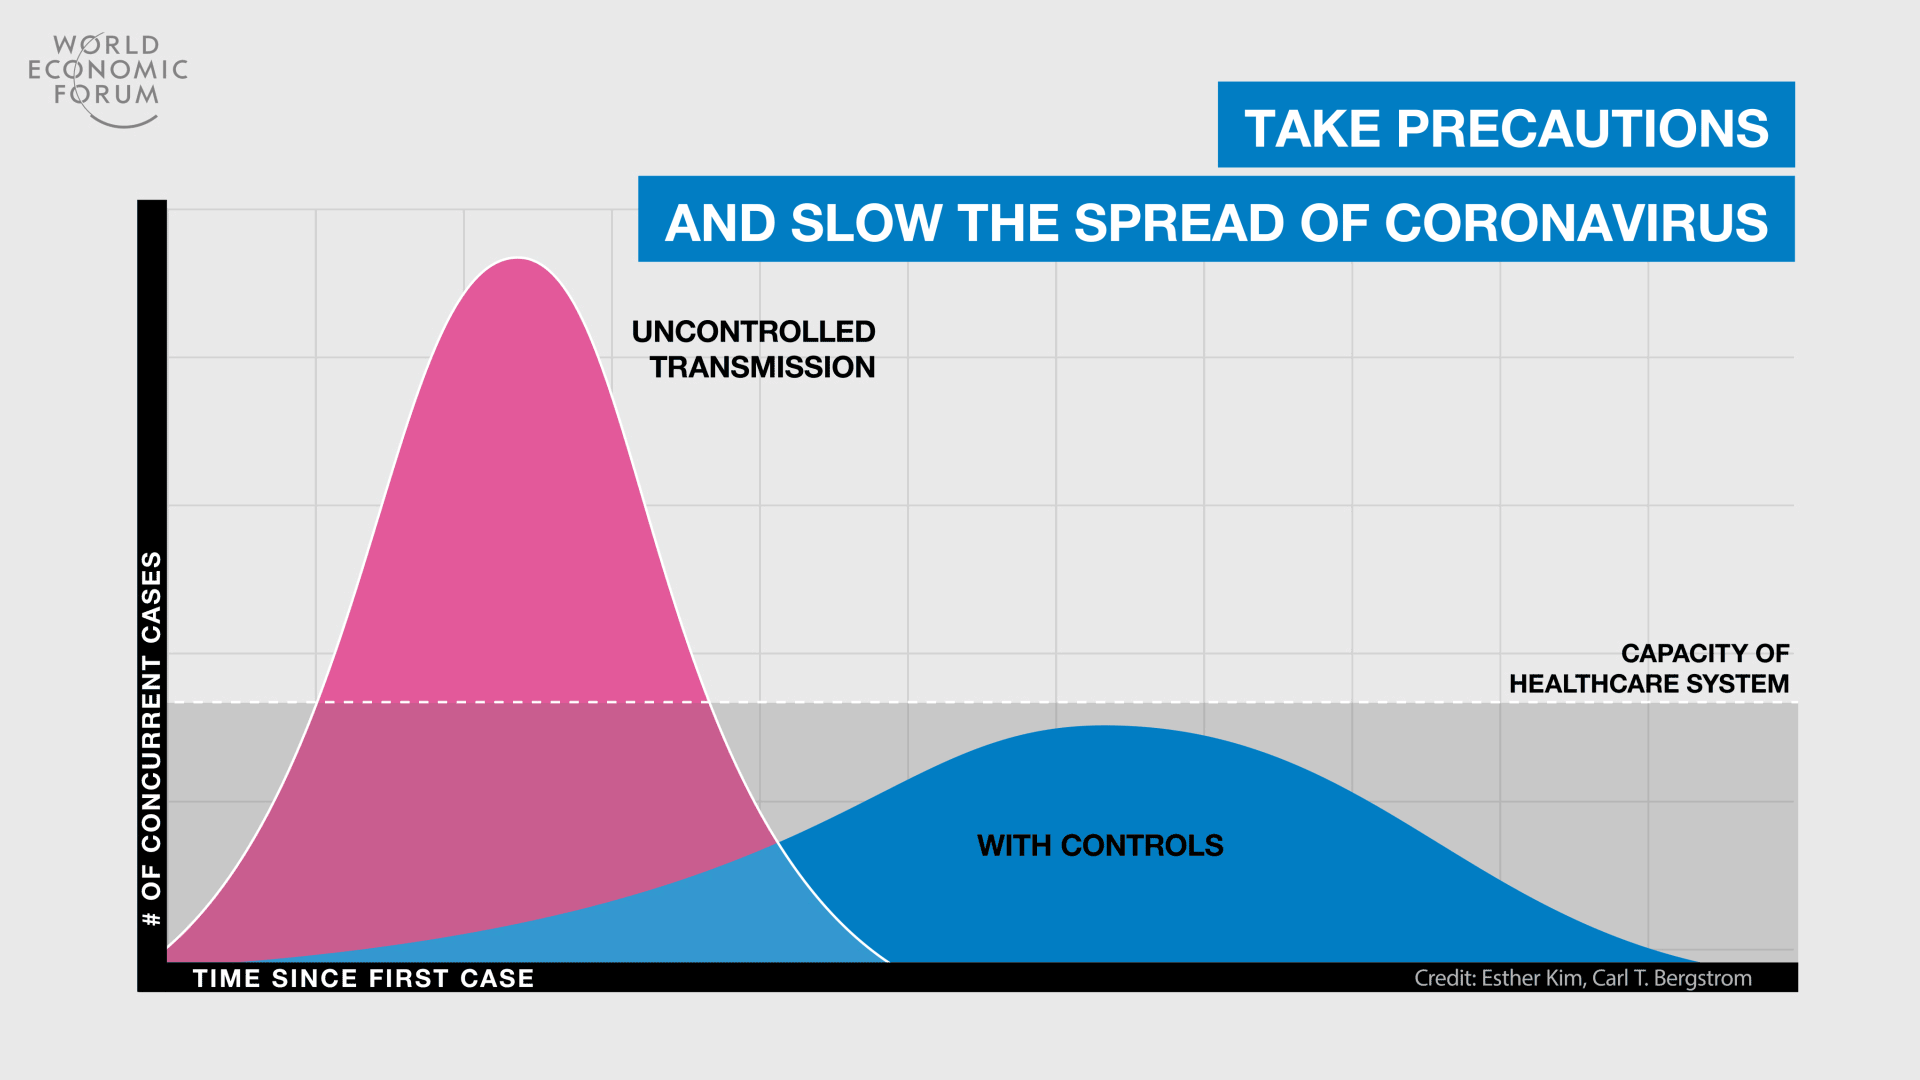
いくつかのモデルは有用であり、一部は行動を変えます。
わずか3か月で、特に政府関係者や政策立案者、そして市民を中心に、社会のすべての層の行動が劇的に変化しました。
保健当局と政策立案者は、COVID-19モデルの予測(その不確実性にかかわらず)に対応して、是正措置を講じました。コロナウイルス政府対応トラッカーはストリンジェンシー指数を公表しました。これは、学校や職場の閉鎖、公共イベントの中止、移動制限など、ウイルスへの対応として13の措置を調査したものであり、これらの措置は他の状況下では過酷とみなされるものです。
政府の介入に対して、市民の多くは規制を遵守し、行動を変えてきました。移動を控え、自宅に留まり、社会的距離を保ち、消毒への意識を高めています。また、購買行動も変化させています。実店舗に行くよりもオンラインで買い物をする割合が増え、社会的交流や娯楽の多くがオンラインに移行したため、通信帯域の消費量も増えています。
こうした行動の変化は、当然ながらCOVID-19の主要なパラメータに影響を与え、それによってデータも変化しています。
行動が変わると、新しいデータがモデルに勝ります。
市民は「自宅に留まる」よう、また「カーブを平らにする」よう促された結果、影響を受けた全ての国々でメディアがCOVID-19の感染、入院、死亡の曲線を増幅させました。行動の変化の結果、2種類のデータも変化しました。
症例データ。より多くの人々がウイルスについて知り、社会的距離を保つようにというメッセージを受け取るにつれ、安全上の警告を部分的または完全に無視したり、従ったりしました。個人の選択は、年齢、社会的価値観(権威への服従や自由主義)、そして働く必要に迫られる経済的事情など、さまざまな要因に左右されました。さらに、異なる国や米国の州で新規症例数と入院数が減少し始めました。これは死亡者数の減少という意図した効果をもたらしましたが、同時に、当初の予測が非現実的に悲観的(誤り)に見えるという皮肉な結果を生み、モデル開発者が批判にさらされることにもなりました。
失業データ。事業や学校の閉鎖といった介入は経済活動を停止させ、多くの商品やサービスに対する需要の大幅な減少をもたらしました。これにより、米国や他の国々では失業率が過去最高水準に上昇しました。これは1929年の大恐慌以来見られなかった数字です。これが今度は、経済を再開すべきだという声につながりました。経済活動を再開する必要はあるものの、その方法が、このパンデミックによって生じる死亡者総数に大きな影響を与える可能性が高いのです。
これらの介入の影響を受けて、国立アレルギー・感染症研究所所長のアンソニー・ファウチ博士は次のようにコメントしました「実際のデータが得られた時、私の考えでは、データは常にどのモデルにも勝ります。」
世界経済フォーラムは、コロナウイルスの流行に対して何をしているのでしょうか。
COVID-19モデルは、当初、利用可能なデータと、疾病の進行に関する前提に基づいて構築されます。これらのモデルは起こり得る結果の範囲を示し、政策立案者や市民の行動変容を促します。その結果、実際の死亡者数は当初の推計よりも大幅に少なくなっています。
モデルは死亡者数の減少という役割を果たしたため、成功例と見なされるべきです。
反事実的な問い――「もし何の対策も講じなかったとしたら、モデルはどれほど正確だったでしょうか」――は、理論上は答えることが可能です。しかし、その答えを追求するには、人命という観点であまりにも高いコストがかかります。




