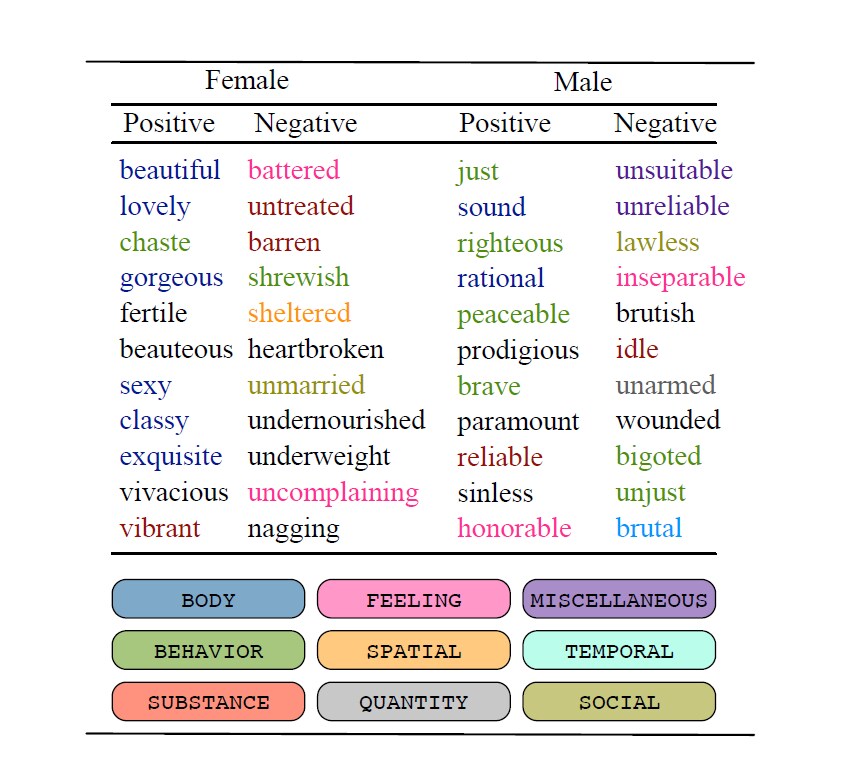
機械学習により350万冊の書籍を分析したところ、女性を形容する形容詞は身体的な外見を描写する傾向がある一方、行動に関する語は男性に割り当てられていることがわかった。
「美しい(Beautiful)」と「セクシーな(sexy)」は、女性を形容するために最も頻繁に使われる形容詞の2つである。男性に一般的に用いられる形容語には、「高潔な(righteous)」「理性的な(rational)」「勇敢な(courageous)」などがある。
研究者らは、文学において男性と女性を描写する語の種類に違いがあるかを明らかにするため、膨大な量の書籍を精査した。新しいコンピュータモデルを用いて、研究者らは1900年から2008年の間に英語で出版された350万冊の書籍からなるデータセットを分析した。これらの書籍には、フィクションとノンフィクションの両方が含まれている。
「女性について使われる語は、男性を描写する語よりも、外見をはるかに多く指していることが明確に見て取れる。このように、広く認識されていた見方を、今回初めて統計的なレベルで確認することができた」と、コペンハーゲン大学コンピュータサイエンス学科のコンピュータ科学者で准教授のイザベル・アウゲンシュタイン氏は述べている。
研究者らは、性別を示す名詞(例:「daughter(娘)」や「stewardess(客室乗務員)」)と関連する形容詞と動詞を抽出した。例えば、「sexy stewardess(セクシーな客室乗務員)」や「girls gossiping(噂話をする女の子たち)」といった組み合わせである。次に、各語が肯定的、否定的、または中立的な感情を帯びているかを分析し、その後、「behavior(行動)」「body(身体)」「feeling(感情)」「mind(精神)」などの意味カテゴリーに語を分類した。
このデータセットは、Google Ngram Corpusに基づいている。
110億語
分析の結果、身体や外見に関連する否定的な動詞は、女性の人物描写において男性の場合の5倍の頻度で現れることが示された。また、身体や外見に関連する肯定的および中立的な形容詞は、女性の人物描写において約2倍の頻度で出現する一方、男性の描写では、行動や人格的資質を指す形容詞が最も頻繁に用いられることも示された。
従来、言語学者は主に、より小規模なデータセットを用いてジェンダーに関連する言語とバイアスの広がりを検討してきた。現在では、コンピュータ科学者が機械学習アルゴリズムを用いて膨大なデータ(今回の場合は110億語)を分析することが可能になっている。
書籍の多くは数十年前に出版されたものであるが、それでも今なお重要な役割を果たしている、とアウゲンシュタイン氏は指摘する。機械や、人間の言語を理解できるアプリケーションを作り出すために使われるアルゴリズムには、オンラインで入手可能なテキスト資料の形式のデータが与えられている。スマートフォンが私たちの声を認識したり、Googleがキーワードの候補を提示したりできるのは、この技術によるものである。
なぜ形容詞がこれほど重要なのか。
「アルゴリズムはパターンを見つけ出すように動作し、そのパターンが観察されるたびに、何かが『真実』であると認識される。こうしたパターンのいずれかが偏った言葉遣いに関連していれば、その結果も偏ったものになる。いわば、システムは私たち人間が使う言語、ひいてはジェンダーに関する固定観念や偏見をそのまま取り入れてしまうのだ」とアウゲンシュタイン氏は述べる。そして重要になりうる例として、次のように述べている。「男性と女性を描写する際に使う言葉が、例えば従業員の推薦において異なっている場合、企業が応募書類を選別するためにITシステムを使用すると、誰に仕事が提示されるかに影響が及ぶだろう」。
人工知能や言語技術が社会全体でますます重要性を増す中、ジェンダーに関わる言語について意識することは重要である。
アウゲンシュタイン氏はさらに次のように続ける。「機械学習モデルを開発する際には、偏りの少ないテキストを使用するか、モデルに偏りを無視させるか、あるいは偏りを打ち消させるかによって、これを考慮に入れることができる。この3つの方法はいずれも可能である」。
研究者らは、本分析には限界があると指摘している。すなわち、個々の文章を誰が書いたのか、また、データセットの時間軸の中で、書籍が前半の時期に出版されたか後半の時期に出版されたかによってバイアスの程度がどのように異なるのかを考慮していない点である。さらに、ロマンス小説とノンフィクションなど、ジャンルの区別も行っていない。研究者らは現在、これらの項目のいくつかについて追跡調査を行っている。
本研究の追加の共著者は、メリーランド大学、Google Research、ジョンズ・ホプキンス大学、マサチューセッツ大学アマースト校、およびMicrosoft Researchに所属している。
研究者らは、論文を、計算言語学会の2019年年次総会で発表した。




