2017年、エコノミスト誌は、広く引用される記事を発表し、世界で最も価値のある資源の座を石油からデータが奪ったと主張した。具体的には、Google、Facebook、Amazonのようなテック企業がユーザーから収集したデータを指す。同記事は、データへのアクセスを民主化し、将来の破壊的イノベーターが市場に参入できる余地をつくるため、テック業界に特化した独占禁止法を求めた。エコノミスト誌は、FAANG(Facebook、Apple、Amazon、Netflix、Google)の巨大企業が膨大なデータを手中に収め、潜在的な競合が信頼できる脅威となる前、あるいはほんの一握りの人に知られる前のごく初期段階で、その存在を察知し、弱体化させられる未来を暗く描いた。
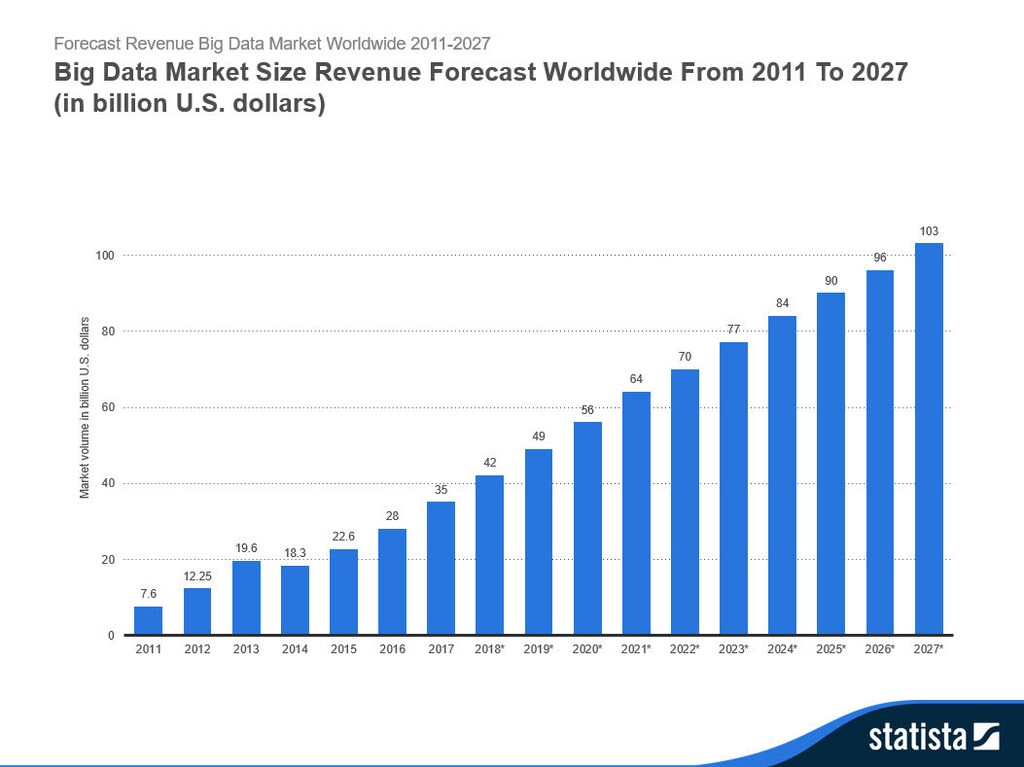
しかし、エコノミスト誌の記事が検討していないのは、テック大手が独占禁止法の対象になるかどうかにかかわらず、世界が生み出し、今後も指数関数的なペースで生み出し続けるデータの行方だ。少数の企業が握ろうと、競合する多数のテック企業が扱おうと、データがなくなることはない。私たちはデータを生み出し続け、テクノロジーはデータを分析して利益を得る能力を高め続けている。
ここ数十年、オンラインでのつながりを完全に断つのでなければ、私たちにはテック企業にデータを渡す以外に満足できる選択肢がなかった。データは、存在する場所がなければ、ただ「存在」することはできない。インターネットの登場以来、データが実際に保存される場所は、テック企業の集中型サーバーに限られてきた。しかし、その結果、データの価値と経済的な可能性は、主にこうした企業だけのものとなってきた。
データがますますあふれる未来に備えるには、データの捉え方と扱い方を変えなければならない。ブロックチェーン技術の普及と、医療やソーシャルメディアのようなデータ主導型産業への導入により、私たちは少しずつデータの管理権を取り戻せる。どの企業や組織が、オンラインデータ(つまりオンライン上のアイデンティティ)のどの部分にアクセスできるかを確認できるようになる。データがどう使われているかを把握し、それに応じて、さらなるアクセスを許可したり制限したりできるようになる。企業が私たちの情報を収集、研究、販売したい場合、サービスの利用権や金銭という形で対価を求める選択肢も得られる。結局のところ、企業はデータから巨額の利益を得ているのだ。
こうした機能が実現し、私たちが自分のデータを所有して収益化し始めると、「データ」の定義を見直す必要がある。データを捉える一つの方法は、石油などの商品と同じように、資産クラスと位置づけることだ。この記事では、データが資産クラスとなった世界がどのようなものかを探る。実行に移すかどうかは、私たちの判断にかかっている。
「情報についての情報」――「資産化」をめぐる議論
デジタル時代の幕開けに、インターネットの創始者ティム・バーナーズ=リーは、ウェブ上で取引が行われる世界を、情報を情報で買うことができる世界だと表現した。言い換えれば、あらゆるものがデータや情報として表現される。お金にもそれが見られ、私たちの世界を変えてきた。私たちの行動パターン、指の動き、好み、買い物の習慣、移動、好きなもの、政治的傾向がすべて記録され、広告という形で私たちに向け直されていることを、私たちは知っている。しかし、それはまだ氷山の一角にすぎない。ブロックチェーン技術は、資産の大規模なトークン化と移転の時代をもたらすだろう。日々取引されるデータは、指数関数的に増えていく。データを効率よく収集し、価値を評価する方法がなければ、データは使われないままになるか、私たちに不利益をもたらす形で利用される可能性が高い。
資産クラスとしてのデータを想像する
仮に今日、データを資産クラスとして分類し、取引できるとしたら、どのように機能するだろうか。一つの方法は、「データパケット」をつくることだ。つまり、業種、産業、行動、プラットフォームなどの分野ごとに整理した情報の集合である。こうしたデータの集合はモジュール化でき、本人が共有してもよいと考える情報や、市場がより価値があると判断する情報に応じて、組み替えたり、さらに細分化したりできる。たとえば、オンラインでの買い物情報を、食品、衣料品、サービス、イベントなどのカテゴリーに分けられる。個人は、それらすべてのパケットをまとめて、各カテゴリーにほぼ同じ金額を支払う可能性のあるウォルマートのような巨大企業に売ることもできる。一方、特定の衣料品小売業者が関心を持つのはオンラインでの衣料品購入データだけであり、その一つのデータパケットを買うために、より高い価格を支払うかもしれない。
データパケットの分類と構成の最適化が進めば、当然ながら、人々のデータを最も収益性の高い形に整理・選別するサービスから成る関連産業が生まれる。このモデルなら、人々は自分の経済観や個人的な信念に沿って選択できる。今日の市場インデックスファンドのように、幅広く分散し、小さいながらも安定したリターンを見込む、一般的で大枠のデータパケットを集めた大規模なポートフォリオをつくることもできる。一方、データのプライバシーを重視し、自分の生活に関する限られた情報だけなら共有してもよいという人は、共有する情報を限定したデータパケットを構成し、提供できる。
第三者によるこの「データパケット」産業の出現と成功に欠かせないのは、信頼である。この新たなデータサービス市場の消費者を、データが搾取的な業界に見られる現在と同じインセンティブ構造に従わせてはならない。こうした企業は、情報やユーザーの安全性や身元を損なわずに、パケットの構成サービスを提供できなければならない。
人々が対価を支払う企業にデータを売る仕組みについて考えるのも興味深い。たとえば、2010年から2015年までのオンラインでの買い物情報を企業に提供し、過去のデータを売ることができる。もちろん、その過去の期間にさかのぼって、自分のデータから一部の要素を削除できるかという問題も考える必要がある。特定の過去の活動を削除して「改変」されたデータに企業が対価を支払った場合、それは消費者行動を正しく反映したものであり、提示価格に見合うのだろうか。企業には、データパケットから情報が削除されたかどうかを判断する権利があるのだろうか。また、編集されたユーザーデータに対して、より低い金額を支払う権利があるのだろうか。
ユーザーは継続的に対価を受け取り、特定のライフスタイルデータを、それに対価を支払う意思のある企業や企業グループに提供することもできる。この継続的な関係は、いつでも法的に解消できる。ユーザーが特定の情報をもう提供したくないと判断する場合もあれば、企業が特定のデータへの支払いをやめると判断する場合もある。別の選択肢として、企業と消費者が契約を結ぶ方法もある。より高い価格を得られる可能性のある取り決めだ。ユーザーは、合意した一連のデータを、たとえば今後3年間、企業に売ることに同意できる。理論上、どちらの当事者もその契約を法的に破棄できないため、一定期間にわたり確実で安定した副収入をユーザーにもたらす可能性がある。契約の解除を認める「ライフイベント」という考え方も検討に値する。たとえば、病気になった場合、消費習慣が変わり、特定の病気の患者だと容易に特定されてしまうかもしれない。特定の病気など、一定のライフイベントが起きた場合にユーザーが契約を解除できる条項を盛り込むこともできる。
データの資産化と収益化を考えるうえで、独占権も興味深い思考実験となる。自由で、世界規模、国境がなく、24時間週7日取引できる流動性の高いデータ市場では、企業は複数の競合他社とデータを共有するのではなく、ユーザーのデータを独占的に受け取るために追加料金を支払うだろう。前述の第三者データサービス企業は、ユーザーが生み出すオンラインデータの量と重要性を「価値」として、そのユーザーを価値の高い個人と判定し、過去分、継続提供、または契約という形で企業に独占権を提案するよう促すことができる。ユーザーは、より多くの買い手にデータを売ることも選べる。データパケットごとの収入は減るかもしれないが、購入を希望する企業が多ければ、全体としてより多くの収入を得られる可能性がある。
データの資産化に伴う課題
ブロックチェーンで表現されたデータの資産化に賛成するかどうかにかかわらず、それを成功させ、管理可能で、分散型かつ公平なものにするには、大きな課題がある。
• 技術開発:ブロックチェーン技術は今も改良と開発が続いているが、データの資産化のような、より専門的で抽象的な用途の多くでは、まだ初期段階にある。拡張性、プライベート型とパブリック型の選択、相互運用性、プライバシーをめぐって業界全体で議論が続くなか、ブロックチェーン上のアイデンティティ、つまり自分のデータを自分のアイデンティティに安全かつ確実に結びつけられるかという問題は、データを資産とみなす問いに固有の課題である。
• ユーザー体験:今日のWeb3ユーザー体験(UX)は、主にゲーム業界で受け入れられている。ゲームは、ユーザーに求める信頼の度合いが低く、リスクも小さいエコシステムだ。一方、人々のお金、情報、アイデンティティを扱うブロックチェーンアプリケーションは、今も主にWeb2型の仕組みで構築された企業を介して提供されており、人々はそうした企業のほうが安心して信頼できると感じている。UXの観点からは、これは理にかなっている。新規ユーザーであれ、経験豊富なWeb3ユーザーであれ、ウォレットアドレス、秘密鍵、シードフレーズの大量管理と、それに伴うあらゆるリスクを求めれば、企業はユーザーを失うに違いない。しかし、やがてインターネットは段階的に分散化していく必要があり、ユーザーがトークンのように単純なものから、ユーザーデータの「パケット」のように曖昧なものまで、自信を持って取引できるよう、UXの革新も歩調を合わせなければならない。
• 価値評価:データを資産とみなすには、行動、産業、ライフスタイルなどに関係する関連データを、識別可能で価値のある「パケット」にまとめる必要がある。パケットの価値をどう評価するかは、機械学習と企業の利益戦略にかかわる問題となる。同じオンライン行動に関するデータであっても、ある人のデータパケットが別の人のものより価値が高いかどうかを、どう判断すればよいのだろうか。データの量と質はどう評価するのか。データパケットの価値を決めるのは、第三者企業、規制当局、データの所有者、それともデータの販売者なのか。データパケットの市場はどのようなものになるのか。企業ではなく個人が自分のデータを所有するなら、自分のFacebookのトラフィック情報をTwitterに売れるのだろうか。データの資産化に伴い、関連産業が台頭すると考えられる。こうしたサービスは、市場の既存の動向を踏まえ、第三者自身が個人を特定できない安全な方法で、アルゴリズムを使って人々の情報を最も収益性の高いデータ構成に整理するだろう。第三者がデータパケットの収益の一部を受け取るのは妥当かもしれないが、ユーザーデータの内容を見ることはできないはずだ。そうでなければ、第三者が自らの利益のためにデータを収集する振り出しに戻ってしまう。
• データ学習技術:データの価値評価の課題と並んで、AIや機械学習を用いてデータを適切に分析、整理し、価値を評価する必要もある。オンラインのトラフィックから生み出されるデータの大半は「ノイズ」であり、テック企業はシグナルとノイズを分けることで築かれてきた。機械学習技術が向上すれば、より多くのデータを有用な情報に統合でき、消費者と企業の双方に、より大きな経済的機会をもたらす。
• 規制:規制当局が、この新しい技術とそれによって可能になるユースケース(特に分散型の金融行動)にどう対処するかを議論し、決定するなか、ブロックチェーンのエコシステム全体は、いわば息を潜めている。良くも悪くも、規制は民間の技術革新に一歩遅れてきた。では、今データを資産クラスと決めたとして、法的にも資産クラスとなり得るのだろうか。広く認識されている5つの資産クラス、すなわち商品、不動産、債券、株式、現金のうち、個人のデジタル情報はどこに位置づけられるべきだろうか。効用のある「財」の所有権という意味での商品、あるいは、データという形で企業などに資金を貸し付ける債券に当たるという議論もできる。あるいは、新たな資産クラスを設ける必要があるかもしれない。不動産は「物理的空間の所有権」と定義される。おそらく、「デジタル空間の所有権」と定義されるデジタル資産クラスが必要だ。規制の行方がどうなるにせよ、企業は規制当局に判断を求める前に、まず実現可能な解決策を生み出し、どのような選択肢があるのかを示す必要がある。
今後の展望
ブロックチェーン技術を応用した仕組みによって、データは徐々に、それを生み出す人々の手に戻っていくだろう。企業はデータへのアクセスを得るため、別のインセンティブの仕組みをつくらなければならない。それにより、個人情報の倫理的で、本人の許可を得た、公平な利用について、市場の説明責任を大きく高められる。経済モデルを再構築するには時間がかかるが、ブロックチェーンによって可能になる新たな金融行動を既存の金融システムに統合できれば、普及を加速できる。データを資産クラスに分類することは、その実現につながり、インターネットとの関係をより公平で、私たちの力を高めるものにする一歩となる。




