人工知能(AI)は、性能を低下させコストを押し上げ、ひいては進歩を制約する「メモリの壁」にぶつかっています。
メモリと処理が分かれている従来のコンピュータアーキテクチャは、AIの急速な成長に直面して非効率になりつつあります。
AIのボトルネックに対処する代替モデルには、メモリ内演算システム、脳に着想を得たスパイキングニューラルネットワーク、イベントベースのセンサー、低精度または近似演算の活用などが含まれる可能性があります。
人工知能(AI)は物理的なボトルネックに直面しています。モデルが大規模化・複雑化するにつれ、情報を保存するメモリと計算を行うプロセッサの間でデータを移動させることに費やされる時間とエネルギーの割合が増加しています。
しばしば「メモリの壁」と呼ばれるこの負担は、深刻な制約となりつつあります。圧力は急速に高まっており、言語処理モデルは4年間でサイズが5,000倍に拡大しました。
メモリの壁の問題が重要である理由は2つあります。
第一に、大規模AIシステムのエネルギー需要が急速に増加しており、その学習と運用に必要なコストやインフラの負担が増大しています。
第二に、AIの多くの有用な用途は、クラウドではなくエッジデバイス上でローカルに行われる迅速な判断に依存しており、その環境では電力、サイズ、接続性、遅延のすべてが重要になります。
医療機器、自動運転車、救助用ドローンは、情報を遠くのデータセンターに送信して処理を待ち、応答を受け取ることに常に頼れるわけではありません。代わりに、デバイス上でのAIをより実用的にするハードウェアが必要となることが多いのです。
「Frontiers in Science」で述べたように、このボトルネックを緩和するための主な方法は3つあります。すなわち、計算をデータに近づけること、脳のイベント駆動型の情報処理方式を取り入れること、そして厳密な演算が不要な場面では低精度または確率的な計算を用いることです。
これらのアプローチを組み合わせることで、より高速で、より効率的で、大規模インフラやエッジ用途により適した新世代のAIハードウェアを支えられる可能性があります。
AIのメモリの壁を打ち破る3つの新しいアプローチ
1. 計算をメモリに持ち込む
現在でも多くのコンピュータは、メモリと処理が物理的に分離している、長年確立されたフォン・ノイマン型アーキテクチャを採用しています。単純な演算を行う場合でも、データはメモリから読み出され、別個の演算装置で処理され、再びメモリに書き戻される必要があります。
この繰り返されるデータのやり取りは、AIにとっては高コストになります。AIは膨大な数のパラメータや中間値に依存しており、それらに繰り返しアクセスする必要があるためです。
その対策の一つがメモリ内演算です。これは、計算が必要になるたびにデータを別個の演算装置へ移動させるのではなく、メモリアレイ内またはそのごく近傍で演算を実行する方式です。データのやり取りが減ることで、AIシステムの規模が拡大する中で遅延とエネルギー使用の削減に役立つ可能性があります。
メモリ内演算に唯一の決まったハードウェアの手法があるわけではありません。速度、精度、集積密度、エネルギー効率においてそれぞれトレードオフを伴う、さまざまなアプローチが存在します。より広く言えば、将来のAIハードウェアは、従来のシステムが提供するように設計されているものよりも、記憶と演算のより密接な統合を必要とするということです。
2. 脳のタイミングに学ぶ
2つ目の方向性は、情報の処理方法を変えることです。多くのAIシステムは、入力信号が変化したかどうかにかかわらず、各ステップで大量の計算を行いながら入力を連続的に処理する人工ニューラルネットワークに依存しています。
生物の脳は異なる仕組みで動作します。ニューロンは通常静かで、報告すべきことがあるときにのみ主に発火します。
脳のタイミングに基づく戦略は、離散的な「スパイク」またはイベントを通じて情報を表現するスパイキングニューラルネットワークに着想を与えてきました。これは、計算を入力の変化によって駆動できることを意味し、変化が少なければ処理が必要な量も少なくて済む可能性があるということです。
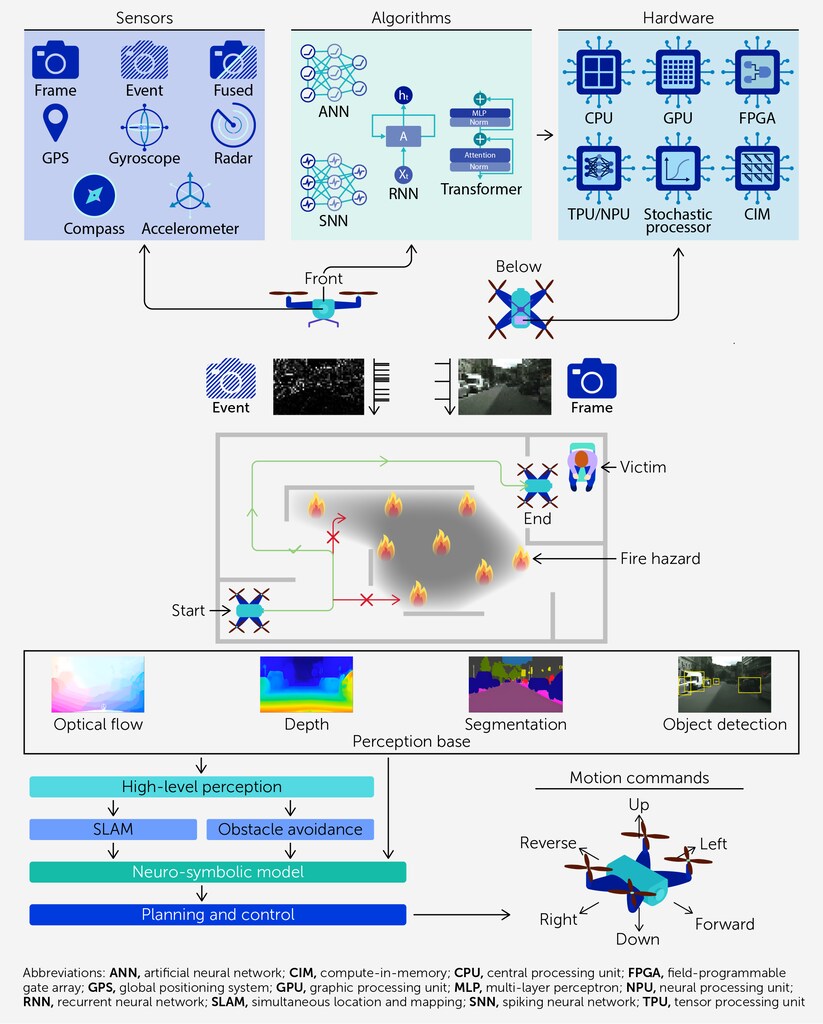
これらのニューラルネットワークは、イベントベースのセンサーと組み合わせると特に有用になり得ます。従来のカメラは一定間隔で画像フレームを撮影するため、多くの反復的な視覚情報が生じます。
対照的に、イベントベースのカメラは、動きや明るさの変化などの画素レベルの変化のみを記録するため、はるかに軽量なデータストリームが得られます。こうしたデバイスには、画像全体を繰り返し解析するのではなく、変化が発生した時点でそれを処理できるハードウェアとアルゴリズムが必要です。
エッジAIにとって、この組み合わせは魅力的です。煙、瓦礫、不安定な地形の中を飛行する捜索救助ドローンは、限られたバッテリー電力で、リアルタイムに動きを検知し、障害物を回避し、進路を調整する必要があるかもしれません。
その情報をクラウドに送信すると、特に接続が不安定な場合には応答が遅れる可能性があります。このような環境では、脳に着想を得た処理によって不要な計算を減らし、センシングと意思決定をローカルに保つことができます。
3. 最も重要な箇所で精度を活用する
3つ目の戦略は、すべてのAI計算に同じレベルの精度が必要なわけではないと認識することです。多くのモデルは、全体的な性能を大きく損なうことなく、わずかな数値誤差、近似値、ある程度のハードウェアノイズを許容できます。
小さな誤差を許容できることで、確率的または近似的なハードウェアの余地が生まれます。実際には、低い数値精度を用いること、特定の演算に制御された変動を許容すること、あるいは厳密な演算を引き換えに消費電力を抑える回路を設計することを意味し得ます。
目的は、精度をニーズに合わせることです。そのバランスを慎重に選べば、ハードウェアは電力とチップ資源の使用を抑えつつ、アプリケーションの精度要件を満たすことができます。
確率的・近似的なアプローチは、自動運転車、移動ロボット、ウェアラブル機器など、適応型かつリアルタイムのシステムに特に関連性があります。そこでは、あらゆる段階で最大の数値精度を求めるよりも、迅速な応答と効率的な動作が重要になる場合があります。
システム全体の共同設計
これら3つの方向性は、単一の設計課題の一部として扱われたときに最も効果を発揮します。将来のAIハードウェアは、チップを単独で設計し、後からアルゴリズムを無理に当てはめるという方法では開発できません。アーキテクチャ、メモリ、精度の戦略、センサー、学習モデルは、互いに影響し合いながら形作られていきます。
そのため、ハードウェアとアルゴリズムの共同設計が非常に重要になりつつあります。ワークロードによっては、メモリ内演算から最も恩恵を受けるものもあれば、スパイキングネットワークやイベントベースのセンシングから恩恵を受けるものもあり、さらに混合精度や確率的手法に依存するものもあるかもしれません。多くの場合、最良の解決策は、これらのアプローチを同じプラットフォーム上で組み合わせることかもしれません。
より大きな意味合いとしては、AIの未来はモデル設計と同じくらいハードウェア設計にも左右されるということです。より効率的なAIハードウェアは、大規模システムの増大する資源需要を抑えるとともに、現場に配備されるデバイスの安全性と信頼性を向上させることにつながり得ます。
これは、医療や交通から緊急対応や産業オートメーションに至るまで、各分野におけるコスト、インフラ、レジリエンス、アクセスにも影響を及ぼします。
AIが、エネルギーとハードウェアの負担を並行して増大させることなく世界経済全体へ普及し続けるためには、メモリの壁を打ち破ることが不可欠になるでしょう。次の飛躍は、ますます大規模なモデルを構築することよりも、それらを動かすためのより優れた機械を構築することから生まれるかもしれません。




