組織が人工知能(AI)エージェントの導入を進めるにつれ、その役割を適切に定義し、安全対策と監督の仕組みを整えることが求められます。
最近の研究では、AIエージェントの評価と導入に向けた体系的なアプローチの基盤となる4つの柱が示されています。
このアプローチは、AIエージェントの能力が向上しても、組織がそれらを責任ある形で引き続き導くのに役立ちます。
人工知能(AI)エージェントは、実験的な試作段階から、企業、公共サービス、日常生活において統合された協働者へと急速に移行しつつあります。これらのAIを活用したシステムは、情報を自律的に解釈し、意思決定を行い、特定の目標を達成するための行動を実行できるように構築することが可能です。今後数年間、より高度なシステムが引き続き登場し、人々、企業、社会に影響を及ぼしていくでしょう。
組織がチームを補完するためにAIエージェントを導入したり、物理的な世界で行動させたりする場合、新入社員と同じ厳格さでオンボーディングを行うべきです。これには、明確に定義された役割、安全対策、体系的な監督の仕組みの整備が含まれます。
ホワイトペーパー『AIエージェントの実践:評価とガバナンスの基盤』は、世界経済フォーラムの「安全なシステムと技術」ワーキンググループがCapgeminiと協力して作成したもので、AIエージェントの責任ある導入に向けた新たな基盤を概説しています。同書では、AIエージェントの評価と導入に向けた体系的なアプローチを提供する4つの柱を紹介しています。
1. 分類
エージェント分類に対する体系的なアプローチ は、意思決定者がエージェントの役割、動作の仕方、そして稼働すべき条件を明確に把握するのに役立ちます。エージェントカード(AIエージェントの「履歴書」とも言えるもの)は、エージェントが組織に「オンボーディング」され統合される前に、その能力に関する重要な情報を提供することができます。
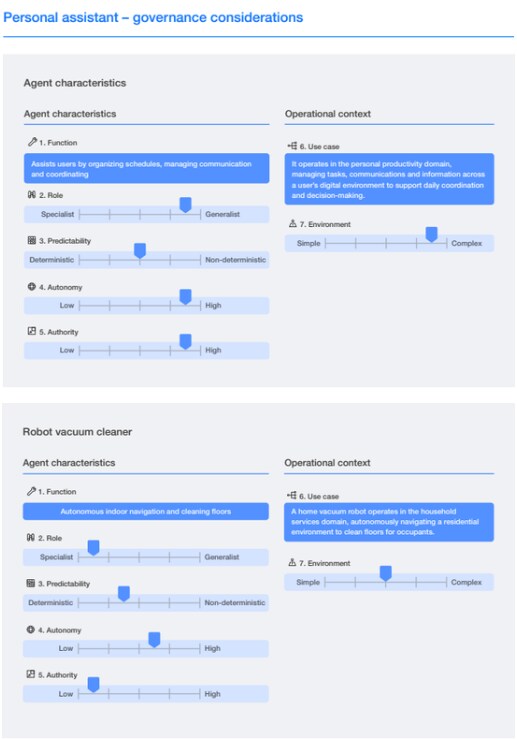
エージェントのプロファイルは、次の7つの主要な側面によって定義されるべきです:
機能:エージェントはどのタスクを実行するように設計されているか?
役割:高度に専門化されているか、それとも汎用型か?
予測可能性:決定論的か、それとも非決定論的か?
自律性:どの程度まで、独立して計画、判断、行動できるか?
権限:どのような許可やシステムへのアクセス権が付与されているか?
ユースケース:どの分野またはワークフローに配備されているか?
環境:稼働環境はどの程度単純または複雑か?
これらの側面を組み合わせることで、エージェントの行動面および運用面に関する理解が得られます。これは、リスクの評価、監督レベルの設定、そして提供者、導入者、エンドユーザー間での期待の共有にとって極めて重要です。
自律性の概念は、従来の自動化の形態とは大きく異なります。重要な違いは、自律性が意思決定の柔軟性、すなわち何をするかを選択することを伴うのに対し、自動化は実行の信頼性、すなわちシステムがプログラムされた通りに実行することを重視する点です。自律性と権限は、システムに本質的に備わった特性として扱うべきではなく、エージェントの意図された機能、リスクに関する考慮事項、監督要件に基づいて行える設計上の選択として扱うべきです。
例えば、ロボット掃除機は権限が低く、自律性は中程度で、比較的単純な環境で動作します。一方、パーソナルデジタルアシスタントは複数のシステムにまたがり、プラットフォーム横断で機密データにアクセスし、ユーザーの代わりに行動を実行することがあり得ます。そのため、パーソナルアシスタントにははるかに厳格な精査が必要です:
2. 評価
組織が異なる機能的役割を持つエージェントの導入を開始するにつれ、体系的な評価がますます重要になります。従来のAI評価は、管理された状況下での正確性や推論能力をテストする、モデル中心のベンチマークに大きく依存してきました。しかし、エージェントは静的なモデルではありません。エージェントは、1つ以上のモデルに加え、ツール、メモリ、フィードバックループ、ユーザーとのやり取りによって構成されるシステムであり、さまざまな環境の中で動作します。
したがって、AIエージェントを評価することは、タスクの成功率、ツール利用の信頼性、性能、時間経過に伴う挙動、ユーザーの信頼性と相互作用のパターン、そして実際のワークフロー全体における運用上の堅牢性といった側面を検証することを意味します。
『AgentBench』や『SWE-bench』のような新たなベンチマークは初期の指標を提供しますが、真の保証は文脈に即した評価から得られます。これは、実際の導入条件を再現した環境でエージェントをテストすることを意味します。そのため、開発者(システムに関するノウハウを持つ)と導入者(運用文脈に関連するデータと専門知識を持つ)は、正確で信頼性の高い文脈内評価を確保するために、緊密に協力する必要があることが多いのです。
3. リスク評価
評価が証拠を提供する一方で、リスク評価は、その証拠が安全性と適合性にとって何を意味するかを判断します。一般に、5段階のリスク評価ライフサイクルは、状況の定義、関連リスクの特定、分析、評価、管理へと進みます。
このアプローチは、分類と評価をガバナンスに直接結び付けるものです。例えば、複雑な環境における権限と自律性の高いエージェントには、より多くの安全対策が必要です。非決定論的な挙動には、より厳格な監視を組み合わせる必要もあります。また、外部システムとやり取りするエージェントは、その統合によって攻撃対象領域が拡大するため、ゼロトラストのセキュリティ前提の下で運用されなければなりません。
エージェントが組織の境界を越えて動作し、外部ツールを呼び出し、相互運用プロトコルを通じて他のエージェントと協働する機会が増えるにつれ、この体系的なアプローチは不可欠です。

4. 段階的ガバナンス
評価とリスク評価は、エージェントの能力、性能、信頼性、セキュリティ、安全性、整合性に関する重要な知見をもたらします。一方、ガバナンスは、それらの知見が効果的な監督と責任ある導入へと結び付くかどうかを決定します。
同ホワイトペーパーは、エージェント監督に対する段階的なアプローチを概説しており、その出発点は次の基本要件です。 すべてのエージェントに共通する基本要件には、ロギングとトレーサビリティ、すべてのエージェントの行動に対する明確な識別タグ付け、そしてリアルタイム監視(エージェントがエージェントを監視することへの依存が高まっている)が含まれます。
段階的なガバナンスのアプローチにより、より高度なエージェントには比例的な監督が確保されると同時に、時間の経過とともに拡張していく中でも、イノベーションと柔軟性を実現できます。
マルチエージェントAIエコシステムの構築
AIエージェントの次のフロンティアは、組織内における個々のエージェントの統合にとどまりません。ネットワーク、プラットフォーム、組織をまたいで相互作用するエージェントのエコシステムが出現しつつあります。したがって、今日からエージェントの導入と展開を始める組織は、次のような課題を検討すべきです:
オーケストレーションのずれ:共有された文脈や調整ロジックを伴わずにエージェントが他のエージェントに接続されると、ワークフローが脆弱になったり、予測不能になったりする可能性があります。
意味の不整合:2つのエージェントが同じ指示を異なるように解釈すると、相反する行動や作業の重複を招く可能性があり、安全性、信頼性、調整に影響を及ぼします。
セキュリティと信頼のギャップ:共有された信頼の枠組みがなければ、エージェントは意図せず機密データを露出させたり、システムの脆弱性を悪用する悪意のある主体と相互作用したりする可能性があります。
相互接続性と連鎖的影響:密接に連携したエージェントやシステムに障害が発生すると、ネットワーク全体に波及し、連鎖的な混乱を引き起こす可能性があります。
システム的な複雑性:相互作用するエージェントの数と多様性が増すにつれ、創発的な挙動や連鎖的な障害が発生する可能性が高まり、それらを予測、追跡、診断することがより困難になります。
こうした新たな課題があるため、先を見据えた監督と段階的なガバナンスが不可欠となります。監査エージェントの活用のような新たなアプローチは、エージェントのエコシステムを大規模に監視、検証、規制するのに役立ちます。しかし、それらは新たな脆弱性も生み出し、その中には、他のエージェントを監視するためにエージェントに依存するリスクも含まれます。
AIエージェントを責任をもって展開するための計画
AIエージェントは、研究開発の加速から顧客サービス、複雑な業務の管理に至るまで、既に各業界で価値を生み出しています。しかし、その能力が高まるにつれ、組織がそれらを責任をもって導く能力も高める必要があります。
ホワイトペーパーで紹介されている、分類、評価、リスク評価、段階的ガバナンスに関する基盤は、エージェント時代に備える組織にとって、体系的な青写真を提供します。慎重な設計、比例的な安全対策、部門横断的な協働があれば、AIエージェントは人間の能力を増幅し、生産性を引き出し、信頼性が高く影響力の大きいデジタルエコシステムを支えることができます。
しかし、AIエージェントの導入と活用による長期的な成功は、理解可能で、信頼でき、説明責任を果たせるシステムの構築にかかっています。これらのシステムは、長期的な価値創出のための共有ツールとして構築されなければなりません。




