私たちは毎日、2.5クインティリオンバイトのデータを生み出しています。適切に整理・分析されれば、この情報はすべての人にとってより良い未来を創り出す力を持ちます。ビッグデータは、資源を最も必要な場所に配分する前に、正確に検知することができます。地震、洪水、飢饉。オープンデータは、教育、医療、金融サービスへのアクセスを改善する可能性を秘めています。
このような可能性がある一方で、データセットは人間の設計の産物です。不完全な作成者の欠点、嗜好、経験を映し出すものなのです。ほぼすべてのデータは、何を含めるかについてしばしば価値判断を行う人間によって定義、解釈、操作されています。したがって、データセットから除外された要素を理解することは、データそのものと同じくらい重要なのです。
人間である私たちは、確証バイアスに悩まされています。これは、既存の見解を強化する形で情報を探したり解釈したりする一方、矛盾する証拠を無視する傾向を指します。良い例が2016年の米国大統領選挙です。ほとんどの世論調査機関は、ドナルド・トランプの勝利を予測できませんでした。投票日当日、データに基づくとトランプ氏の当選確率は15%とされていました。しかし専門家たちは、次の多くの点を見落としていました。投票率モデルの不正確さ、世論調査における大卒者の過大代表、接触が困難な層の影響、そして見知らぬ人に対する有権者の正直さです。こうした見落としは、より多くのデータにアクセスすることで防げるものではなく、むしろ、誰もが自分たちと同じように考え行動していると錯覚させるフィルターバブルを打ち破ることによってのみ防ぐことができるのです。
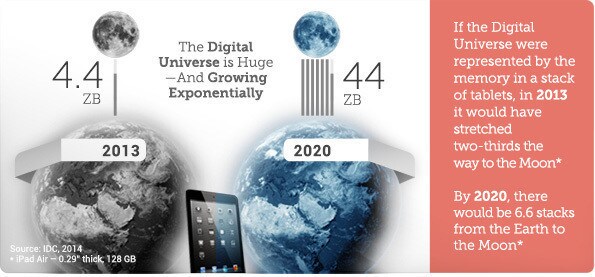
同時に、より多くのデータが、過去5,000年の人類の歴史で作られたデータよりも、この2年間に作られています。このような新しい情報の加速的な流れにより、私たちは「利用可能性ヒューリスティック」への依存を強めています。これは、利用可能な最新の情報に基づいて意思決定を行う傾向のことです。ほとんどの政府、エコノミスト、ジャーナリストは、2007~08年の金融危機を予見できませんでした。当時主流だった数理モデルが景気後退を示唆しなかったためです。もし彼らが最新データにあまり注目せず、金融市場の循環的な性質にもっと注目していたならば、と悔やまれます。
同様に、特定の個人、集団、国については、他よりもはるかに多くのデータが存在します。これにより、特に先進国と発展途上国の間で、データ格差が生じています。もし私がデータだけを頼りにするならば、ザグロス山脈にいる私の家族は実在しないと判断されてしまうでしょう。単純に、彼らはインターネットにアクセスできず、これまで一度もアンケートに答えたことがないからです。データセットにおける言語、文化、地域の過小代表は、歪んだ語りと現実の歪曲した描写を生み出します。
さらに事態を悪化させるのは、過去が未来の悪い指標であることが多いという点です。既知の変数、一定性、論理に依拠する既存のシステムを用いて、情報がほとんど存在しない場所で情報を生み出そうとしても、ほとんど意味がありません。確率論の教授であるナシーム・ニコラス・タレブは、著書『ブラック・スワン』の中で、このような不確実性を取り上げています。ブラック・スワンとは、予想の範囲外にある異常値であり、発生確率は低いものの、歴史の流れを根本的に変えるものです。最も興味深いことに、ブラック・スワンは、十分なデータが得られた後になって、後知恵によってしばしば合理化されます。私たちはランダム性に満ち、不確実性、ばらつき、偶然が支配する世界に生きています。そのような状況では、データにできることには限界があります。
データが測定できるのは、測定可能なものだけです。測定できないものについてはどうでしょうか。0と1の二値では、人間という存在の複雑で、しばしば非合理的な現実を捉えることはできません。愛、親切、幸福を確実に数値化できるでしょうか。社会学者のウィリアム・ブルース・キャメロンは次のように述べています。「数えられるすべてのものが重要なわけではなく、重要なすべてのものが数えられるわけでもない」。指標への執着は、数量化バイアスへと行き着きました。すなわち、何よりも数字を崇拝することです。たとえデータが100%正確であったとしても、わかるのは何が起きているかだけで、なぜ起きているかはわかりません。人間的な理解の層がなければ、データは文脈やニュアンスを欠いたものになります。数字が意味を持つのは、その背後にある人間の感情、行動、動機を発見して初めてなのです。
紙の上では、データはより情報に通じ、つながりがあり、包摂的な社会を生み出すことを約束しています。しかし、先に指摘したように、私たちの思考体系は脆弱で、偏りの影響を受けやすいものです。私たちはデータを、人間の影響から独立した客観的な真実であると考えがちです。実際には、データは私たちの人間の偏見がアルゴリズムへと延長されたものです。第四次産業革命に突入するにあたり、情報の増殖と AI の指数関数的な台頭により、技術は人間の思考を強化するため、より公平な社会を設計する機会を私たちは手にしています。
「善のための」データには、技術の急進的な進歩を反映した新たな議論、斬新な発想、そして新たな社会契約が必要です。何よりも、データは地球上に暮らす76億人すべての多様な見解とニーズを反映し、代表するものでなければなりません。究極的には、人類文明の未来は、情報へのアクセスが一部の人々に集中するのか、すべての人に開かれるのかにかかっているかもしれません。データは答えそのものではありません。それは、人間が新たな問いを発見し、新たな可能性を創造できるようにする道具にすぎないのです。




