機械学習における新たなドキュメンテーション基準は、責任あるテクノロジーの実現を後押しし得るものです。
これらのリスク管理戦略は、組織が価値ある知的財産を守りながらコンプライアンスを遵守する方法を示しています。
デジタル化の加速に向けた世界的な動きの中で、機械学習(ML)の利用が広がるにつれ、「誰がその店を見張っているのか?」という問いが浮かび上がっています。
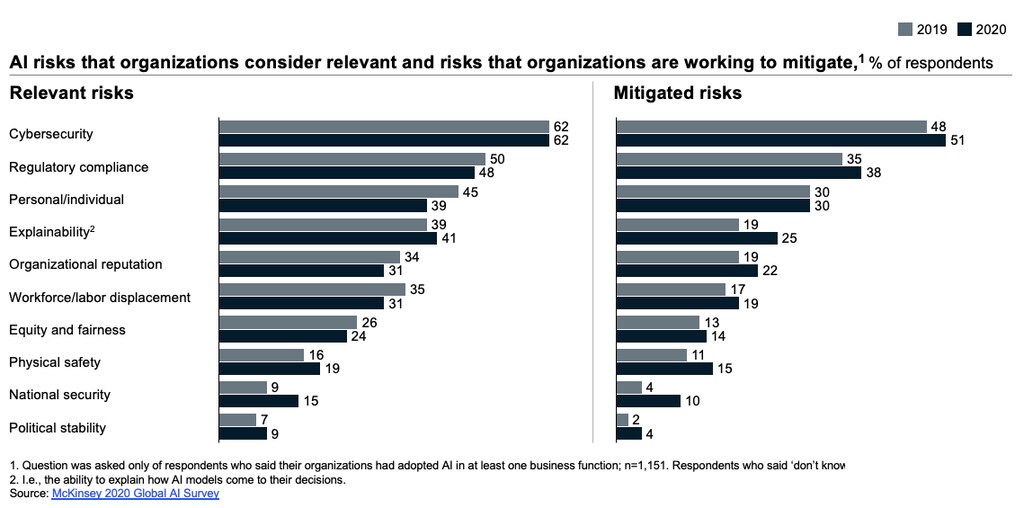
MLモデルの力と落とし穴の両方を示す事例は数多く見られます。組織は弊害をますます認識しつつあるものの(当社の調査によれば、依然として後れを取っている組織も少なくありません)、合意された一連のツールや基準がないまま、これらのリスクの管理に苦慮しています。一方で、競争環境には強い関心を寄せており、独自の手法を合理的に保護しようとしています。
一部の地域の政府は、基礎となるモデルデータの規制に着手することで、初期的なガードレールを設けています。しかし、世界的な基準はまだ確立されておらず、MLモデルに関する規制も追いついていません。
MLを責任を持って活用するための2つの重要な要素は、組織にとって慎重な「まず取り組むべき点」を示しています。それは、モデルの説明可能性とデータの透明性です。モデルがなぜ特定の結果に至ったのかを説明できないことは、ほぼすべての業界においてリスクをもたらします。医療など一部の分野では、モデルが患者のケアに関する推奨を提示する場合があり、その影響は特に重大です。金融サービスにおいては、規制当局が貸し手がなぜ融資を行うのかを把握する必要が生じることもあります。データの透明性は、モデルの構築に用いられる学習データセットに不公正または意図しないバイアスがないことを確保でき、それが保護対象となる属性に対する不均衡な影響につながり得ます。また、消費者は自身のデータがどのように利用されているかを知る権利を有しており、この権利は法的保護の対象となりつつあります。
しかし、MLモデルを開発する組織が、説明可能性と透明性の基準を適用しようとすると、その組織の知的財産を構成する特徴量、データセット、モデルの枠組みそのものを公開しなければならない場合があります。そのような状況で、組織はどのようにしてこれらの基準を徹底できるのでしょうか。
ドキュメンテーションによるリスク管理
機械学習は複雑で学際的な性質を持つため、経営幹部は関連するリスクを管理するために、さまざまなアプローチを採用すべきです。それには、モデル開発にリスク管理を組み込むこと、および包括的なリスクフレームワークを適用することが含まれます。これらのフレームワークは、その他の種類の企業リスクの管理に用いられる原則を活用し、適応させるものです。また、経営幹部はMLを利用する際、従業員や社会に与える広範な影響について、定期的に立ち止まって検討することも欠かせません。
これらのアプローチに共通する一つの横断的な実践が、ドキュメンテーションです。ドキュメンテーションは、説明可能性と透明性を実現する仕組みとして機能すると同時に、基礎となるデータやモデルの特徴量を開示することなく、モデルおよびその内容の一部を代替的に示すことができます。
標準的な技術文書は、実務者がモデルを実装するために作成されるものですが、説明可能性と透明性に焦点を当てたドキュメンテーションは、消費者、規制当局、その他の関係者に対して、モデルやデータセットがなぜ、どのように利用されているのかを伝えるものです。こうしたドキュメンテーションには、モデルそのものの概要が含まれます。具体的には、その意図された目的、性能、来歴、学習データセットおよび学習プロセスに関する情報、モデルに関する既知の問題やトレードオフ、特定されたリスク軽減策、そしてテクノロジーの文脈を理解する助けとなるその他の情報などです。提供の形式としては、モデルのファクトシート、スコアカード、アルゴリズム影響評価、データセットラベルのいずれか、またはその組み合わせが考えられます。
レシピを明かさずに材料を開示する
食品メーカーが販売するクッキーを例に考えると、分かりやすい類推が得られます(この類推は、Data Nutrition Projectの取り組みに着想を得たものであり、当社の著者の一人がこのプロジェクトに個人の立場で関わっています)。そうしたクッキーを製造する企業は、独自のレシピを共有することには消極的ですが、食品規制当局は消費者向けに、パッケージに原材料一覧を記載した栄養表示を義務付けています。消費者は、クッキーを選ぶ際に正確なレシピを知る必要はなく、分かりやすい形で示された原材料の概要と栄養成分の内訳を把握できれば十分です。
同様に、モデルのドキュメンテーションは、実際の「クッキーのレシピ」を共有する代わりに、モデルとその特徴量およびデータセットを世界と共有するための代替手段となり得ます。これにより、他者はモデルを再現する方法を知る必要も、導き出す必要もなく、モデルの「健全性」と根拠を確認することができます。その過程で企業秘密が漏れることはありません。
フォーラムは、政府がAI技術を責任を持って導入できるよう、どのように支援していますか?
重要な点として、ドキュメンテーションは組織が重大な問題を早期に特定する助けとなります。時宜にかなった事例として、COVID-19ワクチンの配分管理を支援するモデルを構築していたある州政府は、モデルのドキュメンテーションを作成する過程で、いくつかの地域が十分に代表されていないことに気づき、そのモデルを迅速に再調整して問題を是正しました。
ドキュメンテーションは組織にとって、ほかにも利点をもたらします。例えば、企業が市場の変化に対応する助けとなります。クッキーの場合、これは栄養士にとって、クッキーにトランス脂肪酸が多く含まれている際に点灯する赤い警告灯に相当します。消費者がトランス脂肪酸の過剰摂取による害に気づき、トランス脂肪酸を含まないクッキーを選ぶようになると、食品メーカーは消費者のニーズに応えるため、自主的により健康的なレシピを開発することを決める場合があります。
ドキュメンテーションを実践に移す
この取り組みを実践に移そうとする組織は、ボトムアップのアプローチを採用することができます。その場合、実務者や事業部門の関係者が、モデルの内容やプロセスについて何を記録すべきかを決定します。MLモデルやデータセットの開発者には、選択されたカテゴリーに沿った質問のチェックリストを提供することができます。例えばデータセットについては、説明、構成、来歴、収集、管理といったカテゴリーが登場していることが確認されています。
ドキュメンテーションを作成するプロセスには、部門横断的な支援も必要となります。追加のチームメンバーとして、モデルやデータの利用事例がもたらす影響を理解するための分野の専門家、法務・規制の専門家、そしてデータのキュレーションおよび管理に携わった人々が含まれる可能性が高いでしょう。また、AIシステムの影響を受ける集団の代表者をチームに加え、ドキュメンテーションが実際に影響を受ける人々にも理解されるようにすることも考えられます。
すべてのモデルに同じレベルのリスク管理が求められるわけではありません。ドキュメンテーションのプロセスには時間と労力がかかるため、リスク評価フレームワークにこの取り組みを組み込むことを推奨します。影響の大きいモデルから着手するのが適切でしょう。ドキュメンテーションの各側面が自動化可能になるにつれ、リスクの低い利用事例も、より入念なドキュメンテーションの対象として適したものになる可能性があります。
普遍的なドキュメンテーション基準の策定を待つ必要はありません
栄養表示は標準化されているため有用であり、消費者は特定の原材料をどこで確認すればよいかを把握できます。同様に、モデルやデータのドキュメンテーションも、普遍的に適用され理解されるか、少なくとも相互運用可能であるほど、その効果が高まります。現在、複数のMLドキュメンテーションに関する取り組みが進行中ですが、まだ勝者となる基準は現れていません。
政府は今後この分野での規制をさらに強化していくと考えられますが、当社は特定の法律や政策変更を提唱するものではありません。しかし、ドキュメンテーションの実践に自ら取り組み始めることは、知的財産を守りながら、協働やさらなる研究を促す契機となり得ます。




