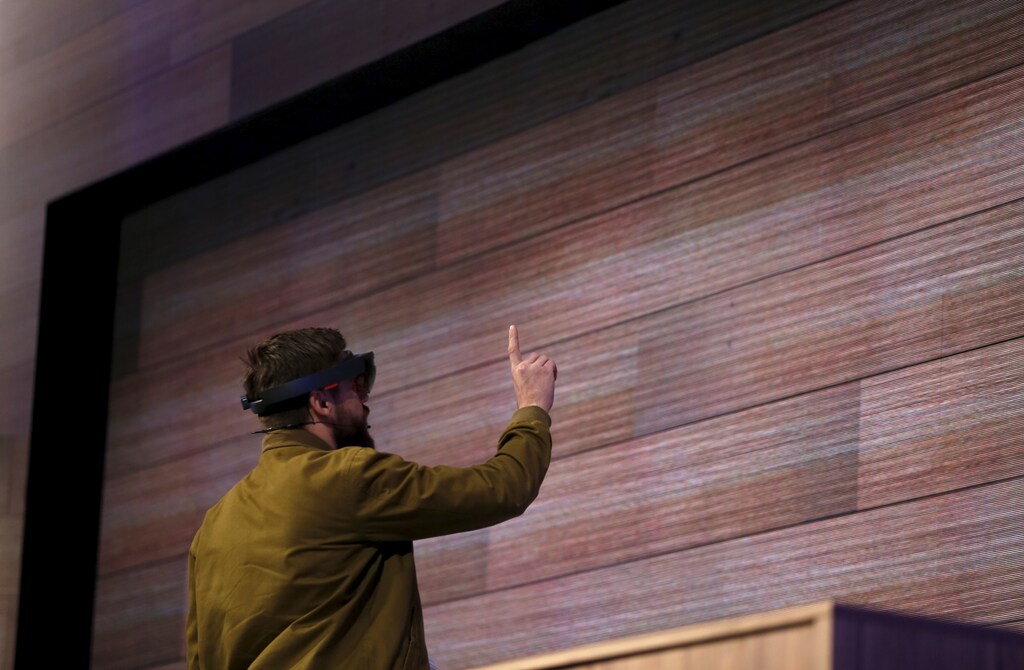
映画『アイアンマン』では、トニー・スタークがホログラフィック・コンピュータを使って3Dデータを空中に投影し、手で操作しながら、スーパーヒーローとしての問題の解決策を見つけ出します。同じような発想で、MITとブラウン大学の研究者らは、タッチスクリーン上で動作する対話型データ分析システムを開発しました。このシステムは、億万長者の天才技術者だけでなく、誰もが現実世界の課題に取り組めるようにするものです。
研究者らは長年にわたり、「Northstar」と呼ばれる対話型データサイエンス・システムの開発を進めてきました。このシステムはクラウド上で動作しますが、スマートフォンや大型の対話型ホワイトボードを含む、あらゆるタッチスクリーン機器に対応したインターフェースを備えています。ユーザーは指またはデジタルペンを使い、使いやすいインターフェース上でデータセットを投入し、操作、結合、特徴量の抽出を行うことで、傾向やパターンを明らかにできます。
ACM SIGMOD会議で発表される論文において、研究者らはNorthstarの新たな構成要素として「VDS(仮想データサイエンティスト)」を紹介しています。VDSは、データセットに対する予測タスクを実行するための機械学習モデルを瞬時に生成します。例えば医師は、このシステムを使って特定の疾患にかかりやすい患者を予測することができ、事業者は売上の予測を行いたい場合もあるでしょう。対話型ホワイトボードを使用すれば、全員がリアルタイムで共同作業することもできます。
その狙いは、複雑な分析を迅速かつ正確に、容易に行えるようにすることで、データサイエンスを民主化することにあります。
「データサイエンスを知らないコーヒーショップの経営者でも、今後数週間の売上を予測し、どれだけコーヒー豆を仕入れるべきかを判断できるべきです」と、共著者であり長年Northstarプロジェクトを率いてきたティム・クラスカ氏は語ります。同氏は、マサチューセッツ工科大学(MIT)のコンピュータ科学・人工知能研究所(CSAIL)で電気工学・コンピュータサイエンスの准教授を務めるとともに、新設されたデータシステム・AIラボ(DSAIL)の創設共同ディレクターでもあります。「データサイエンティストがいる企業では、データサイエンティストと非専門家の間で多くのやり取りが行われています。そのため、同じ部屋に集まって共同で分析を行うこともできるのです。」
VDSは、人工知能分野で近年ますます普及している「自動機械学習(AutoML)」という手法に基づいています。AutoMLを使えば、データサイエンスの知識が限られた人でも、データセットに基づいて予測を行うAIモデルを学習させることができます。現在、このツールはDARPAのD3M自動機械学習コンペティションで首位に立っており、同コンペティションでは6か月ごとに最も性能の高いAutoMLツールが選定されています。
論文には、クラスカ氏に加え、以下の研究者も参加しています。筆頭著者は大学院生のZeyuan Shang氏、そしてNorthstarの主要な貢献者でありポスドクのEmanuel Zgraggen氏です。両氏はいずれもEECS、CSAIL、DSAILに所属しています。Benedetto Buratti氏、Yeounoh Chung氏、Philipp Eichmann氏、Eli Upfal氏は全員ブラウン大学所属です。また、最近ブラウン大学からドイツのダルムシュタット工科大学に移籍したCarsten Binnig氏も参加しています。

分析のための「無限のキャンバス」
今回の研究は、MITとブラウン大学の研究者による、Northstarに関する長年の共同研究を基盤としています。過去4年間で、研究者らは対話型インターフェース、複数のプラットフォーム上での操作、結果の高速化、ユーザー行動に関する研究など、Northstarの構成要素を詳述する多数の論文を発表してきました。
Northstarは、白紙の白いインターフェースから始まります。ユーザーはデータセットをシステムにアップロードすると、それが左側の「datasets」ボックスに表示されます。データのラベルは、その下の別の「attributes」ボックスに自動的に反映されます。また、さまざまなアルゴリズムや新しいAutoMLツールを含む「operators」ボックスもあります。すべてのデータはクラウド上に保存され、分析されます。
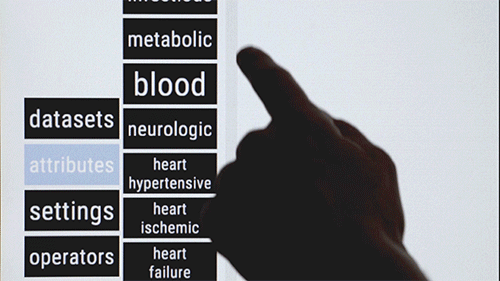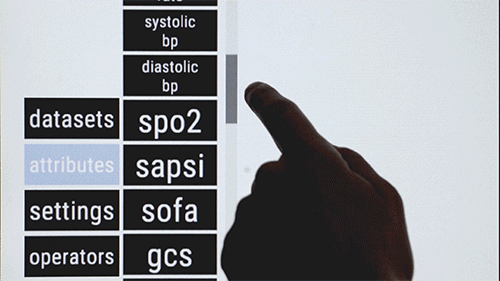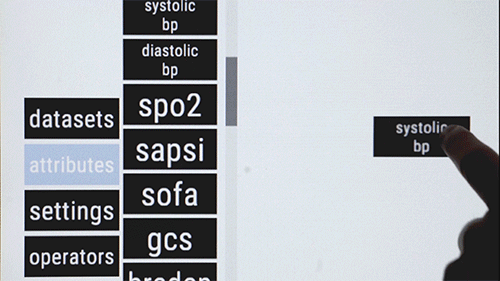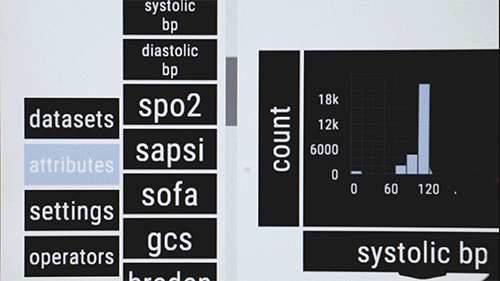
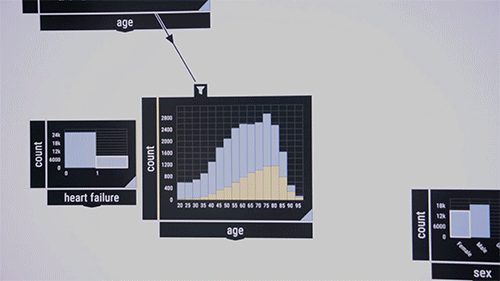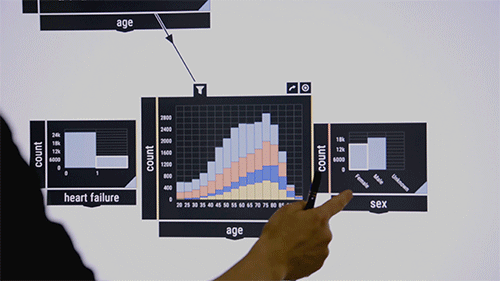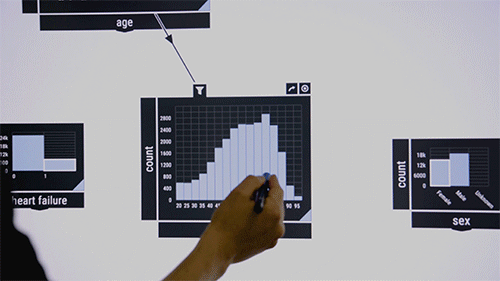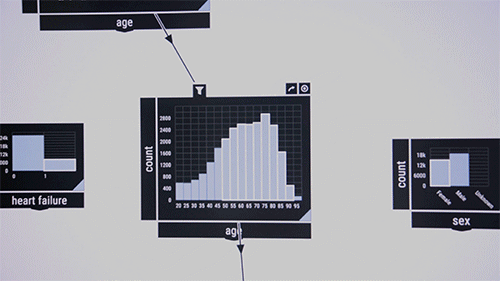
研究者らは、集中治療室の患者に関する情報を含む公開データセットを使って、このシステムを実演するのが常です。例えば、特定の年齢層における特定の疾患の同時発生を調べたい医療研究者を想定してみましょう。彼らは、インターフェースの中央に、最初は空のボックスとして表示されるパターンチェック・アルゴリズムをドラッグ&ドロップします。入力として、「blood(血液)」「infectious(感染症)」「metabolic(代謝)」などとラベル付けされた疾患の特徴をボックス内に移動させます。すると、データセットにおけるそれらの疾患の割合がボックス内に表示されます。次に、「age(年齢)」の特徴をインターフェースにドラッグします。すると患者の年齢分布を示す棒グラフが表示されます。2つのボックスの間に線を引くと、両者が結び付けられます。年齢範囲を丸で囲むと、アルゴリズムは、その年齢範囲における3つの疾患の同時発生率を即座に計算します。
「大きく、無限に広がるキャンバスのようなものです。そこに、すべてを好きなように配置できるのです」と、Northstarの対話型インターフェースの主要な考案者であるZgraggen氏は語ります。「そして、さまざまなものを結び付けることで、データに関するより複雑な問いを立てることができます。」
AutoMLの近似
VDSを使えば、ユーザーはタスクに合わせてカスタマイズされたモデルを取得することで、そのデータに対する予測分析も実行できるようになりました。対象となるタスクには、データ予測、画像分類、複雑なグラフ構造の分析などが含まれます。
前述の例を用いると、医療研究者がデータセット内のすべての特徴に基づいて、どの患者が血液疾患を発症する可能性があるかを予測したいとします。彼らはアルゴリズムの一覧から「AutoML」をドラッグ&ドロップします。最初は空のボックスが表示されますが、そこには「target(対象)」タブがあり、その下に「blood」の特徴をドロップします。システムは、最も性能の高い機械学習パイプラインを自動的に見つけ出し、常に更新される精度の割合とともにタブとして表示します。ユーザーはいつでも処理を停止したり、検索条件を絞り込んだり、各モデルの誤り率、構造、計算過程などを検証したりできます。
研究者らによると、VDSは現時点で最も高速な対話型AutoMLツールであり、その一因は独自の「推定エンジン」にあります。このエンジンはインターフェースとクラウドストレージの間に位置しています。エンジンは、データセットの代表的なサンプルを自動的に複数作成し、それらを段階的に処理することで、数秒のうちに高品質な結果を生成します。
「共著者とともに、データサイエンティストの思考を模倣するようVDSの設計に2年間を費やしました」とShang氏は語ります。これは、さまざまな符号化されたルールに基づき、特定のタスクにおいてどのモデルや前処理ステップを実行すべきか、またはすべきでないかを瞬時に判断することを意味します。VDSはまず、可能な機械学習パイプラインの大規模なリストから選択し、サンプルセット上でシミュレーションを実行します。その過程で結果を記憶し、選択内容を洗練させていきます。高速な近似結果を提示した後、システムはバックエンドで結果を精緻化します。ただし、最終的な数値は通常、最初の近似値に非常に近いものとなります。
「予測ツールを使う際、最初の結果が返ってくるまで4時間も待ちたくはないはずです。何が起きているかをすぐに把握したいですし、誤りに気づいた場合は即座に修正できるべきです。これは、他のどのシステムでも通常は不可能です」とKraska氏は語ります。実際、研究者らが以前に実施したユーザー調査では、「結果の提示を遅らせた瞬間に、ユーザーがシステムへの関与を失い始めることが示された」とされています。
研究者らは、実世界の300件のデータセットを用いてこのツールを評価しました。他の最先端のAutoMLシステムと比較して、VDSの近似結果は同等の精度でありながら、数秒以内に生成されました。これは、数分から数時間を要する他のツールと比べて格段に速いものです。
次に研究者らは、データのバイアスや誤りの可能性をユーザーに警告する機能の追加を検討しています。例えば、患者のプライバシーを守るため、研究者が医療データセットに、年齢不明の患者には0、95歳を超える患者には200といった値を付与することがあります。しかし、初心者はこのような誤りに気づかないことがあり、それによって分析結果が完全に狂ってしまう可能性があります。
「新しいユーザーの場合、結果を見て素晴らしいと思うかもしれません」とKraska氏は語ります。「しかし、データセットに問題を示す可能性のある外れ値が実際に含まれている場合があることを、ユーザーに警告することはできます。」




