地球上には、約10兆ギガバイトのデジタルデータが存在しており、人類が生み出すデータの量の増加に伴い、その量は日々急速に増えています。
エクサバイト級のデータセンターには、このデータの大部分が収められており、建設と維持にそれぞれ約10億ドルの費用がかかります。
MITの科学者は、非常に高い密度で大量のデータを保存できるDNAを使い、より効果的なデータ保存法の開発に取り組んでいます。
この研究は有望ですが、DNAが記憶媒体として実用的になるためには、さらなる知見が必要です。
現在、地球上には約10兆ギガバイトのデジタルデータが存在しており、毎日、人類はメール、写真、ツイート、その他のデジタルファイルを生み出し、それによってさらに250万ギガバイトのデータが加わっています。このデータの多くは、エクサバイトデータセンター(1エクサバイトは10億ギガバイト)と呼ばれる巨大な施設に保存されており、その規模はサッカー場数面分に及ぶこともあり、建設と維持に約10億ドルの費用がかかります。
多くの科学者は、代替の解決策が、遺伝情報を含む分子であるDNAにあると考えています。DNAは、非常に高い密度で大量の情報を保存するよう進化してきました。MITの生物工学教授マーク・バーテは、コーヒーマグ一杯分のDNAがあれば、理論上は世界のデータすべてを保存できると述べています。
「世界が蓄積し続けている膨大な量のデータ、特にアーカイブデータを保存するための新たな解決策が必要です」と、MITおよびハーバード大学のブロード研究所の准会員でもあるバーテは述べています。「DNAは、フラッシュメモリーよりもさらに千倍も高密度です。また、興味深いもう一つの特性として、DNAポリマーを一度作ってしまえば、エネルギーをまったく消費しません。DNAに書き込んでしまえば、永久に保存できるのです。」
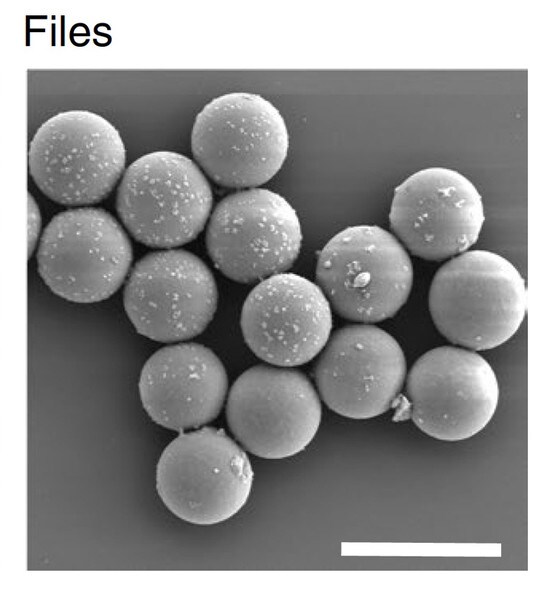
科学者たちは、画像や文章のページをDNAとして符号化できることをすでに実証しています。しかし、多数のDNA断片の混合物から目的のファイルを簡単に取り出す方法も必要になります。バーテと同僚たちは現在、その方法の一つを実証しました。各データファイルを6マイクロメートルのシリカ粒子に封入し、その内容を示す短いDNA配列で標識するという方法です。
この手法を用いて、研究者たちは、DNA配列として保存された個々の画像を、20枚の画像の中から正確に取り出せることを実証しました。使用可能な標識の数を考えると、この手法は最大1020ファイルまで拡張できる可能性があります。
バーテは、本研究の責任著者であり、研究成果は本日、Nature Materialsに掲載されました。論文の筆頭著者は、MITのシニア・ポスドクであるジェームズ・バナル、MITの元研究員タイソン・シェパード、そしてMITの大学院生ジョセフ・ベルリアントです。
安定した保存
デジタル記憶システムは、テキスト、写真、その他あらゆる種類の情報を、0と1の連続として符号化します。同じ情報は、遺伝暗号を構成する4種類のヌクレオチド(A、T、G、C)を用いてDNAにも符号化することができます。例えば、GとCを0を表すために、AとTを1を表すために用いることができます。
DNAには、記憶媒体として望ましい他の特徴がいくつもあります。極めて安定しており、合成や塩基配列の解読は比較的容易ですが(ただし費用は高額です)、また、その密度が非常に高く、各ヌクレオチドは最大2ビットに相当し、体積は約1立方ナノメートルです。そのため、DNAとして保存されたエクサバイト級のデータは、手のひらに収まるほどの大きさになり得ます。
このようなデータ保存の障壁の一つは、これほど大量のDNAを合成する費用です。現在、100万ギガバイト(1ペタバイト)のデータを書き込むには、1兆ドルかかると推定されています。アーカイブデータの保存に広く用いられている磁気テープと競争力を持つためには、DNA合成の費用を約6桁減らす必要があるとバーテは見積もっています。バーテは、過去数十年にわたってフラッシュドライブへの情報保存費用が劇的に下がってきたのと同様に、その低下は10年から20年以内に実現すると予想しています。
費用に加えて、DNAにデータを保存する上でのもう一つの大きな障壁は、他の多数のファイルの中から目的のファイルを取り出すことの難しさです。
「DNAへの書き込み技術が、エクサバイトやゼタバイト級のデータをDNAに費用対効果よく書き込めるレベルに到達したと仮定しましょう。その先はどうなるでしょうか? 途方もない数のファイル、画像や動画、その他のものからなるDNAの山ができることになり、その中から、探している一枚の写真や一本の動画を見つけ出す必要があります」とバーテは述べています。「それは、干し草の山から針を探すようなものです。」
現在、DNAファイルは従来、PCR(ポリメラーゼ連鎖反応)を用いて取り出されています。各DNAデータファイルには、特定のPCRプライマーと結合する配列が含まれています。特定のファイルを取り出すには、そのプライマーを試料に加えて、目的の配列を見つけ出して増幅させます。ただし、この手法の欠点の一つは、プライマーと標的外のDNA配列との間で交差反応が起こり得るため、不要なファイルまで取り出されてしまう可能性があることです。また、PCRによる取り出し工程には酵素が必要であり、結果的にプール内のDNAの大部分を消費してしまいます。
「干し草の山から針を見つけるために、山を燃やしているようなものです。他のDNAはすべて増幅されないため、基本的にそれらを捨てていることになるのですから」とバーテは述べています。
ファイルの取り出し
別のアプローチとして、MITの研究チームは、各DNAファイルを小さなシリカ粒子に封入する新たな取り出し技術を開発しました。各カプセルには、ファイルの内容に対応する一本鎖DNAの「バーコード」が付けられています。費用対効果の高い方法でこのアプローチを実証するため、研究者たちは20種類の異なる画像を、長さ約3,000ヌクレオチド(約100バイトに相当)のDNA断片に符号化しました。(カプセルには最大1ギガバイトのDNAファイルも収められることを、研究者たちは併せて示しています。)
各ファイルには、「猫」や「飛行機」といったラベルに対応するバーコードが付けられています。研究者が特定の画像を取り出したい場合は、DNAの試料を取り出し、探したいラベルに対応するプライマーを加えます。例えば、トラの画像であれば「猫」「オレンジ色」「野生」、イエネコの画像であれば「猫」「オレンジ色」「家庭的」といった具合です。
プライマーには蛍光性または磁性の粒子が標識されており、試料から一致するものを簡単に取り出して特定することができます。これにより、目的のファイルを取り除きつつ、残りのDNAはそのまま保持され、保存場所に戻すことができます。この取り出し工程により、「大統領 AND 18世紀」のようなブール論理式を入力すると、ジョージ・ワシントンが結果として得られ、Google画像検索で得られる結果と似たものになります。
「現段階の概念実証では、検索速度は毎秒1キロバイトです。当社のファイルシステムの検索速度は、カプセルあたりのデータサイズによって決まります。このデータサイズは現在、DNAに1億バイト分でも書き込むのに費用がかかりすぎるという制約と、並列で使用できる選別装置の数によって制限されています。DNA合成が十分に安価になれば、この手法でファイルごとに保存できるデータサイズを最大化できるようになるでしょう」とバナルは述べています。
バーコードには、ハーバード・メディカル・スクールの遺伝学・医学教授であるスティーブン・エレッジが開発した、各約25ヌクレオチドからなる10万配列のライブラリーから選んだ一本鎖DNA配列が用いられました。各ファイルに2つのラベルを付ければ、1010個(100億個)の異なるファイルを一意に標識でき、各ファイルに4つのラベルを付ければ、1020個のファイルを一意に標識できます。
ハーバード・メディカル・スクールの遺伝学教授であるジョージ・チャーチは、この技術を「知識管理と検索技術における巨大な飛躍」と表現しています。
世界経済フォーラムは、第四次産業革命に対してどのような取り組みを行っているのでしょうか?
先端技術・イノベーションセンターは、科学者、政策立案者、ビジネスリーダーを結び付け、新興技術とその現実社会への影響を読み解いています。
同センターは、協働と実験を可能にすることで、研究から生まれたイノベーションを、地球規模の共通の課題に対応する実用的な応用へとパートナーが転換できるよう支援しています。
「DNA形式での書き込み、複製、読み取り、そして低エネルギーでのアーカイブデータ保存における急速な進歩は、巨大な(1021バイト、ゼタ級の)データベースから、データファイルを正確に取り出す機会が、ほとんど探究されないまま残されてきたことを意味しています」と、本研究に関与していないチャーチは述べています。「この新たな研究は、DNAの完全に独立した外側の層を用い、DNAの異なる特性(塩基配列の解読ではなくハイブリダイゼーション)を活用することで、この課題に見事に取り組んでいます。さらに、既存の装置と化学物質を使っている点も特筆に値します。」
バーテは、このようなDNAのカプセル化が、「コールド」データ、すなわちアーカイブに保存され、ほとんどアクセスされないデータの保存に役立つと考えています。バーテの研究室は、スタートアップ企業Cache DNAを立ち上げており、同社は現在、DNAデータの長期保存のためにも、また臨床データや既存のDNA試料の近い将来の保存のためにも、長期保存技術を開発しています。
「DNAがデータ記憶媒体として実用化されるまでにはまだ時間がかかるかもしれませんが、新型コロナウイルス感染症(COVID-19)の検査、ヒトゲノムの塩基配列解析、その他のゲノム学分野から得られた既存のDNAやRNA試料について、低コストで大規模な保存ソリューションが今まさに切実に求められています」とバーテは述べています。
本研究は、アメリカ海軍研究局、アメリカ国立科学財団、アメリカ陸軍研究局の支援を受けて行われました。




