複数の研究パートナーの協力のもと、DeepMindはヒトの体内にほぼすべて存在するタンパク質の構造を収めたデータベースを公開しました。
これらの構造は、画期的なタンパク質フォールディングシステムであるAlphaFoldによって計算により決定されたものです。
このデータベースは誰でも無料で利用でき、生物学と医学において変革をもたらすツールになる可能性があります。
DeepMindと複数の研究パートナーは、昨年実証された画期的なタンパク質フォールディングシステムであるAlphaFoldによって計算により決定された、ヒトの体内にほぼすべて存在するタンパク質の3D構造を収めたデータベースを公開しました。この無料公開データベースは、数百の分野と領域にわたる科学者にとって大きな前進と利便性をもたらすものであり、生物学と医学の新たな段階の基盤となる可能性が十分にあります。
AlphaFoldタンパク質構造データベースは、DeepMind、欧州バイオインフォマティクス研究所などとの共同事業であり、AlphaFoldによって構造が予測された数十万のタンパク質配列で構成されています。さらに、数百万件を追加して「世界のタンパク質年鑑」を作成する計画です。
「この研究は、AIがこれまでに科学的知識の進展に果たした最も重要な貢献を表すものだと考えており、AIが社会にもたらしうる恩恵の好例です」と、DeepMindの創設者兼CEOであるデミス・ハサビス氏は述べました。
ゲノムからプロテオームへ
プロテオミクス全般に馴染みがない場合でも、それは十分に自然なことです。その場合、おそらく別の大規模な取り組みを例に考えるのが最もわかりやすいでしょう。それはヒトゲノムの解読です。1990年代後半から2000年代初頭にかけての出来事を覚えている方もいるでしょう。これは、世界中の多数の科学者や組織が長年にわたって取り組んだ大規模な事業でした。ついに完成したゲノムは、無数の疾患の診断と理解、ならびにその治療薬や治療法の開発において重要な役割を果たしてきました。
しかしそれは、この分野における作業の始まりにすぎませんでした。巨大なジグソーパズルの縁のピースをすべて埋めるようなものです。そして当時、誰もが注目した次の大きなプロジェクトの一つが、ヒトのプロテオームの理解でした。すなわち、ヒトの体が利用し、ゲノムにコードされているすべてのタンパク質を指します。
プロテオームの問題は、はるかに、はるかに複雑であることです。タンパク質はDNAと同様に、既知の分子の配列から成ります。DNAでは、おなじみの少数の塩基(アデニン、グアニンなど)がそれにあたりますが、タンパク質では20種類のアミノ酸がそれにあたります(それぞれが遺伝子内の複数の塩基によってコードされています)。これだけでも格段に複雑になりますが、それは始まりにすぎません。配列は単なる「コード」ではなく、実際にはねじれて折り畳まれ、体内であらゆる種類の作業を行う微小な分子の折り紙機械になります。それは、2進数のコードから、現実世界の物体を形作る複雑な言語へと移行するようなものです。
実際には、プロテオームは数百個のアミノ酸からなる2万の配列だけで構成されているのではなく、それぞれの配列が物理的な構造と機能を持っていることを意味します。そして、それらを理解する上で最も難しい部分の一つは、特定の配列からどのような形状が作られるかを突き止めることです。これは一般に、X線結晶構造解析のような手法を用いて実験的に行われますが、これは単一のタンパク質を解明するのに数か月以上かかることもある、長く複雑なプロセスです。もちろん、最高の研究室と技術を利用できる場合に限られます。構造はコンピュータによって予測することもできますが、そのプロセスは実際に頼りにできるほど十分な精度に達したことは一度もありませんでした。AlphaFoldが登場するまでは。
分野を驚かせた取り組み
計算によるプロテオミクスの歴史全体には立ち入らないものの(そうできればよいのですが)、私たちは基本的に、15年前の分散型のブルートフォース手法(覚えていますか、Folding@homeを)から、過去10年間でより洗練されたプロセスへと進んできました。その後、AIベースのアプローチが登場し、2019年にはDeepMindのAlphaFoldが世界の他のすべてのシステムを飛び越えて注目を集めました。さらに2020年には再び飛躍的な進歩を遂げ、一部の専門家が、任意の配列を3D構造に変換する問題は解決されたと宣言するほどの精度と信頼性を達成しました。
この長い歴史を一つの段落にまとめているのは、それが当時広く報道されたからですが、この進歩がどれほど突然で完全なものであったかは、いくら強調してもしすぎることはありません。これは何十年にもわたり世界最高の頭脳を悩ませてきた問題であり、「おそらく、ある程度機能するものの、非常に遅く、多大な費用がかかるアプローチがある」という段階から、「正確で信頼性が高く、既製のコンピュータで実行可能」という段階へと、わずか1年の間に移行したのです。
DeepMindの進歩の詳細と、それをどのように達成したかについては、計算生物学およびプロテオミクスの専門家に委ねたいと思います。専門家たちは、今後数か月から数年にわたりこの成果を精査し、改良を重ねていくことでしょう。今日私たちが関心を寄せているのは実用的な成果です。同社はAlphaFold 2(2020年に発表されたバージョン)の公開以降、モデルを微調整するだけでなく、入手できるすべてのタンパク質配列に対して……それを実行することに時間を費やしました。
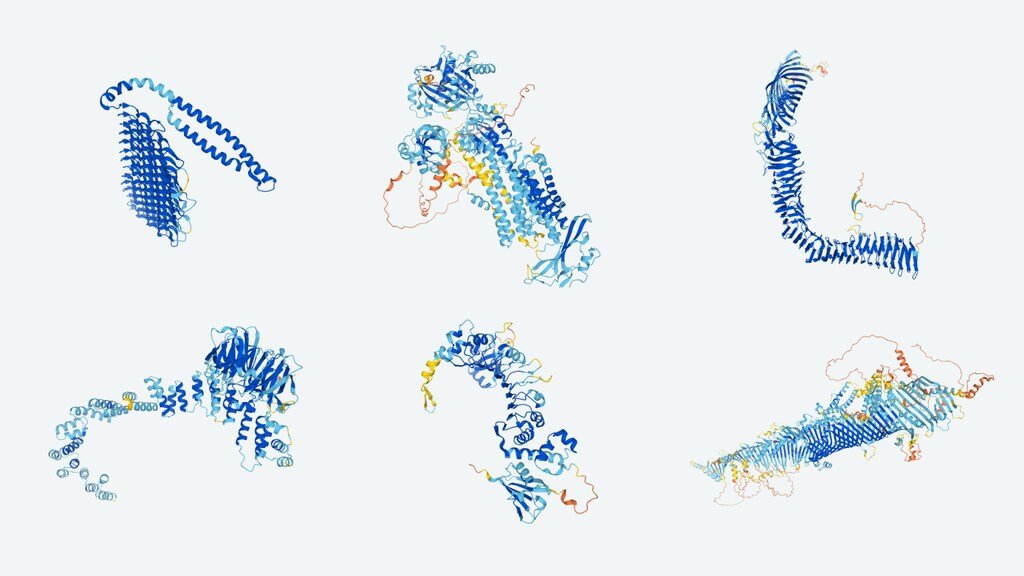
その結果、現在ヒトのプロテオームの98.5%が、いわゆる「フォールディング」されたもの、すなわちAIモデルが十分に確信しているもの(そして重要なことに、私たちはその確信を十分に信頼していますその確信)は、本物の構造を表しています。また、酵母や大腸菌など他の20種の生物についてもプロテオームをフォールディングしており、合計で約35万件のタンパク質構造に及びます。これは圧倒的に最大かつ最良の、きわめて重要なこの情報のコレクションであり、桁違いの規模です。
これらすべては、研究者が配列またはタンパク質名を入力するだけで、ただちに3D構造を取得できる、自由に閲覧可能なデータベースとして提供される予定です。プロセスとデータベースの詳細は、本日学術誌Natureに掲載された論文に記載されています。
「明日お見せするデータベースは検索バーであり、タンパク質構造版のGoogle検索のようなものです」とハサビス氏はTechCrunchとのインタビューで語りました。「3Dビジュアライザーで表示し、拡大して見たり、遺伝子配列を調べたり……そして、EMBL-EBIと連携したことの良い点は、同機関のその他すべてのデータベースとつながっていることです。そのため、関連する遺伝子をすぐに確認できます。また、これらすべての他のデータベースともつながっているため、関連する遺伝子、他の生物における関連遺伝子、類似の機能を持つ他のタンパク質などを確認できます。」
「私自身も科学者として、ほとんど想像もつかないほど難解なタンパク質の研究に取り組んでいますが」とEMBL-EBIのエディス・ハード氏(どのタンパク質かは明言しませんでした)は述べました。「今では、これほど短時間で、タンパク質の要となる部分が何であるかを知ることができるのは、本当にエキサイティングなことです。以前なら何年もかかったでしょう。構造にアクセスして『あ、このが要となる部分なのだ』と言えることで、その要となる部分が何をしているのかを突き止める作業に集中できます。科学を何年分も一気に加速させていると思います。数十年前にゲノムを解読できるようになったときのようなものです。」
このような取り組みそのものが非常に新しいため、ハサビス氏は、分野全体が変わり、それに伴ってデータベースも変わることを強く予想していると述べました。
「構造生物学者はまだ、何年もかけて実験によってこうしたことを特定するのではなく、何でも数秒で検索できるという考え方に慣れていません」と氏は述べました。「そして、そのことによって、問いの立て方や実施できる実験について、まったく新しい種類のアプローチが生まれるはずだと考えています。そうした動きが見え始めたら、この種の偶然の発見を促す他のツールを構築し始めるかもしれません。たとえば、特定の方法で関連付けられた1万のタンパク質を調べたい場合はどうでしょうか?現在、そのための通常の方法はありません。なぜなら、現在の誰もそのような通常の問いを立てることはないからです。そのため、新しいツールを作る必要があり、人々がこれをどのように利用するかが分かり始めたら、その需要も生まれるでしょう。」
これには、ソフトウェア自体の派生版や段階的に改良されたバージョンも含まれており、膨大な開発履歴とともにオープンソースとして公開されています。すでに、独立して開発されたシステムであるRoseTTAFoldを確認しています。これはワシントン大学のベーカー研究室の研究者によるもので、昨年のAlphaFoldの性能を基に、より効率的な類似システムとして作られたものです。ただし、最新版ではDeepMindが再びリードしているようです。しかし、重要な点として、その中核となる技術は誰もが利用できる状態にあるということが指摘されました。




