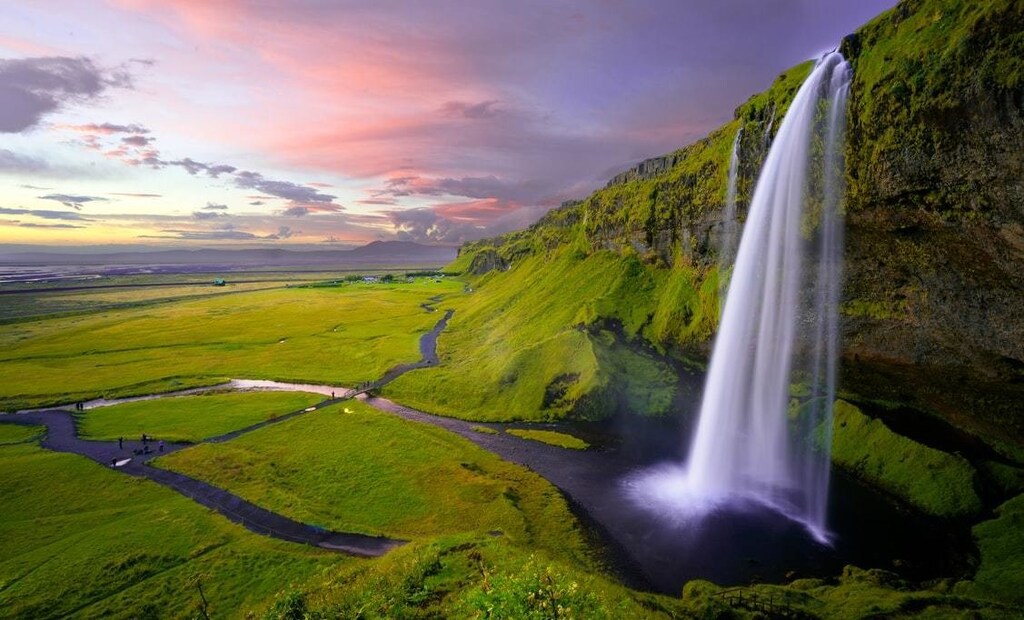
新たな深層学習手法により、単一の写真から滝、煙、雲などの動く対象をアニメーション化できます。
この技術は、写真が撮影された時点で物体がどのように動いていたかを予測し、その情報を用いてアニメーションを作成します。
この手法では、ユーザーによる入力や追加情報も必要ありません。
将来的には、風に揺れる人の髪をアニメーション化することにも使える可能性があります。
写真は、景色を完全に捉えきれないことがあります。もしナイアガラの滝の旅行写真の水が動いていたなら、どれほど壮大な一枚になるでしょうか。
新たな深層学習手法では、まさにそれが可能です。滝の写真を1枚与えると、システムは水が流れ落ちる様子を映した動画を作成します。欠けているのは、水の轟音と顔にかかる水しぶきの感覚だけです。
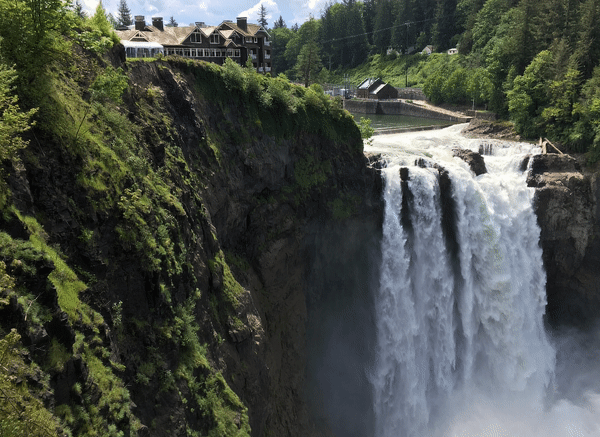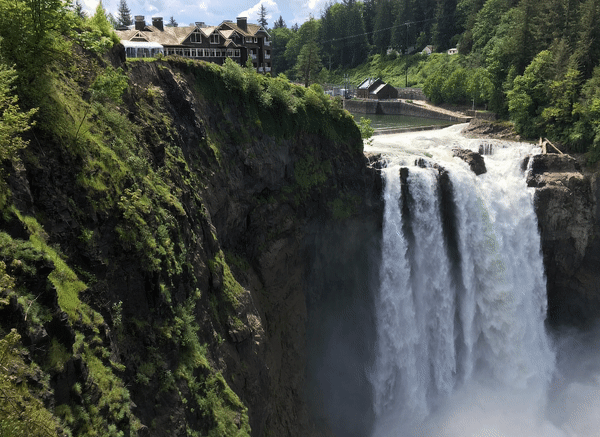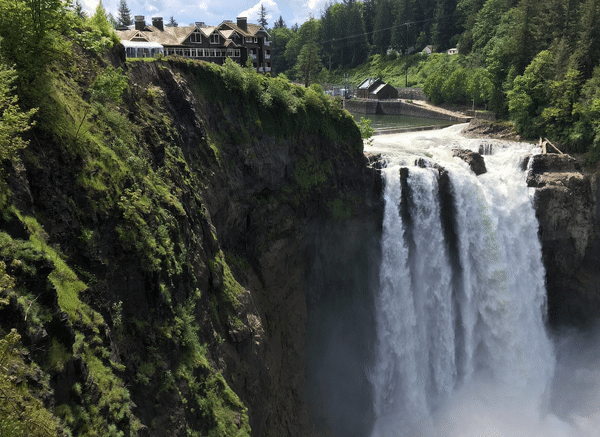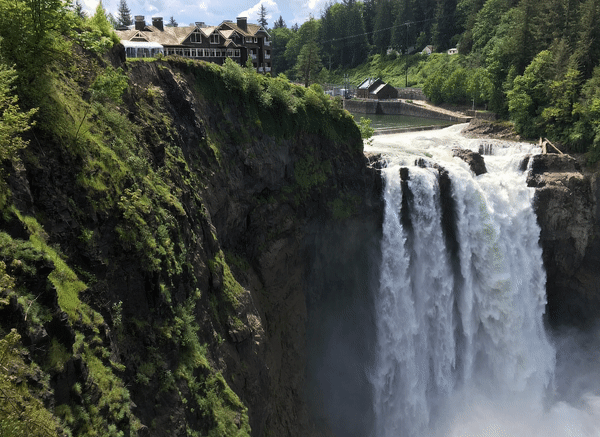
この技術により、途切れなくループする短い動画が作成され、終わりのない動きという印象を与えます。研究者らはこのアプローチについて、コンピュータビジョンとパターン認識に関する会議で発表する予定です。
「写真は、時間の中で凍結された一瞬を捉えたものです。しかし、静止画では多くの情報が失われます。この瞬間に至った経緯は何か、そして物事はどのように変化しているのか。何か本当に興味深いものに心を奪われた最後の時を思い出してみてください。おそらく、それは完全に静止していなかったはずです」と、ワシントン大学ポール・G・アレン・コンピュータサイエンス&エンジニアリング学部の博士課程学生で筆頭著者のAleksander Hołyński氏は述べています。
「私たちの手法の特徴は、ユーザーによる入力や追加情報を一切必要としない点です」とHołyński氏は述べています。「必要なのは写真1枚だけです。そして、出力として得られるのは高解像度で途切れなくループする動画であり、多くの場合、実際の動画のように見えます。」
写真を撮って、動画にする
単一の写真を説得力のある動画に変換する手法の開発は、この分野にとって課題でした。「それは実質的に、未来を予測することを求められるものです」とHołyński氏は述べています。「そして現実世界では、次に何が起こるかについての可能性はほぼ無限にあります。」
チームのシステムは2つの部分から構成されます。まず、写真が撮影された時点で物体がどのように動いていたかを予測し、その情報を用いてアニメーションを作成します。
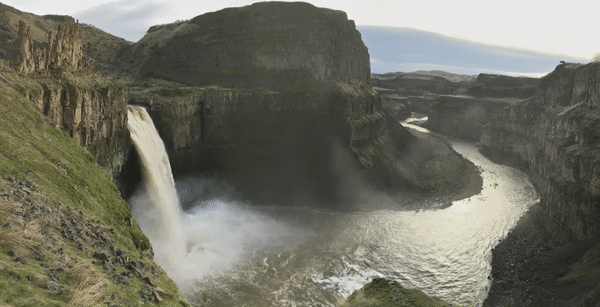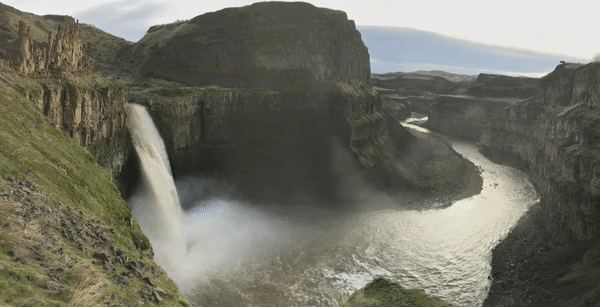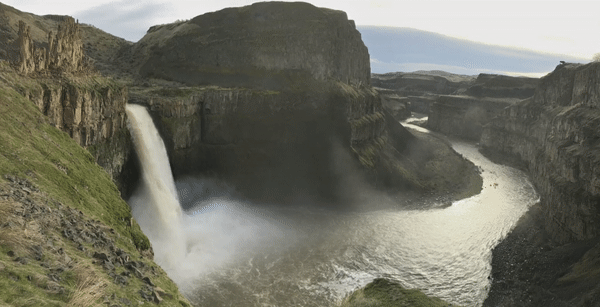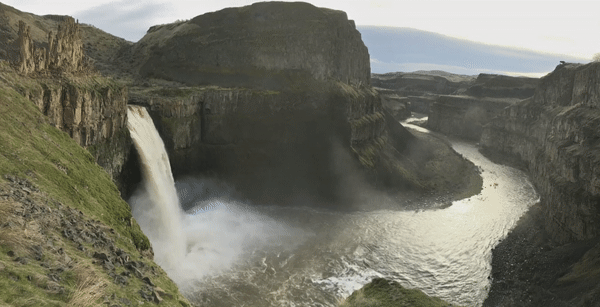
動きを推定するため、チームは滝、川、海など流体の動きを持つ数千の動画でニューラルネットワークを訓練しました。訓練では、最初のフレームのみが与えられた状態で、動画の動きを推測させました。予測と実際の動画を比較した後、ネットワークは手がかりを識別することを学習しました。例えば、小川のさざ波などがあり、次に何が起こるかを予測する助けとなります。その後、チームのシステムはこの情報を用いて、各ピクセルが動くかどうか、そしてどのように動くかを判断します。
研究者らは「スプラッティング」と呼ばれる技術を用いて写真をアニメーション化しようとしました。この手法は、予測された動きに従って各ピクセルを移動させます。しかし、これには問題が生じました。
「流れ落ちる滝を想像してください」とHołyński氏は述べています。「滝に沿ってピクセルを下方向に動かすと、動画の数フレーム後には、上部にピクセルがなくなってしまいます。」
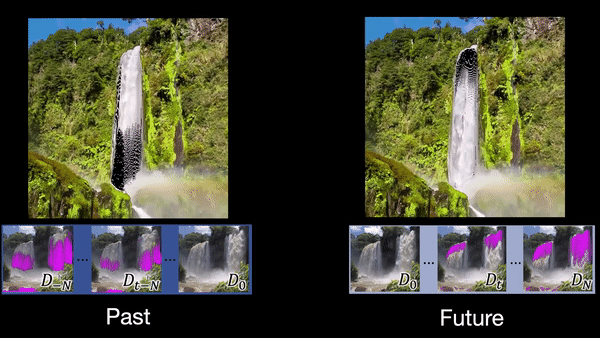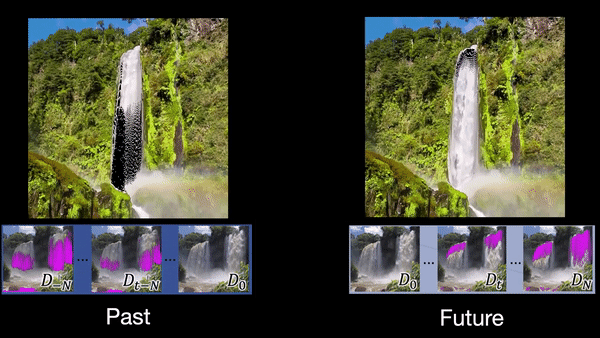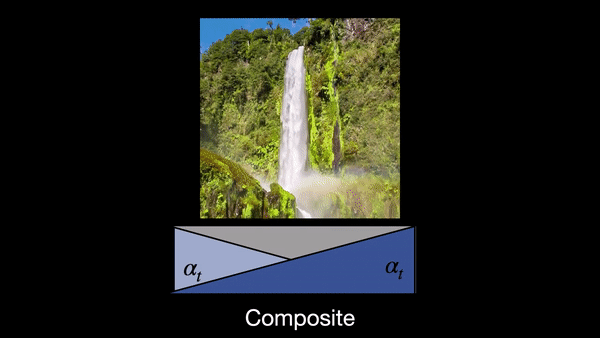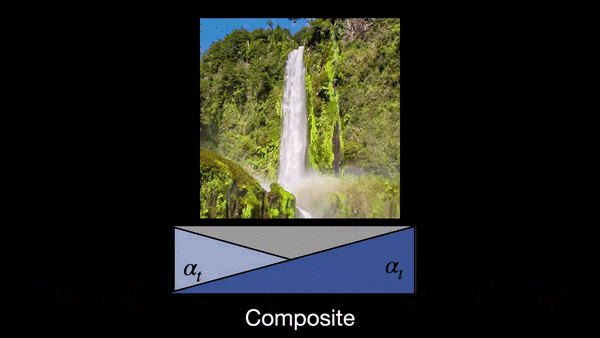
そこでチームは「対称スプラッティング」を考案しました。基本的に、この手法は画像の未来と過去の両方を予測し、それらを1つのアニメーションに統合します。
「滝の例に戻ると、過去へ移動すると、ピクセルは滝を上昇していくことになります。その結果、滝の下部付近に穴が見え始めます」とHołyński氏は述べています。「これら2つのアニメーションからの情報を統合することで、変形した画像に大きな穴が目立つことは決してありません。」
最後に、研究者らは連続した動きの印象を生み出すため、アニメーションが途切れなくループするようにしたいと考えました。アニメーションネットワークは、映像を整然と保つためにいくつかの工夫を用いています。例えば、フレームの各部分を異なるタイミングで切り替えることや、周囲の状況に応じて各ピクセルをどれだけ速くまたは遅くブレンドするかを決定することなどです。
風に揺れる髪
チームの手法は、予測可能な流体の動きを持つ対象に対して最も効果的に機能します。現在のところ、この技術は、反射がどのように動くべきか、あるいは水がその下にある物体の見え方をどのように歪めるかを予測することに苦慮しています。
「滝を見れば、水がどのように振る舞うべきかがわかります。火や煙についても同様です。これらの種類の動きは同じ物理法則に従っており、通常、画像の中には物事がどのように動くべきかを示す手がかりがあります」とHołyński氏は述べています。
「私たちは、風に揺れる人の髪をアニメーション化するなど、より幅広い対象を扱えるよう研究を拡張したいと考えています。いつの日か、友人や家族と共有する写真が静止画ではなくなることを期待しています。その代わりに、私たちの手法が生み出すような動的なアニメーションとして、すべてが映し出されるようになるでしょう」。
ワシントン大学リアリティラボ、Facebook、Google、Futurewei、Amazonがこの研究に資金を提供しました。




