必要なのは、生産性を高め、より大きなROIをもたらす人間中心のテクノロジーです。
データラベリングのパイプラインにML支援テクノロジーを組み込むことで、必要な時間、コスト、人員を削減できます。
貢献者がモデルの予測によって偏った判断をしてしまうのを防ぐ機会は数多くあります。
従来の機械学習(ML)手法では、人間が必要となるデータの一行一行すべてにアノテーションを付けるという、多くの場合時間がかかり高コストな作業を行います。成功するAIモデルには、数百万とまでは言わないまでも、数千単位の正確にラベル付けされた学習データが必要です。
AIへのアプローチを進化させる中で、このレベルの手作業は疑問視されるようになっています。
現在、最先端の事前ラベリングモデルが複数利用可能な基盤が整っているため、エンドツーエンドのAI導入サイクルにおけるプロセス改善にこれらを活用することが不可欠です。これらのモデルには、自動運転車の画像ピクセルラベリング用の事前ラベリング、画像および文書の文字起こし用の事前ラベリング、音声セグメンテーション用の事前ラベリングのほか、その他多数の事前ラベリングまたは分類モデルが含まれます。ツールを高度化するにあたっては、生産性を高め、より大きなROIをもたらす、ある種の人間中心のテクノロジーに投資する必要があります。
人間中心のテクノロジーは、オペレーターを障害ではなく資産とみなします。オペレーターのスキル、知識、柔軟性、創造性の価値を認めるものです。
人間中心のテクノロジーを最適化する目標は二つあるべきです。一つは、品質を犠牲にすることなく、より速く効率的なAIパイプラインを構築すること。もう一つは、しばしば反復的で精神的に消耗するラベリング作業の人的負担を軽減し、貢献者の公正な扱いを推進することです。動画へのアノテーションでは、多くの場合、動画を構成する個々のフレームに対し、アノテーションの変化をごくわずかに加えながらラベルを付ける必要があります。例えば、道路を走る車の動画は複数のフレームに分割され、それぞれの車両にラベルを付ける必要があります。短い動画であっても、構成するフレーム数を考えると、このような種類のアノテーションを手作業で行うのは非常に時間がかかります。機械学習を用いることで、アノテーション処理を自動化し、アノテーションの予測結果をフレームに即座に適用できます。これにより、アノテーターは一から アノテーションを作成する代わりに、必要に応じて調整するだけで済みます。
ML支援ツールは、人間中心のテクノロジーに向けた私たちの取り組みの基盤となるものです。データラベリングのパイプラインにML支援テクノロジーを組み込むことで、モデル構築におけるこの重要な工程に必要な時間、コスト、人員を削減できます。
これはまた、データアノテーションの品質と提供の自動化・改善の機会にもなります。このアプローチ(Appenでは「スマートラベリング」と呼んでいます)では、ジョブの開始前、実施中、完了後のそれぞれに重要な接点が存在します。
接点その1:ジョブ開始前
アノテーションジョブを実行する前に、事前学習済みモデルや学習可能なモデルを活用し、データラベルの初期仮説を立てることができます。手動でラベルを一から付ける工程とは異なり、貢献者は仮説の正確性を確認する作業を行うことになります。
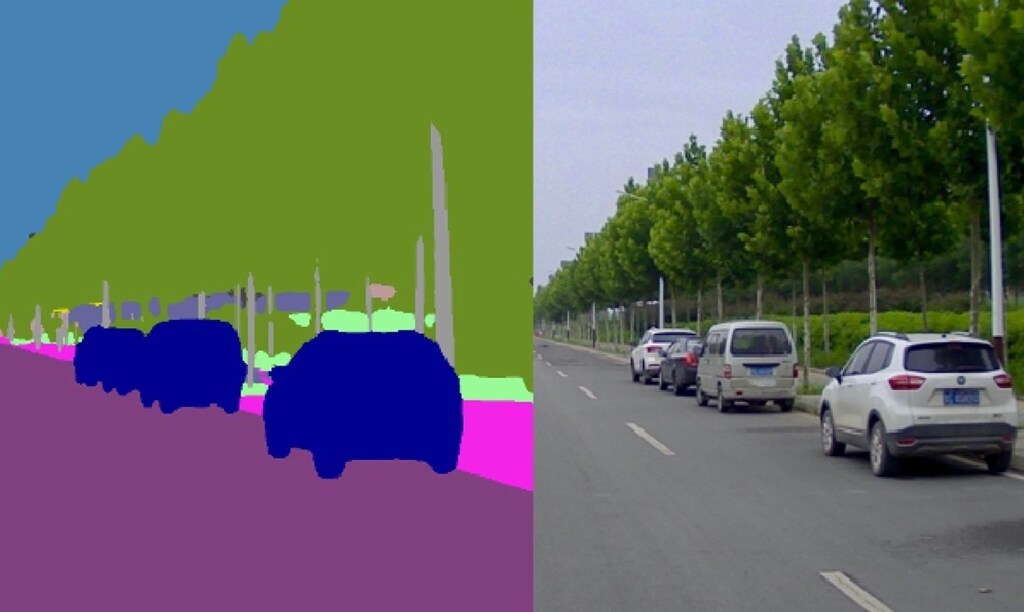
例えば、道路上の車を特定する画像アノテーションジョブに取り組んでいる場合、事前学習済みモデルを使って、対象物や車を事前に分類できます。
ユースケースに応じて、特定のタスクを遂行できるさまざまなモデルがあります。これらは、露骨なコンテンツの検閲から、個人情報のぼかし処理、物体へのバウンディングボックスの追加まで多岐にわたります。既存のモデルを使って初期のデータラベルを提供することで、アノテーション工程の一部を自動化し、時間とコストを節約できます。精度は、選択するモデルまたはモデルの組み合わせによって異なります。
しかし、モデルの予測によって貢献者が偏った判断をしてしまうのを、どのように防ぐのか、とお考えかもしれません。
実際、複数のアノテーションプロジェクトで大規模なA/Bテストを実施して検証したところ、その逆であることが判明しました。事前ラベリングを行ったデータは、ラベルの品質が向上したのです。言い換えれば、最終的なアノテーションを行う貢献者に渡す前に、MLモデルによって初期ラベルまたはアノテーションが付与されたデータは、初期ラベルのないデータよりも高品質なラベルとなりました。
自動運転車向けの画像ピクセルラベリングプロジェクトの一つでは、初期ラベリングにMLモデルを使用したところ、全試行において、貢献者の生産性が91.5%、アノテーションの品質が10%向上しました。
それでもチームが偏りについて懸念している場合は、パイプラインの次の二つの段階で、さらなる軽減策を講じる機会があります。
接点その2:ジョブ実施中
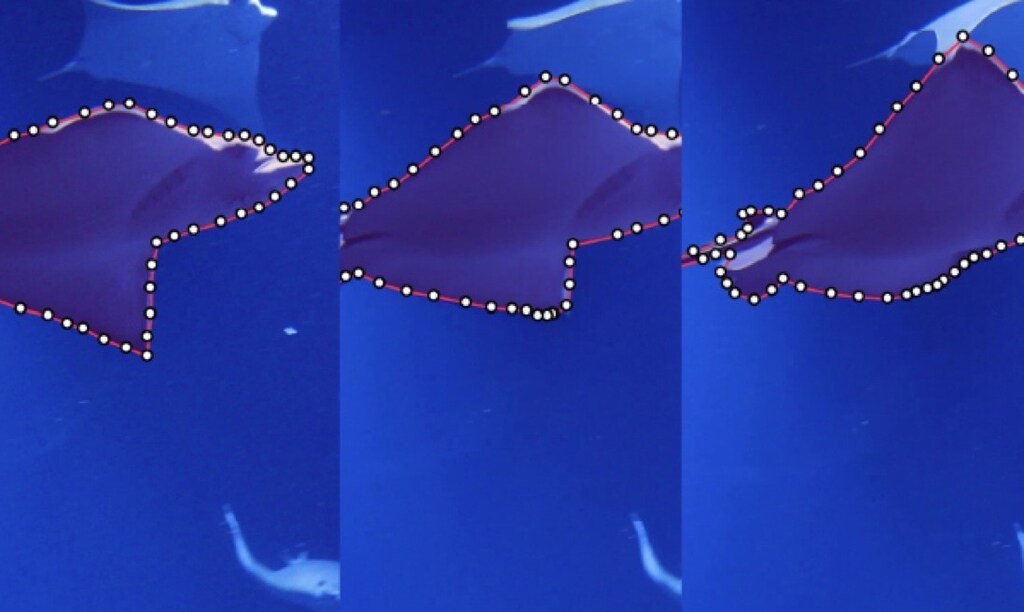
ジョブ内では、MLモデルを活用して人間の判断を支援できます。例えば、ジョブに動画アノテーションが含まれる場合、手作業のプロセスは次のようになります。動画をフレームごとのシーケンスに分割し、貢献者が各フレーム内の対象物すべてにラベルを付けます。
標準的なフレームレートである毎秒24フレームでは、このラベリング作業はすぐに骨の折れる反復作業となります。代わりにML支援テクノロジーを使用すれば、貢献者は対象物に一度ラベルを付けるだけで、モデルが後続のフレームにおけるその位置を追跡・予測できます。前述の道路上の車の例に従うと、貢献者は最初のフレームで各車にラベルを付け、モデルがその位置を追跡して残りのフレームの車にアノテーションを付けることになります。
その後、貢献者は残りのフレームのレビュー担当者としての役割を担い、必要に応じて修正を行います。
ジョブ中のML支援テクノロジーの助けにより、貢献者はより迅速に、かつより高い精度で作業できるようになります。この方法を用いると、品質を損なうことなく、手作業の方法と比べて最大100倍の速さでアノテーション作業を進めることができます。その恩恵は貢献者にも及びます。この方法は認知的負担を軽減し、作業全体を通じて快適さを向上させます。
最終接点:作業完了後
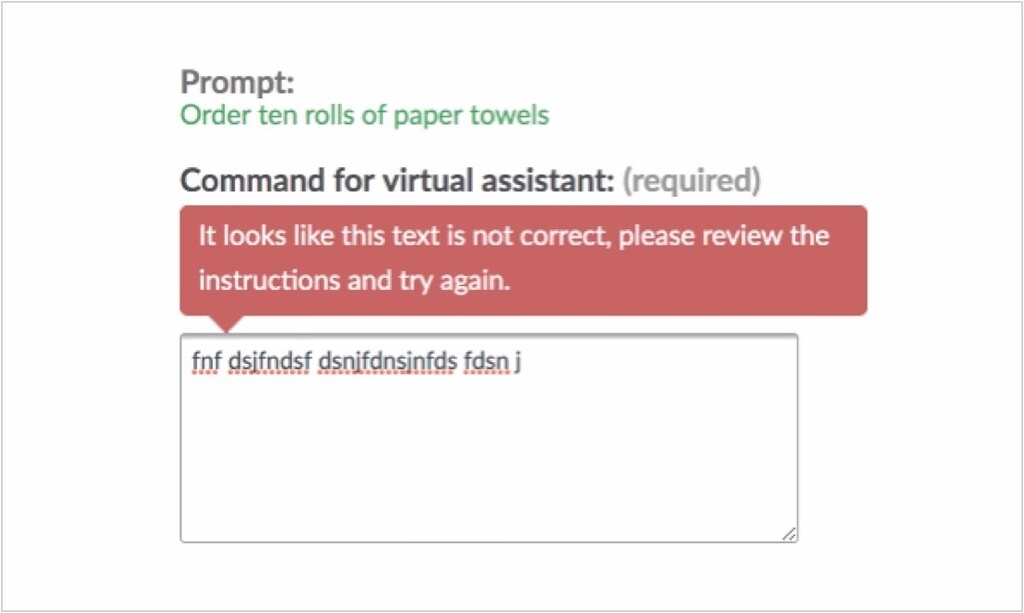
モデルと貢献者がデータに対する判断を行った後、検証フェーズに進むことができます。このステップでは、 MLモデルを使って行われた判断を検証し、貢献者の入力が想定される品質基準を満たしていない場合は、その旨を通知できます。
このアプローチには、いくつかの顕著な利点があります。特に、テスト問題やピアレビューが不要になり、要件に合わない判断に対して支払いを行ってしまうリスクも低減されます。モデルによる検証の後、貢献者はジョブを提出できます。
AIソリューションだけでなく、それを支えるプロセスの改善にも投資する必要があります。
Wilson Pang
例えば、テキスト発話プロジェクトを行う場合、設定した指標(一貫性や言語など)と組み合わせてML支援の検証ツールを活用できます。モデルは、これらの指標について正確性の要件を満たさないデータラベルにフラグを付けます。
その後、人間のアノテーターがラベルを確認し、修正します。Appenは、チャットボットの学習を含むテキスト発話プロジェクトにおいて、ML支援の検証ツールを試験的に導入しました。リアルタイムモデルを使用したところ、エラー率が35%低減しました。
「AIだけでなく、より優れたAIプロセスが重要なのです」
機械学習と、人間中心のテクノロジーという形での人的努力を組み合わせることが、AIイノベーションの進むべき道です。
アノテーションパイプラインにおけるML支援の機能は、企業と貢献者の双方に役立ちます。企業は、高品質なAIソリューションの立ち上げに必要なリソースを減らし、より迅速に行えます。また、貢献者は精神的負担や反復作業の少ない業務に取り組むことができます。後者は、AIプロジェクトに携わるすべての人々の公正なAIの実践を強化する上で特に重要です。
AIソリューションだけでなく、それを支えるプロセスの改善にも投資する必要があります。こうすることで、倫理的AIへのアプローチを進化させ、機械主導のソリューションによってグローバルな課題を解決する能力を加速させることができます。
AIは機械か人間のどちらか一方だけに頼るものではありません。むしろ、両者を組み合わせて活用することで、互いの強みを高め、成功につなげることができます。




