テクノロジーのトレンドに関して言えば、AIはここ数年、間違いなく先導的役割を果たしており、今後数十年にわたってもその地位を維持すると見込まれている。
自動運転車から予測医療、パーソナライズされた学習に至るまで、AIは日々の生活における実用的な側面と私的な側面の双方をますます形作っており、そこにはふさわしいパートナーとの出会いのマッチングも含まれる。AIについて語る際、私たちは多くの場合、応用事例に関心を寄せる。すなわち、AIは次に何を可能にするのか、という点である。強力なAIシステムやアプリケーションの構築競争において、テクノロジー分野の専門家を含む一般の人々は、AIとコンピューティングの密接な相互関係をしばしば軽視している。しかし、私たちが目撃しているAI革命は、コンピューティングのハードウェアとコンピューティング・エコシステムの進化なしには起こり得なかった。
AIとコンピューティングの関係
AIを簡単に言えば、コンピュータに人間の知能を模倣させることを目指すものである。その手法の一つが機械学習(ML)であり、これは、特定の作業を行うようあらかじめ明示的にプログラムされるのではなく、機械がデータから学習することを可能にする一連の統計的手法から成る。最も有名な機械学習の手法には、回帰モデル、決定木、ニューラルネットワークがあり、ニューラルネットワークは、入力データと出力データの間の関係パターンをモデル化する、相互に接続されたノードからなる適応的システムで構成される。多層ニューラルネットワークは、画像認識やテキスト生成などの複雑な作業を行ううえで特に重要である。これらは機械学習の一部を成すものであり、その基盤となるニューラルネットワークの深さから、ディープラーニング(DL)と呼ばれる。MLの手法全般、とりわけDLの手法は、データと計算資源を大量に必要とする。犬と猫の画像を分類する基本的なディープニューラルネットワークでは、犬と猫を見分ける4歳児の能力を模倣するために、学習データとして数十万枚の分類済み動物画像と、数十億回の反復計算が必要となる。この意味で、データとコンピューティングは、高性能AIシステムを構築するための柱をなしている。
AIを形作る主要なコンピューティングのトレンド
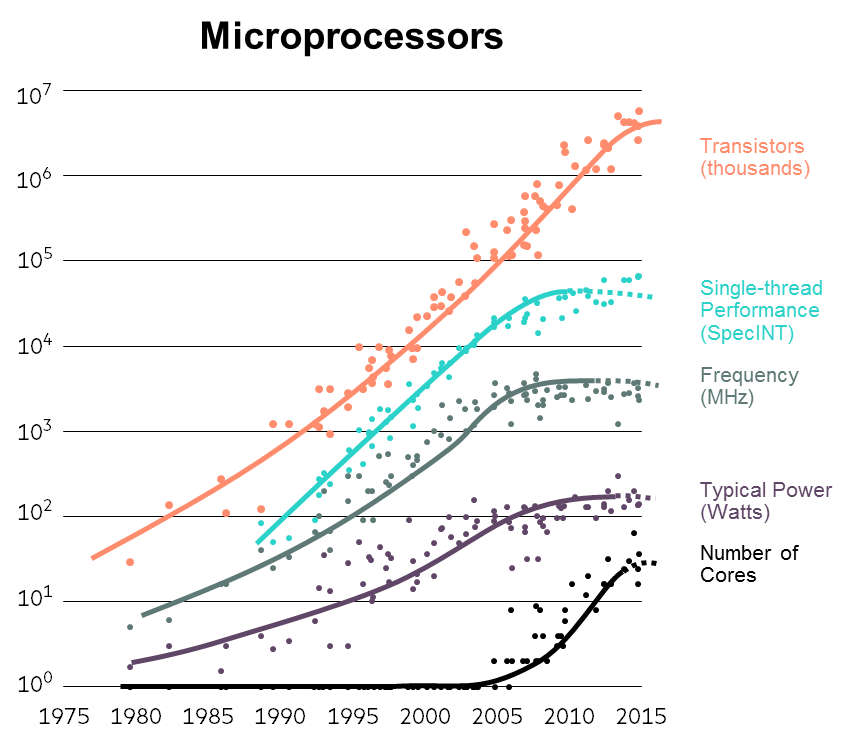
• ムーアの法則:インテルの共同創業者ゴードン・ムーアにちなんで名付けられたムーアの法則は、集積回路(IC)における平方インチあたりのトランジスタ数が、1960年代半ば以降、18か月から2年ごとに倍増してきたことを示している。ムーアの法則のおかげで、コンピュータは指数関数的な速度で小型化・高速化し、コンピューティングのコストを年間約30%削減するとともに、小型のICで複雑な数学的演算を実行することを可能にし、組み込み型でユビキタスなコンピューティングへの道を切り開いてきた。
• モノのインターネット(IoT):2020年までに400億台以上の(小型の)コンピュータがインターネットに接続されると見込まれる中、IoTはテキスト、音声、画像、その他の形式の学習データの収集を可能にしており、それらはMLやDLのモデルに供給され、これらのモデルの正確性と精度を高めている。
• 用途(およびAI)特化型コンピューティング・ハードウェアの台頭:コンピュータは多数の処理装置から構成され、各装置には一つまたは複数のコアやICが含まれる。CPU(中央処理装置)は、最も標準化された汎用のマイクロプロセッサであり、プログラムによってほぼあらゆる目的に使用できる。近年は、GPU(画像処理装置)やTPU(テンソル処理装置)を含む新しいタイプの処理装置が登場している。GPUやTPUは理想的にはCPUよりも多くのコアを備えており、集積回路(IC)レベルでは異なるトランジスタの配置構造を持つ。その特化したアーキテクチャのため、GPUやTPUは、画像処理や音声認識、さらに非構造化テキストのマイニングなど、計算負荷の高いディープラーニングの応用に特に適している。
• エクサスケール・コンピューティングの時代:データの爆発的増加とともに、AIやブロックチェーンといった応用分野におけるコンピューティング・ハードウェアの進化と計算ニーズが、HPEのような大手コンピューティング企業をスーパーコンピュータの構築へと駆り立てた。集中型データセンターに設置されるスーパーコンピュータは、少なくとも1エクサフロップス、すなわち毎秒10の18乗(100京)回の演算を実行する能力を備えている。この能力は、2008年に稼働を開始した最初のペタスケール・コンピュータと比べて千倍の向上を意味する。中国とEUも、エクサスケール・コンピューティングの競争に数百万ドル規模で投資している。
現状のコンピューティングが抱える課題
社内およびオンデマンドのクラウド・コンピューティングの高い利用可能性とコストの低下により、AI革命を実現するうえで、コンピューティングが希少な資源とみなされることはほとんどなくなってきた。しかし、コンピュータ・システムは、その上に構築されるAIアプリケーションの開発を遅らせかねない多くの制約に直面している。主な課題は以下のとおりである:
• ムーアの法則の終焉:物理的な限界により、トランジスタはある水準以下に微細化できず、これは予想より早くムーアの法則が成り立たなくなる可能性があり、マイクロプロセッサを無限に小型化する能力にも限界をもたらす。
• データ規制の強化:集中型スーパーコンピュータでのデータの高速なエクサスケール処理には、データをプロセッサの近くに保存することが求められる。欧州でのGDPRの最近の採択を含め、世界的にデータ規制への要請が強まっており、集中型のデータ配置はより困難になり、そもそもスーパーコンピュータを構築する目的そのものに疑問を投げかける可能性がある。
• データ転送と保存のコスト(および実現可能性):前項を踏まえると、学習データの膨大な量と、集中型プロセッサの近くにデータを転送する際の帯域幅コストにより、コンピュータのメモリや基盤となるI/O(入出力)操作の再設計、さらにはネットワーク容量への多額の投資が求められる。集中型スーパーコンピュータの運用には、OPEX(運用コスト)や環境コストも伴い、特に消費電力やCO2排出の発生という点で顕著である。
• コンピューティングを支えるエコシステムの欠如:IT人材が大手テック企業やAIスタートアップに流れる中、従来のコンピュータメーカーで働くこと、あるいは新しいコンピューティング・ハードウェアの開発に特化したスタートアップを立ち上げることへの意欲は低下しつつある。AI製品の試作を加速させている一方で、高水準のプログラミング言語、API、ライブラリの登場により、コンピュータサイエンティストの間でさえ、コンピューティング・アーキテクチャや基本的なコンピューティング操作に対する理解が浅くなる傾向が生まれている。
今後の道筋
集中型スーパーコンピューティングに伴う規制上の制約やエネルギーおよび帯域幅のコストは、データの保存とコンピューティングをエッジへと向かわせる可能性が高い。インテルはすでに、スマートカメラや拡張現実ハードウェアなど、エッジネットワーク機器上でコンピュータビジョンや画像認識を効果的に実行できるUSBスティックを開発している。
ムーアの法則の終焉が目前に迫る中、処理装置や個々の回路の構造の変更に焦点を当て、トランジスタやプロセッサのサイズをさらに縮小することなく性能向上を実現する、より特化したコンピューティング・アーキテクチャの登場が促される可能性が高い。
一方で、新しい形態のコンピューティングである量子コンピューティングが徐々に支持を広げつつあるが、その実用化は依然として課題である。量子コンピュータは、量子力学の不可思議な法則を活用することで、コンピューティングを再考するものである。従来のコンピュータが用いる二進数の単位を基に設計されたトランジスタを使う代わりに、量子コンピュータは「量子ビット」または「キュービット」を用いる。ビットは常に1か0のいずれかに限られるのに対し、キュービットは「重ね合わせ」の状態をとることができ、これにより複数の状態を同時にシミュレートできる。量子レベルにおけるもう一つの物質の性質である「量子もつれ」は、複数のキュービットを論理ゲートによって接続できることを意味する。量子コンピューティングの「重ね合わせ」と「もつれ」という性質により、1つのキュービットおよび多数のキュービットのレベルの双方で、多くの演算の流れを並列に実行することが可能になり、その結果、従来のコンピュータと比べて、量子コンピュータは複雑な計算問題に取り組むのにより適したものとなる。とはいえ、「汎用」量子コンピュータを物理的に構築することは、工学的に極めて困難なままである。キュービットの生成と維持には、極限状態における安定したシステムが必要であり、例えば、構成要素の温度を絶対零度に極めて近い状態に保つことが求められる。
より多くの人々がSTEM分野に進むよう促し、テクノロジー人材を確保することは、コンピュータ製造業界に対し、自らを変革し、AI革命のニーズに対応し続けるために必要な人材をもたらすであろう。
最後に、MLモデルを構築しアルゴリズムを記述する際、データサイエンティスト、コンピュータサイエンティスト、MLエンジニア、AI実務者は、目の前の問題を解決するための最も単純な方法を検討すべきである。回帰で十分な精度が得られたはずの場面で複雑なニューラルネットワークを用いたり、週次のデータ更新で足りたはずの場面で日次のデータパイプラインを稼働させたりすることは、テクノロジー人材が、日々、コンピューティングという希少な資源を浪費していることの現実の例である。テクノロジー・エコシステム内でコンピューティングに配慮した実践を推進することは、テクノロジー業界が、とりわけAIの分野で自らの成長を持続させるための必須事項となっている。




