人類は数千年にわたり水質の問題と向き合ってきました。紀元前4〜5世紀には、近代医学の父ヒポクラテスが不純な水と病気の関連を指摘し、最古の水のろ過装置の一つを考案しています。今日、この課題は大きく、生物多様性や多くの人間社会に存亡の危機をもたらすとともに、経済の発展と人々の暮らしの持続可能性をも脅かしています。
汚染された水域がもたらす経済的・人的コストの増大
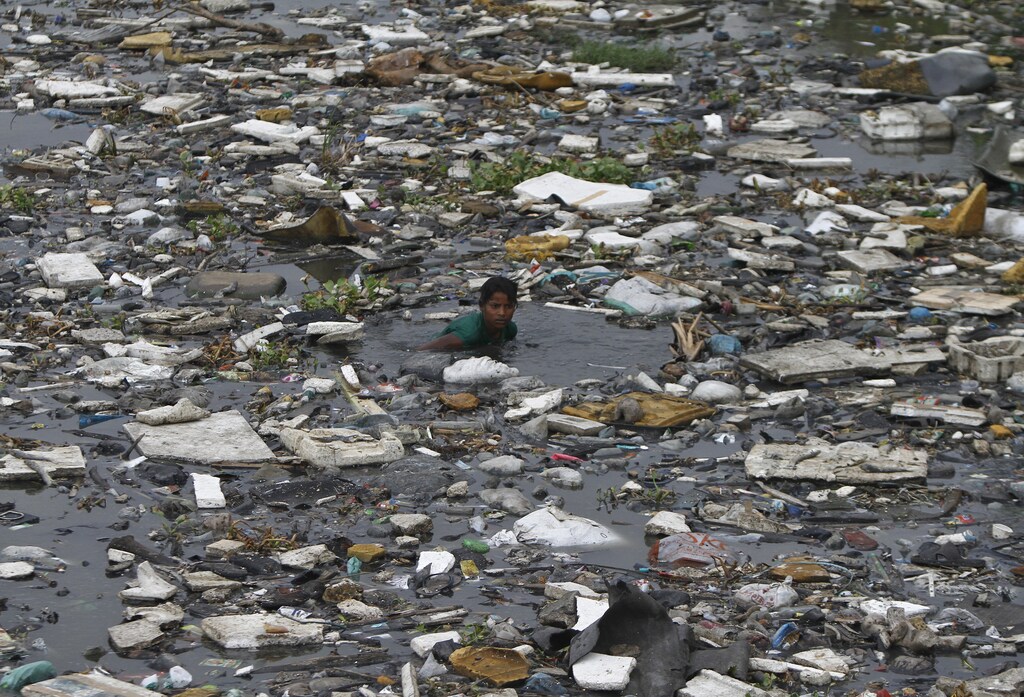
インドでは都市化と人口増加に伴い、水域の汚染が深刻化しています。インドの地表水の約70%は飲用に適さないと推定されています。毎日、約4,000万リットルの排水が河川やその他の水域に流れ込んでいます。そのうち適切に処理されているのはごくわずかです。世界銀行の最近の報告書によると、上流での汚染物質の排出は下流地域の経済成長を低下させ、これらの地域のGDP成長率を最大で3分の1押し下げるとされています。さらに深刻なことに、インドのように水質汚染がより大きな問題となっている中所得国では、その影響はGDP成長の約半分を失うほどに拡大しています。別の研究では、インドにおいて汚染された水域の下流に位置することは、農業収入の9%減少および下流の農業収量の16%低下と関連していると推定されています。
インドにおける環境悪化の経済コストは、年間3兆7,500億ルピー(800億ドル)と推定されています。水質汚染に関連する医療費だけでも、年間約4,700億〜6,100億ルピー(67億〜87億ドル)と推定されています。その多くは、5歳未満の子どもの下痢による死亡と罹患、およびその他の人口の罹患に関連しています。経済的コストに加え、インドでは水、衛生設備、衛生習慣の不足により、年間40万人の命が失われています。世界全体では、5歳未満の子ども150万人が死亡しており、水関連の疾病により、毎年2億日分の労働時間が失われています。
高解像度モニタリングによる技術の活用
河川を浄化するための効果的な施策を講じるには、意思決定者に対して、高頻度で、細分化された形で収集された、信頼性が高く、代表性と包括性を備えたデータを提供する必要があります。従来の水質モニタリングの手法は、時間がかかり、手間がかかり、高価で、人為的ミスも起こりやすいものです。インフラやリソースの不足により、検査できる試料の数は限られています。データは多くの場合、表形式でのみ提供され、それを裏付けるメタデータはほとんど、あるいはまったくありません。そのため、データの質と完全性は低いままです。
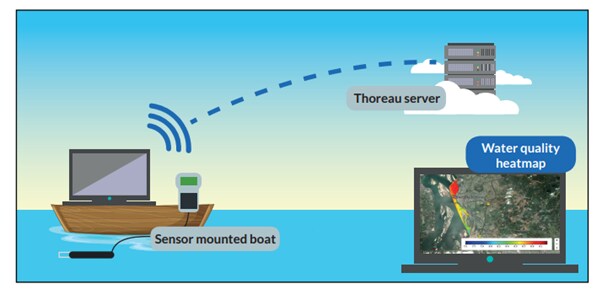
自動化された、地理タグ付けおよびタイムスタンプ付きのリアルタイムセンサーを、固定されない方式でデータ収集に用いることで、シカゴ大学のタタ開発センターの研究チームは、河川における汚染のホットスポットを特定し、局所的な汚染の広がりを把握することができました。時間と空間を通じた河川水質の高解像度マッピングは、規制遵守に関する意思決定を支援するツールとして、また生態系悪化の早期警戒指標として、さらには衛生施策の有効性を評価する信頼性の高い仕組みとして、注目を集めつつあります。データの可視化によって理解を促し、オープンアクセスのデジタルプラットフォームを通じてデータを公開することで、すべての関係者の間で信頼が築かれています。
機械学習によってどのような洞察が得られるか
データを収集し、分かりやすい形で可視化することに加えて、このような高解像度データに機械学習モデルを適用し、水質を予測することも可能です。水中の有機物含有量を示す生物化学的酸素要求量(BOD)など、一部の重要なパラメーターについては、利用可能なリアルタイムセンサーが存在せず、実験室で結果を得るまで最大5日を要することがあります。これらのパラメーターは、即座に値が得られる他のパラメーターから、リアルタイムで予測できる可能性があります。十分に開発され、検証された後には、このような機械学習モデルは、時間的・空間的な中間値を予測できるようになると考えられます。
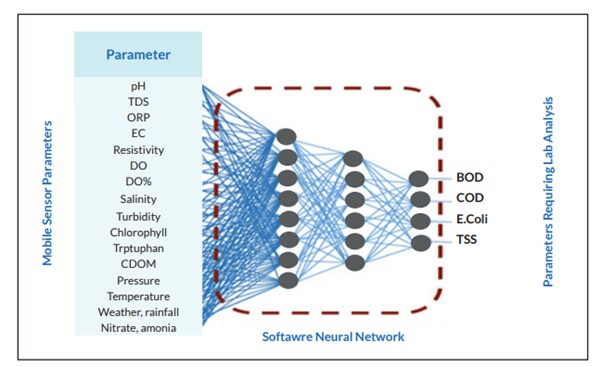
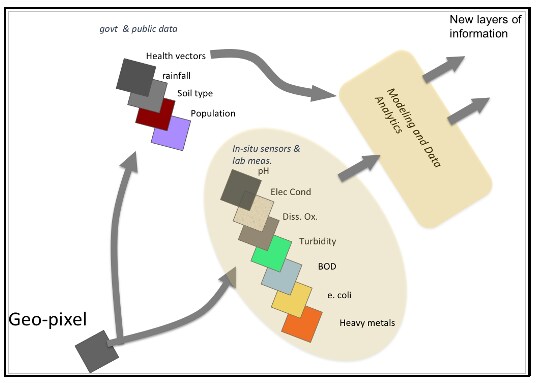
さらに、降雨パターン、地域の気温、近隣の工場、農地の状況といった他の層のデータを加えることで、データセットの統計分析をより豊かなものにできる可能性があります。ペンシルベニア大学プリツカー分子工学部のスプラティック・グハ教授が呼ぶところの新しい架空の「ジオピクセル」は、GPS(全地球測位システム)の位置ごとに情報の垂直な層を備えています。これらを組み合わせることで、その地点の水質と変化傾向の全体像を示すことができます。
技術と公共政策
大まかに言えば、機械学習は政策立案者が推定や予測の問題に取り組む助けとなり得ます。従来、水質汚染の測定は、試料採取と実験室での検査による推定が中心でした。私たちの技術によって、こうした推定の範囲と頻度は大幅に拡大しつつあります。さらに、私たちはそれ以上のことも目指しています。機械学習モデルによって、水質汚染データの様相を根本から変えうる予測モデルの構築を試みています。また、拡張された推定・予測用の機械学習ツールは、新たなデータや手法をもたらすだけでなく、新たな問いや政策課題に焦点を当てることを可能にするかもしれません。マクロな視点では、本プロジェクトを超えて、機械学習の文化をインドの公共政策に根付かせることを目指しています。
データの開示と公共政策
環境をめぐる議論において、情報へのアクセスは気候変動運動の始まり以来、重要な要素となってきました。「情報は参加の効果を高める」という考え方は、経済学やその他の社会科学の文献で広く受け入れられています。信頼できるデータの入手は効率的な規制に向けた最も重要な一歩である一方、プロセスを透明化し、データを一般に公開することには、さらに多くの利点があります。そのような開示は、環境対策の成果をめぐる業界間の競争を生み出します。また、市民社会団体や一般市民、投資家、同業の工場からの世論の圧力につながり、汚染者をより良い行動へと促すことにもなります。