デジタルの進歩が、必ずしもデジタルの公平性につながったわけではない。
今後のデータガバナンスは、所有権と管理権の問題を超える必要がある。
個人と機関の間の力の均衡に取り組む必要がある。
データは世界で最も価値のある通貨となっている。前例のない規模と速度で生み出されており、わずか1日の間に、およそ5億件のツイートが投稿されている。約2940億通のメールが送信され、50億回の検索が行われている。私たちは毎日、2.5クインティリオンバイトの情報を生み出している。
データのもつ力は計り知れないが、私たちのデータを意図的または無意識に手放すことの影響(プライバシー、セキュリティ、あるいは社会全般への影響を問わず)は、10年前には考えられなかったような、基本的人権に対する数多くの課題を突きつけている。
データとその人権への影響を巡る問題は、公共の議論においてまだ新しいものである。より本質的な問いの中には、すぐには明らかにならないものもある。こうした認識のもと、私たちが答えるべき重要な問いを4つ挙げる。
誰が私たちのデータを本当に「所有」しているのか。
ケンブリッジ・アナリティカのスキャンダルを受けた反発のおかげで、データの所有権という問題は身近なものとなった。個人データの利用、悪用、管理の不備に対する世論の高まりを受けて、次のような規制が導入されている。例えば、EUではGDPRが導入された。
しかし、データの所有権は、「あなた」と「あなたのデータ」という二項対立の関係を超えるものである。他の財産とは異なり、データは複数の人が同時に所有することができる。データを手放しても、自分の手元にも残すことができる。さらに、データはあなた自身についてのものであると同時に、他の人々についてのものでもありうる。友人や家族のためにオンラインで購入したプレゼントは、その人たちが誰であり、何を好み、どこに住んでいるかという情報を共有したことを意味する。
さらに、このデータがどのように生成されるのかという複雑な問題もある。能動的または受動的に提供したデータとの関連は明らかである。しかし将来的には、あなたに関する機械生成データが個人データとみなされるようになるのだろうか。その場合、誰がそれを所有するのか。
最後に、あなたのデータが、NHS(英国国民保健サービス)のような機関によって収集されたデータセットの一部となった場合はどうなるのか。そのデータは、あなたに属するのか、その集団に属するのか、それとも データを収集し、その価値を高めうる人々に属するのか。
結論として、データの所有権という問いは、そもそも適切な問いではないのかもしれない。
同意は管理を意味するのか。
あなたは、Cookieの使用やFacebookでの情報共有に同意しており、利用規約によって、投稿するすべてのコンテンツと情報を所有しているという説明に安心しているかもしれない。しかし、個人情報をいつ共有するかを管理できても、その後それがどのように利用されるかを管理できるとは限らない。
あなたのデータは、他のデータと組み合わされて、アルゴリズムの情報として使われ、そのアルゴリズムは、給与、健康状態、仕事への適性など、あなたに関する推定を行う。権力は消費者から企業へと移ってしまった。
例として中国企業Ping-An、世界最大の保険会社であり、顔認識を通じて顧客を登録している。同社が使用するソフトウェアは、個人の体脂肪率を算出でき、それによって保険料が決まる。これは企業にとっては有益かもしれないが、消費者にとってはどのような意味を持つのだろうか。
「プライバシー」という概念は、急速に時代遅れになりつつあるのかもしれない
アルゴリズムによって行われる私たちに関する推定が有用であることは間違いないが、不正確であったり、不当に重み付けされたりする可能性もある。例えば米国では、一部の管轄区域において、リスク評価アルゴリズムが、暴力犯罪の発生場所を予測するだけでなく、犯罪者が再犯するかどうかを予測するためにも使用されており、これは判事が量刑を決定する際の判断材料として用いられている。ここでは、個人が自身のデータだけでなく、他者との類似性に基づいて判断されているのである。
これは、アルゴリズムがどのように最適化されるかという透明性の問題とも関連している。例えば現在、米国の規制当局は、Appleの新しいクレジットカードが女性に対して偏っているかどうかを調査している。これは、あるユーザーが、実際にはより良い信用スコアを持つ妻より20倍高い利用限度額を提示されたという苦情を受けてのものである。この点について問われた際、同社は不一致を説明することなく、アルゴリズムのせいにする対応をとった。ここでの「同意」は意味をなさず、確かに「管理」にはつながらない。
私たちのプライバシーの権利はどうなるのか。
「同意」という概念に欠陥があるならば、プライバシーに関する議論も同様に欠陥がある。昨夜参加したパーティーの写真を共有したくないと思っていても、他の参加者がソーシャルメディアに写真を投稿し、そこにあなたが写っている場合はどうなるのか。オプトアウトの決定をしても、あなたに関して共有されるデータを管理することはできない。
あなたが行使できる唯一の真の管理は、データを完全に非公開にしておくことだろう。しかし、オプトアウトは機会を逃すことにもつながり、現実的には実行することがほぼ不可能である。さらに、あなたがデータを持たないことで、企業、政府、あるいは他者に関する膨大なデータを収集する機関によって、あなたについての推定が行われることを止めることはできない。
私たちは、人権の枠組みからプライバシーの権利を単純に導き出し、それをデジタル領域に適用しようとすることはできない。私たちは、自分自身のデータによって影響を受けるのと同様に、他者に関するデータによっても影響を受けている。したがって、「プライバシー」という概念もまた、急速に時代遅れになりつつあるのかもしれない。
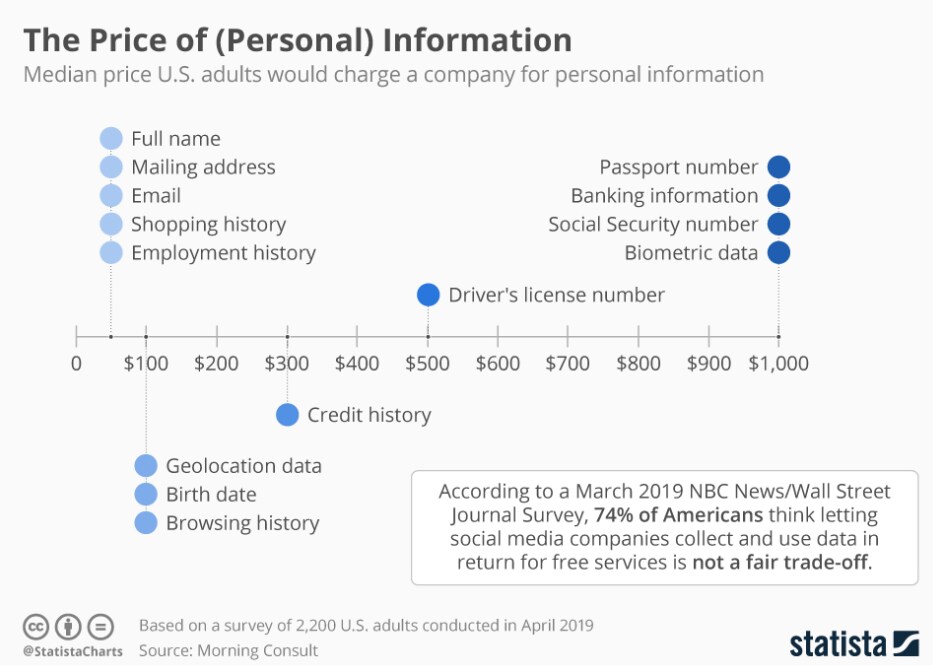
データに対して補償を受けることはできるのか。
個人が自身のデータのやり取りから利益を得ていない今日のデータ経済において、より公平な結果をどのように確保できるだろうか。個別化されたデータは集合的なデータほど価値がないと理解すると、この問題はさらに複雑になる。例えば、健康データセットは大きな社会的・経済的価値を持つ。しかし、それを生み出した人々は、その対価として、どのように補償されているのだろうか。
次のように主張する意見もある。データは労働として扱われるべきであるという意見である。個人が透明性のある方法でデータを提供する積極的な参加者となり、その貢献に対して、データ「ユニオン」または「トラスト」を通じて集団的に報酬を受け取るというものだ。これにより、デジタルシステムの情報として使用されるデータの質が向上するだけでなく、大手テクノロジー企業と個々のデータ提供者との間の大きな格差を縮小し、より公平な経済システムを実現することができる。
規制を求める声も高まっており、例えば「データ権利章典」の策定を求める声がある。データ権利章典は、例えば、不当な監視や不公正な差別のために使用されるデータから個人を保護するものである。
全体として、デジタルの進歩は必ずしもデジタルの公平性をもたらしてはいない。技術革命が自由なコミュニケーション、つながり、情報によって市民社会に力を与えてきたことに疑いはないが、同時に誤情報、監視、支配の手段にもなっている。
今後のデータガバナンスは、所有権と管理権の問題を超える必要がある。データ収集が社会にもたらす巨大な集合的利益を認識する必要があり、また、個人データと大規模データセットを区別するとともに、個人と社会の利益のバランスを取る必要がある。何よりも、個人と機関の間の力の均衡に取り組む必要がある。




