ほんの少し前まで、私たちは完全にアナログな世界で暮らしていました。電話からテレビ、書籍からバインダーに至るまで、デジタル技術は主に研究室に追いやられていたのです。
しかし1960年代には、会計、給与計算、在庫管理といった業務を担うコンピューティングが、大規模組織のバックオフィスに入り始めていました。それでも当時の大半のシステム(医療システム、送電網、交通網など)や、私たちが日常的に接するテクノロジーは、依然としてアナログでした。
それから一世代が過ぎた今日、私たちの世界は高度にデジタル化しています。0と1は私たちの生活のすみずみにまで行き渡っています。コンピューティングは、医療や製造業から通信、スポーツ、エンターテインメント、メディアに至るまで、人間の活動のほぼあらゆる側面に入り込んでいます。
スマートフォンを例に考えてみましょう。登場してから10年に満たないこのデバイスが、どれだけ多くの別々のアナログ製品を置き換えてきたことでしょうか。道路地図、カセットプレーヤー、ノート、住所録、新聞、カメラ、ビデオカメラ、絵はがき、羅針盤、日記、ボイスレコーダー、ポケットベル、電話、さらには水準器までです!
これを支えてきたのは、もちろんインターネットの爆発的な普及です。人間によるインターネットの利用に加え、あらゆる種類のデバイス、機械、システムを相互に接続する、いわゆる モノのインターネット (または「産業のインターネット」あるいは「インターネット・オブ・エブリシング」)。
複雑なシステム
私たちは今、ほとんどのシステムに計測機器が組み込まれ、膨大な量のデジタルデータを生み出す時代に生きています。このデータを分析することで、アナログの世界では決して不可能だった方法で、これらのシステムに関する洞察を得られるようになりました。
データサイエンスは、統計学、機械学習、アナリティクス、可視化といった分野を統合し、この分野に厳密な基盤を与えつつあります。これはちょうど、1950年代にコンピューターサイエンスが登場してコンピューティングを下支えしたのと同じやり方です。
これまでも私たちは、物理現象を説明し予測するための複雑な数理モデルの開発に成功してきました。例えば、橋の強度や化学分子の相互作用を正確に予測できます。
また、天気は予報が極めて難しいことで知られています。それでも、数値天気予報モデルと大量の観測データ、そして高性能コンピューターに基づいて、予報精度は向上してきました。今日の5日先の予報は、20年前の2日先の予報と同程度に信頼できるものになっています。
しかし、その基礎となるモデルを定義するのが容易でない問題も多く存在します。医療システムやサイバー犯罪のパターンを特徴づける一連の数式は存在しません。
とはいえ、私たちが手にしているのは、無数の情報源から集められるデータの量が増加しているという事実です。課題は、そのデータが多様な形式を取り、多くの情報源から異なるスケールで得られ、誤りや不確実性を含んでいる点にあります。
そのため、橋や化学的相互作用に対して行ってきたように決定論的モデルの開発を目指すのではなく、データ駆動型モデルを開発することができます。これらのモデルは、さまざまな情報源からのデータを統合し、データに含まれる誤りや不確実性を考慮することができます。特定の仮説に照らしてこれらのモデルを検証し、洗練させることも可能です。
また、これらのモデルと、それを支えるデータの両方を検討することが極めて重要です。
360度のデータ
私の大学では、データの探索と可視化を可能にするために「Data Arena」を構築しました。この施設は、オープンソースソフトウェア、高性能コンピューティング、映画の視覚効果の技術を活用し、データの流れを、高さ4メートル、直径10メートルの円筒形スクリーンに2,400万画素を投影する、完全没入型の3Dステレオ映像システムにマッピングしています。
この施設の中央に立ち、リアルタイムでデータとやり取りすることは、非常に力強い体験です。すでに私たちは、高解像度の光学顕微鏡からデータを取り込むパイプラインを構築し、研究者が細菌の表面上での移動の仕組みを理解する手助けをしてきました。
私たちは、Wombeyan Cavesをスキャンしていた CSIRO Zebedee が収集した2,200万点のデータを読み込みました。そして10分後には、3Dで洞窟の中を飛び回り、地下を探検していました。
どのような種類のデータを探索してきたとしても、私たちは必ず何か興味深いものを発見してきました。
いくつかのケースでは、データに誤りがあることがすぐに明らかになりました。ある天文学のデータセットでは、膨大な数の重複データ点が含まれていることがわかりました。その他の状況では、データを分析していた分野の専門家には明らかでなかったパターンを観測しました。
この現象は、典型的な「未知の未知」です(2002年に米国国防長官ドナルド・ラムズフェルドによって有名になった概念)。そして、パターンや異常を見つけ出す人間の視覚システムの力を浮き彫りにしています。
今日の世界はデータにあふれています。それは新たな可能性と、研究や理解の新たな道筋を切り開いています。それらすべてを有効に活用するためには、これほど途方もない量のデータを管理できるツールが必要です。私たちの目もそうしたツールの一つですが、その目でさえ、Data Arenaのような空間が提供する支援を必要としています。
本記事は、 「The Conversation」との協力により掲載されています。掲載は、世界経済フォーラムによる見解の支持を意味するものではありません。
The Agenda の最新情報を追うには、 週刊ニュースレターを購読してください。
執筆者:Glenn Wightwick は、シドニー工科大学(University of Technology, Sydney)の研究担当副学長です。
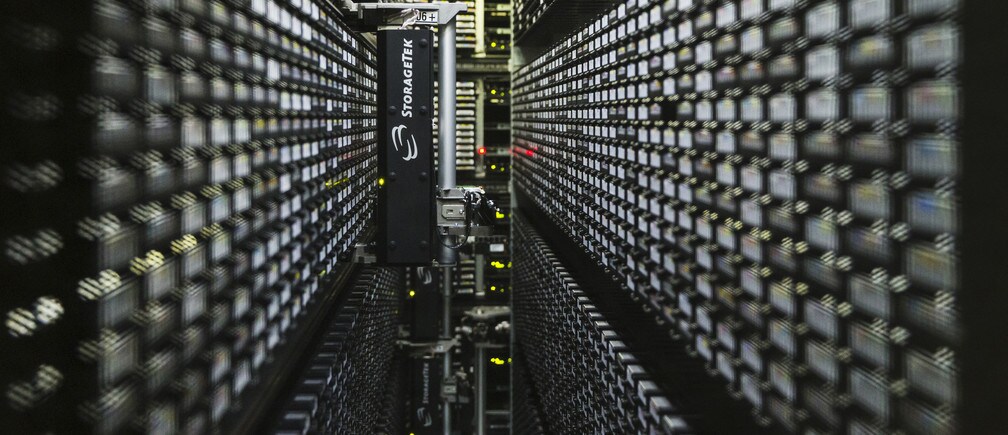
画像:デジタルデータの大容量保存に使用されるロボット式テープライブラリが、2013年8月13日にベルリンの Konrad-Zuse Centre for applied mathematics and computer science(ZIB)で撮影されています。 REUTERS/Thomas Peter.


