新たな研究は、幼い子どもでも難なくこなすある種の課題を、コンピューターがなぜ苦手とするのかを明らかにする。その課題とは、画像内の2つの物体が同じか異なるかを判定することだ。
「コンピュータービジョンが成し遂げてきたことには、大きな期待が寄せられています……」
コンピュータービジョンのアルゴリズムは、この10年で大きく進歩した。犬種や猫種を分類するような課題では、人間と同等かそれ以上の能力を示しており、何百万もの顔の中から特定の顔を識別できるという驚くべき能力も備えている。
先週開かれた認知科学会の年次総会で発表した論文で、研究チームは、コンピュータービジョンのアルゴリズムが比較課題で失敗する理由を検討し、より賢いシステムへの道筋を示している。
こちらとあちら
ブラウン大学で認知・言語・心理科学の准教授を務め、論文の責任著者でもあるトーマス・セール氏は、「コンピュータービジョンが成し遂げてきたことには大きな期待が寄せられており、私もその期待を共有しています。しかし、ここで行ったように、現在のコンピュータービジョンシステムの限界を理解するために取り組めば、既存のシステムに手を加えるだけでなく、まったく新しく、はるかに高度なシステムへと本当に前進できると考えています」と述べる。
何十万もの訓練例を与えた後でさえ、アルゴリズムが適切な関係を認識する精度は、偶然を上回らなかった。
この研究で、セール氏と同僚たちは最先端のコンピュータービジョン・アルゴリズムを使い、ランダムに生成した2つ以上の図形を含む、単純な白黒画像を分析した。物体が同一の場合もあれば、一方をもう一方に対して回転させただけで同じ場合もあり、まったく異なる場合もあった。コンピューターには、それらの関係が同じか異なるかを特定するよう求めた。
研究の結果、何十万もの訓練例を与えた後でさえ、アルゴリズムが適切な関係を認識する精度は偶然を上回らないことが分かった。そこで、なぜこれらのシステムはこの課題がこれほど苦手なのかが問われた。
セール氏と同僚たちは、その理由はコンピュータービジョン・アルゴリズムが物体を個別に捉えられないことにあるのではないかと考えた。コンピューターは画像を見ても、画像内のある物体がどこで終わり、背景や別の物体がどこから始まるのかを実際には判別できない。学習を通じて特定のラベルと結び付けた画素の集まりに似たパターンを持つ、画素の集まりとして見ているだけだ。
これは識別や分類の課題ではうまく機能するが、2つの物体を比較しようとすると破綻する。
一つずつ
これがアルゴリズムのつまずく本当の理由だと示すため、セール氏と研究チームは、コンピューターが自力で物体を個別に捉える必要をなくした実験を行った。同じ画像に2つの物体を見せる代わりに、別々の画像で物体を一つずつ見せた。
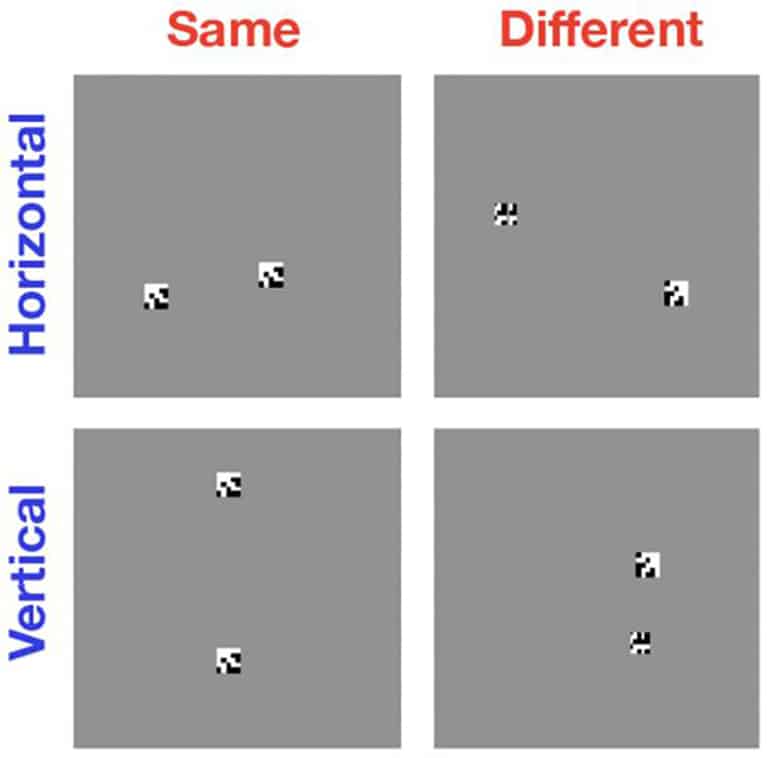
実験では、2つの物体を同じ画像の中で見る必要がなければ、アルゴリズムは同じか異なるかという関係を問題なく学習できることが示された。
セール氏によると、物体を個別に捉える際の問題の原因は、アルゴリズムを動かす機械学習システムのアーキテクチャにある。アルゴリズムは畳み込みニューラルネットワークを使う。これは、脳内のニューロンのネットワークを大まかに模した、相互に接続された処理ユニットの層だ。脳との主な違いは、人工ネットワークが全面的に「フィードフォワード」であること、つまり情報がネットワークの層を一方向にしか流れない点にある。セール氏によれば、人間の視覚系はそのようには働かない。
「私たち自身の視覚系の構造を見ると、高次の視覚領域から低次の視覚領域へ、そしてまた戻るように情報が流れる、反復的な結合が数多くあることが分かります」とセール氏は述べる。
こうしたフィードバックが正確にどのような働きをしているかは明らかでないが、視野の特定の部分に注意を向け、心の中で物体の心的表象をつくる能力に関係している可能性が高いと、セール氏は言う。
「おそらく人は一つの物体に注意を向け、その物体と結び付いた特徴表象を作業記憶の中に形成します」とセール氏は述べる。「次に、別の物体へ注意を移します。両方の物体が作業記憶に表象されると、視覚系は同じか異なるかといった比較ができるのです。」
セール氏と同僚たちは、コンピューターがそれに似たことをできないのは、フィードフォワード型のニューラルネットワークでは、物体を個別に捉えて心的表象を形成するのに必要な種類の反復処理ができないからだと仮説を立てている。コンピュータービジョンをより賢くするには、人間の視覚処理に見られる反復的な性質をより忠実に再現するニューラルネットワークが必要になる可能性がある、とセール氏は述べる。
この研究は、全米科学財団とDARPAの助成を受けた。




