未来についての予測は計画を立てるうえで重要です。そこで今日は、今後5年間に機械が人間の言語をどのように利用するようになるか、私の見解をお伝えします。先日、IP中心の開発が爆発的に進むなかで実現した、10年前の予測トップ10について書きました。また、「2020~25年の数年間は機械が主役となる。消費者も企業もロボットの世界で暮らすことになる――『ターミネーター』シリーズを不気味なほど思わせるシナリオだ」とも書きました。私たちにとって、これはどのような状況になっているでしょうか。
科学的な予測が最も容易なのは、イノベーションがすでに起きていて、あとは応用するだけという場合です。テレビの小型化やムーアの法則に見られるように、機能する技術を応用することにかけて、私たちは非常に優れています。対照的に、1956年のダートマス会議で「人工知能(AI)」という用語が生まれた際には、多くの人が知的な機械の台頭を予測しました。言語間の自動翻訳、汎用ロボット工学、機械との会話といった予測の大半はいまだ実現していません。当初は技術が未成熟だったことに加え、制約に対応するよう解決策が設計されていたためです。ただし、一部では、今日の技術を活用するためのさらなるイノベーションを伴わず、当初の解決策が今も追求され続けています。
オーストラリアの企業Thinking Solutionsは、機械学習における統計分析という今日主流の手法に頼らなくても、言語理解は可能だと見いだしました。それだけではありません。機械の次世代に必要とされるこの重要分野では、人間に近い精度が実現可能であることも実証されています。
概要
人間との会話は、人工知能のあらゆる問題を先に解決しなければ実現できない「AI困難問題」と考えられています。脳内のあらゆる活動を詳細に理解することがまず必要だと主張する人もいます。しかし、AIが創設されて以来見られるように、多くの問題は全体的な解決を待たずに解決できるようです。会話の問題は分解できるため、パズルの各要素とその解決策を見ていきます。
言語を扱うには、機械は少なくとも(a)テキストを理解し、理想的にはさらに、(b)話し言葉を理解し、(c)話し言葉で応答を生成する必要があります。現在の技術のなかには、テキストだけを起点に、ルールに基づいていくつかのテキスト断片を取り出し、アプリケーションに処理を渡すものがあります。車に自宅へ電話するよう頼むのはその一例です。しかし、言語における次の人間的な段階は、(d)何が話されているかを理解することです。母語話者は文の意味のあらゆるニュアンスを拾い上げ、必要であれば言葉の選び方を訂正します。これは今日の言語システムとは異なります。
次に、理解した内容を現在の状況と照らし合わせ、(e)文脈を使って何が話されたのかを明確にしようとします。文脈を追いながらやり取りすることを、私たちは(f)会話と呼びます。最後に、何が話されたかを理解したうえで、(g)行動を起こします。行動とは、記録して何もしないこと、物理的に動くこと、あるいは口頭で何と返答するかを決めることです。たとえば、確認の質問や情報を伝える返答が考えられます。
テキスト認識
テキスト認識は、キーボードを使ってコンピューターに入力された文字から始まります。分析のなかには、この認識レベルで止まるものもあります。
たとえばIBM Watsonは、認識したテキストを高度なアルゴリズムと専用ハードウェアで処理し、非構造化文書から知識を取得して構築された膨大な知識ベースから、該当する既知の情報のうち最適なものを特定できます。これは人間のような認知ではなく、文書から得られる「ビッグデータ」と考えてください。このシステムは言葉を理解していないからです。
音声認識
音声認識はSFで人気を集めてきましたが、実際には人間並みの精度にはほど遠い状態です。さらに悪いことに、ハリウッドでは、私たちの未来が音声コマンドに限定されるかのように考え始めています。SF作品に登場するシステムも、「音楽オン」や「水を出して」のように不自然な形で動作しています。「シャワーを出して、私が浴室に着くころには程よく温まっているようにして」といった、思いついたままの言い方のほうが簡単ではないでしょうか。
Nuanceはディクテーションソフトウェアの市場をリードしています。その普及は、精度によって制限される可能性があります。市場をリードするディクテーションシステムが聞き取った内容を正確に文字起こしすると、命を懸けてまで信じられないのであれば、この技術はまだ実用化の準備が整っていません。言語理解の欠如がディクテーションの進歩を妨げているという見方には、1960年代後半以来、多くの人が同意しています。
音声合成
科学の進歩のなさを最も強く感じさせるものの一つは、質の悪い音声合成を聞くことです。歴史的に問題の一因となってきたのは、システムに言語表現が欠けていることです。しかし、どの語や句を強調するか、音節をどの程度の速さで発音するかを把握することも、どの言語でも適切なアクセントで自然に話すために必要です。
言語理解
今日の業界では、言語理解は未解決の問題であり、既存の解決策では不十分です。精度を高めるには単にルールを増やせばよいと説明されますが、問題の核心はスケーラビリティにあります。必要なルールの数は増え続け、やがてプログラマーが扱える限界を超える可能性があります。
対照的に、機械学習技術による自動化では、文書を自動分析して統計を蓄積しますが、言葉の意味は与えられません。現在の手法であるディープラーニングは、有用な特徴をさらに自動的に抽出する方法と見なされています。Googleは現在、創始者の一人であるジェフリー・ヒントン博士とともに、ディープラーニングの応用に投資しています。
今日では処理能力の向上によってこの技術が実現可能になっていますが、概念自体は1980年代に開発されたものです。処理にかかる労力を抑えて同じ結果を得る、よりよい方法はないでしょうか。あらゆる活動を一つひとつ完全に理解するエンジニアリングと、機械が特徴を集め、人間の関与なしにそれを独立して適用する方法では、どちらが優れているでしょうか。私は後者よりも、すべての部分があらかじめ定めた方法で一貫して機能するよう設計された解決策を個人的に好みます。
文脈追跡
会話に不可欠な文脈追跡は、科学研究が大きく進展している一方で、業界の大手企業からは軽視されている分野です。Thinking Solutionsの科学諮問委員会メンバーであるロバート・ヴァン・ヴァリン教授は、言語を三つの次元――語の配列(文法)、語の意味(意味論)、会話(語用論的談話)――でモデル化しています。ロール・アンド・リファレンス文法の主要な開発者であるヴァン・ヴァリンのモデルは、リンク付けアルゴリズムによって会話中の文脈追跡を可能にします。
現在、実用段階にあるプロトタイプでは、リンク付けアルゴリズムが言語をその意味に変換し、会話における正しい指示対象を正確に曖昧性解消します。
会話
会話は、機械とのやり取りに欠けていた要素です。話された内容を理解するだけでなく、その時点でほかに何が起きているかにも対応しなければならないからです。今日の最先端システムでは、コマンドに対して予測可能な応答を返すコマンドベースの解決策が使われています。会話のように相互にやり取りするものではありません。Facebookが最近買収したWit.aiは、このようなコマンドベースのアプリケーションを実装しています。Wit.aiの共同創業者、アレックス・ルブラン氏の次の発言は、コマンドと会話の隔たりを埋めるために必要な道のりをまとめるとともに、一貫した解決策が存在しないことを示唆しています。
「Wit.aiは……問題の表面をかすったにすぎません。単純なコマンドから始めて、もっと複雑な発言を理解し、文脈を認識し、強い曖昧さに対処し、自然で流れるようなやり取りを生み出すよう、機械に教える必要があります。単独の企業が一つの巨大で一枚岩の解決策を提供する日が来るとは思いません。むしろ、いくつかのスタートアップが問題の明確に定義された部分を解決するでしょう。自然言語アプリケーションは、こうした相互に連結する要素で構成されることになります。」
行動を起こす
会話のこの段階で行動を起こすことは難しくありません。何が話されているかを理解すれば、取るべき行動が決まります。それを担うのはプログラマーの役割であり、ほとんどの作業では一般的なスキルです。
パーソナルアシスタントなどの幅広い携帯電話アプリは、ほぼ同じように動作し、似た機能を備えています。今日のところ、どれも会話能力を欠いていますが、行動が決まれば、いずれも一貫して正確な応答を返します。理解できない場合は、人間の基準でいえばどれも同じようにうまく機能しません。
考察
今日のブログでは、機械が理解するという現在のニーズを支える言語システムに求められる要件を取り上げます。このテーマへの関心は高まっています。コンピューター設計における先駆的な業績、第二次世界大戦中の暗号解読、そしてAIの前身となる研究で知られるアラン・チューリング博士は、知能を測るテストを考案しました。相手に知能があるかどうかを試すために、会話が使われました。今日では、Winograd Schema Challengeのように、質問への回答のほうが優れたテストだと考える人もいます。このアプローチは現在、Nuance Communicationsが提供するコンテストになっていますが、もちろんチューリングテストでもそうした質問をすることはできます。
最近Wit.aiを買収し、AIの専門家を複数雇用しているFacebookは、より簡単なテストを提案しました。ここでは、いくつかの文を入力します。母語話者ならその文についての質問に必ず正しく答えられますが、機械にもそれができるかどうかを試します。これは、私が説明してきた言語理解の好例です。
結論
計算負荷の高い統計的手法から脱却するための抜本的なイノベーションは、AI全般、とりわけ言語・音声製品の分野で不足してきました。意味に基づくシステムへ移行すれば、機械との会話型インターフェースがついに実現するだけでなく、コンピューティングの進化における次の段階を始めるための基盤ももたらされると期待されます。
人間が目指すべき解決策を得ているとき、私たちの普及とイノベーションの速度は一貫して力強いものです。2020年の予測は、2015年の予測の結果と同じくらい確かなものに見えてきました。
この開発の最前線にいる私たちは、『ターミネーター』シリーズの2020年の予測が現実になることを心配すべきでしょうか。幸い、言語システムはパズルの一要素にすぎません。ロボットの世界での体験を向上させる重要な要素ではありますが、それでも一要素にとどまります。
本記事は LinkedInとの協力により公開されています。記事の公開は、世界経済フォーラムがその見解を支持することを意味するものではありません。
アジェンダの最新情報を得るには、週刊ニュースレターをご購読ください。
著者:Cyberflow Analyticsの会長兼CEO、ホセイン・エスランボルチ博士。
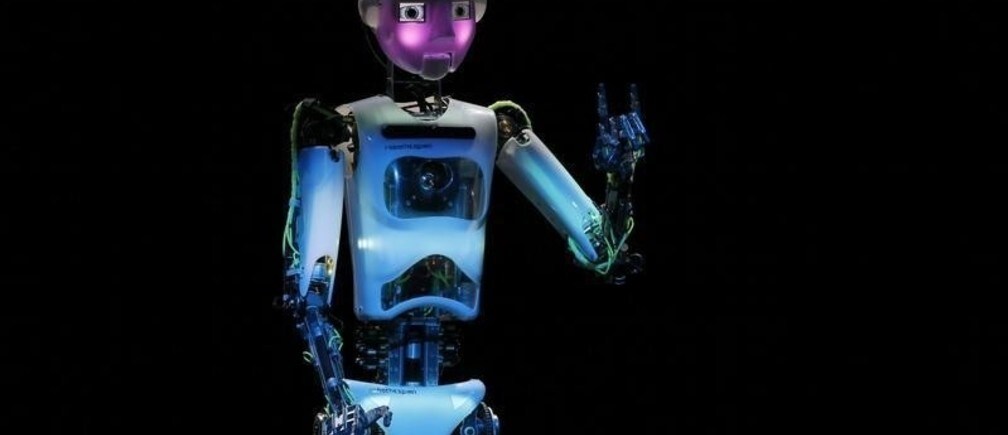
画像:英国企業RoboThespianのヒューマノイドロボットが「赤面」する様子。英国が今年のパートナー国となったハノーバー技術見本市CeBITの開会式で、2014年3月9日に撮影。ロイター/ヴォルフガング・ラッタイ


