学ぶことを学ぶ
1959年、機械学習(ML)分野の先駆者であるアーサー・サミュエルは、機械学習を次のように定義しました。「コンピューターが明示的にプログラムされなくても学習できるようにする研究分野」。
機械学習(ML)は、経験を活用して性能を向上させたり、正確な予測を行ったりする計算手法と捉えることができます。ここでいう経験とは、利用可能な過去の情報やデータを指し、それらにはラベルが付けられ、分類されています。あらゆる計算処理と同様に、データの質と量は、予測の精度を左右する重要な要素です。
この見方をすれば、MLは統計モデリングによく似ているように思えます。統計モデリングでは、データを収集し、データが整っているか、つまり不完全、不正確、または無関係な部分を補完、修正、削除したかを確認したうえで、この整備済みのデータセットを使って仮説を検証し、予測や見通しを立てます。統計モデリングの考え方は、複雑な問題を、比較的一般化可能な表現、すなわち調査対象となる事象の大半を説明できる表現で示そうとするものです。実際には、入力したデータに基づいて特定の機能を実行するよう、アルゴリズムをプログラムします。言い換えれば、アルゴリズムは固定的です。データを与えられたときに何をすべきか、プログラマーが指示する必要があります。ここまでは、プログラマーが起動する際にこの方法を使うのは確かに理にかなっています。
しかし、MLでは手順が逆になります。あらかじめモデルを選んでデータを入力するのではなく、目の前の課題を最もうまく実行する分析手法を、データに基づいて選びます。つまり、コンピューターは手元のデータを使ってアルゴリズムを選択し、訓練します。そのため、アルゴリズムはもはや固定的ではありません。与えられたデータを分析し、最善の対応策を判断して実行します。本質的には、データから「学習」し、その過程でデータから知識を引き出すことができます。
この学習方法は反復に基づいています。アルゴリズムとは、入力を特定の出力に変換するためにコンピューターが使う一連の指示にすぎないことを思い出してください。したがって、MLにおける学習とは、アルゴリズムが処理を何度も繰り返し、一定の条件が満たされるまで少しずつ調整していくことです。学習アルゴリズムの試金石は、以前に訓練されていない新しいデータを与えられたときに、予測できるかどうかです。
機械学習の進化
この方法論的なプロセスでは、データが中心的な役割を果たすのは明らかです。さらに重要なのは、データの構造によって学習プロセスの進み方が決まることです。ここで、MLの3つの段階を見ていきます。
教師あり機械学習
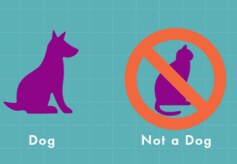
ここでは、適切にラベル付けされたデータを使ってコンピューターを訓練します。つまり、データには正しいラベルや正解がすでに付与されています。たとえば、猫と犬の画像を見分けるようコンピューターに教える場合、次のようにデータにラベルを付けます。
このラベル付けはプログラマーが行います。違いを学習すれば、MLアルゴリズムは新たに与えられた情報を分類し、新しい画像が犬か猫かを判定できるようになります。
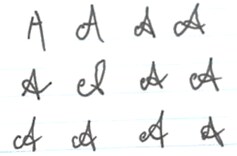
この単純な方法を基に、教師ありMLはさらに複雑な処理にも利用できます。その一例が、数字やアルファベットの読み取りです。ある人が数字の「1」や文字の「A」を書く形は、別の人の書き方とは異なります。
手書き数字「1」のパターン。著者提供のイラスト。手書き文字「A」のパターン。著者提供のイラスト。
数字の「1」や「A」のラベル付きの例を大量にコンピューターに与えることで、こうした文字のさまざまな形を認識するようアルゴリズムを訓練できます。こうしてコンピューターは形の違いを学び、パターンを理解する能力を高めていきます。
現在、コンピューターはこうした手書きのパターン認識において、人間を上回っています。データセットが大きいほど、アルゴリズムはよりよく訓練されます。訓練後、アルゴリズムに新しいデータを与えると、過去の経験を使って結果を予測します。
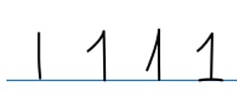
教師なし機械学習
ここでは、ラベルのないデータセットを使ってアルゴリズムを訓練します。データが何を表しているのか、アルゴリズムには伝えません。この場合、学習プロセスは、データ内で繰り返し生じるパターンを特定することに依存します。猫と犬の例でいえば、アルゴリズムは受け取った画像を、犬に固有の特徴に基づいて分け始めます。
教師なし学習では、アルゴリズムは推測統計に基づく推定手法を用い、生のラベルなしデータセットからパターン、関係性、相関を見つけなければなりません。パターンを特定すると、統計手法を使ってデータセット内の境界を見定めます。似たパターンを持つデータをまとめ、データのサブセットを作成します。分類が進むにつれて、アルゴリズムは分析対象のデータセットを理解し始め、今後のデータの分類を予測できるようになります。
こうしたデータのクラスタリングによって意思決定を自動化でき、教師なし学習にさらなる高度さを加えることができます。さらに重要なのは、データを新たな方法で活用できることです。知識の不足は、データで補うことができます。
強化学習
強化学習は、訓練データにラベルがない点で教師なしMLに似ています。しかし、データについて質問されたとき、結果には評価が付けられるため、一定の監督要素があります。アルゴリズムにはラベルのないデータが提示されますが、肯定的または否定的な結果を示す例が与えられます。この評価がアルゴリズムへのフィードバックの仕組みとなり、提示した解決策が問題を解決しているかどうかを判断できるようにします。実質的には、人間の試行錯誤による学習をコンピューターで再現したものです。
強化学習は、戦略を立てるためによく使われます。意思決定が結果につながるため、出力される行動は、教師なし学習のように単に状況を記述するものではなく、次に何をすべきかを示します。この種の学習は、コンピューターにゲームのプレイ方法を教えるためにも使われています。2014年にGoogleが買収した企業DeepMindは、この考え方に基づき、アルゴリズムにAtariのゲームの遊び方を学習させました。
その後、同社はAlphaGoを開発し、世界で最も複雑なゲームの一つである囲碁で、最高の人間のプロ囲碁棋士を4対1で破りました。
企業への影響
現在、機械学習はさまざまな分野で使われています。Googleの自動運転車は機械学習を使って開発され、現在ではコンピューターが人間より速く読唇できるようになっています。近年、MLは金融のほぼあらゆる分野に浸透しています。たとえば、アルゴリズム取引、時系列データの分析、ポートフォリオ管理、不正検知、顧客サービス、ニュース分析、投資戦略の策定などに使われています。
しかし、機械学習の真の力が発揮されるのはニューラルネットワークです。次回の記事では、このテーマについてもう少し詳しく説明します。




