Alexa、Siri、Googleなどの人気の音声アシスタントは、音声認識ソフトウェアを使って質問に答えますが、子どもの言葉は非常に複雑で予測がつきません。
子どもは単語を過度に強く発音し、特定の音節を引き伸ばし、考えながら一語ごとに区切って話したり、一部の単語を完全に飛ばしたりします。
子どもは1日に5時間以上を画面の前で過ごしており、子どもの言葉が理解されることは極めて重要です。
パンデミック以前は、新たにインターネットを利用し始めた人の40%以上が子どもでした。現在の推計では、次のように示唆されています。子どもの画面利用時間は急増しており、60%以上増加し、12歳以下の子どもは1日に5時間以上を画面の前で過ごしています(それに伴うあらゆる恩恵と危険)。
デジタルネイティブの技術的な能力には目を見張るものがありますが、教育者(そして保護者)は、若い「遠隔学習者」が、教育テクノロジーの約束を果たすために必要なキーボード、メニュー、インターフェースを操作するのに苦労することがよくあることを痛感しています。
こうした背景の中、音声対応のデジタルアシスタントは、テクノロジーとのより円滑なやり取りへの期待を集めています。しかし、子どもたちはAlexaまたはSiriに、ビートボックスをさせたり、ジョークを言わせたり、動物の鳴き声をまねさせたりするのが好きですが、保護者や教師は、これらのシステムが予測可能な要求から外れると、最も幼いユーザーの言葉を理解するのに苦労することを知っています。
Alexa、Siri、Googleなどの人気の音声アシスタントを動かす音声認識ソフトウェアは、子どもが使うことを想定して設計されたことは一度もなく、子どもの声、言語、行動は大人よりもはるかに複雑です。
子どもの声が高いというだけではありません。声道は細く短く、声帯は小さく、喉頭はまだ十分に発達していません。その結果、年長の子どもや大人とは非常に異なる話し方のパターンが生じます。
下の図からわかるように、音声認識の学習に用いる大人の声の音程を単に変えるだけでは、子どもの話し言葉を理解するために必要な情報の複雑さを再現できません。子どもの言語構造やパターンは大きく異なります。子どもは統語、発音、文法において飛躍的な発達を遂げるため、音声認識システムの自然言語処理の要素でそれを考慮する必要があります。さらに、この複雑さは、大人の音声では考慮する必要のない、さまざまな発達段階にある子ども同士の話者間のばらつきによって一層増大します。
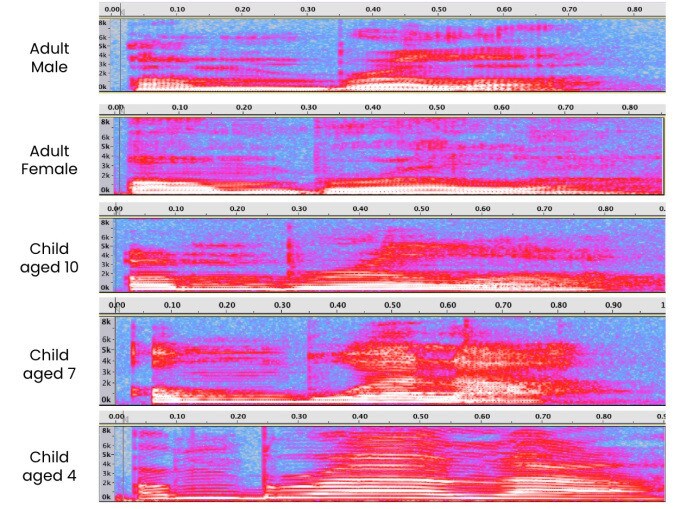
子どもの話し方は、大人よりも変動が大きいだけでなく、非常に不規則です。子どもは単語を過度に強く発音し、特定の音節を引き伸ばし、考えながら一語ごとに区切って話したり、一部の単語を完全に飛ばしたりします。子どもの話し方のパターンは、大人向けに作られたシステムに馴染みのある一般的な抑揚には従いません。大人は、これらの機器との最適なやり取りの仕方や、最良の応答を引き出す方法を学んできました。姿勢を正し、頭の中で要求を組み立て、学習した行動に基づいて修正し、深呼吸をしてから声に出して要求を伝えます……「アレクサ……」。子どもは、考えの整理されていない要求をそのまま口にします。まるでSiriやAlexaが人間であるかのように。そしてその多くは、誤った応答や定型的な応答しか得られません。
教育の場では、これらの課題はさらに深刻になります。音声認識は、周囲の騒音や教室の予測不可能性だけでなく、一年を通じた子どもの話し方の変化や、一般的な小学校における多様なアクセントや方言にも対処しなければならないからです。子どもと大人の身体的、言語的、行動的な違いは、年齢が低いほど大幅に大きくなります。つまり、音声認識から最も恩恵を受けるはずの幼い学習者こそが、開発者にとって最も対応が難しいということです。
子どもの言語特有の多様な癖を考慮し、理解するには、子どもの話し方から意図的に学習するように構築された音声認識システムが必要です。子どもの話し方は、音声認識が対応すべき単なる別のアクセントや方言として扱うことはできません。それは根本的かつ実質的に異なるものであり、子どもが身体的に成長し、言語能力を発達させるにつれて変化します。
多くの一般消費者向けの場面とは異なり、子どもにとって正確性は重大な意味を持ちます。子どもが正しいのに間違っていると伝えるシステム(偽陰性)は、子どもの自信を損ない、子どもが間違っているのに正しいと伝えるシステム(偽陽性)は、社会情緒的(および心理測定的)な害を及ぼすおそれがあります。アプリ、ゲーム、ロボット工学、スマートトイなどのエンターテインメントの場では、こうした偽陰性または偽陽性は、フラストレーションの溜まる体験につながります。学校では、誤りや誤解、定型的な応答が、教育的な面と公平性の面の双方においてはるかに深刻な影響をもたらしかねません。
十分に記録されている偏りは、音声認識において、例えば子どもに対して有害な影響を及ぼす可能性があります。特定の人口統計学的または社会経済的背景を持つ子どもに対して、製品の精度が低く、偽陽性と偽陰性を生じさせるのは容認できません。「増えつつある研究の蓄積」は、音声が子どもにとって極めて価値のあるインターフェースになり得ることを示唆していますが、音声がわたしたちの学校に既に存在する根深い偏りや不平等を増幅させる可能性を、看過したり無視したりすることはできません。
音声認識は、家庭でも教室でも、子どもにとって強力なツールになる可能性を秘めています。読み書きや言語学習の段階で子どもを支援する上で重要な空白を埋め、子どもが周囲の世界をよりよく理解し、また周囲の世界から理解されるよう助けることができます。さらに、遠隔環境でも確実に機能する「目に見えない」観察的測定という新時代への道を開くこともできます。しかし、今日の音声認識ツールの大半は、この目標には不向きです。SiriやAlexaなどの音声アシスタントに搭載されている技術には、明瞭かつ予測可能に話す大人を理解するという役割があり、ほとんどの場合、その役割を十分に果たしています。音声認識を子どもにも機能させるためには、子ども特有の声、言語、行動を前提に設計し、それに応答する必要があります。




