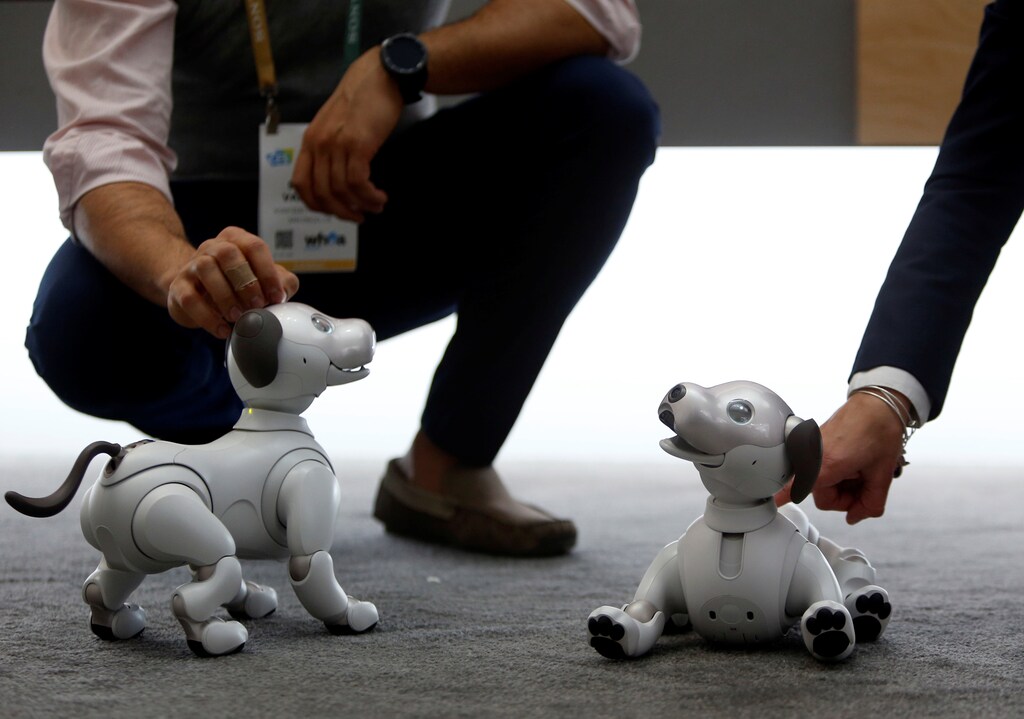
研究者チームが、通常は犬のトレーニング向けの手法を用いて、ロボットに新しいスキルを教えている。
ポジティブ強化を用いることで、研究チームはロボットに数日で新しいことを学習させることができた。通常は1か月かかる学習である。
チームは、これらの知見が家庭用ロボットや自動運転車の訓練にも役立つと考えている。
犬に「お座り」や「待て」を教える際によく用いられるトレーニング手法を使い、研究者はロボットに、ブロックの積み重ねを含むいくつかの新しい芸を自ら学習させる方法を示した。
この手法により、「スポット」と名付けられたロボットは、通常1か月かかる学習を数日で習得できた。
犬の行動を変えるためにおやつを使ったことがある人なら誰にでもなじみのあるアプローチであるポジティブ強化を用いることで、チームはロボットのスキルを飛躍的に向上させ、その速度も十分に速かったため、実社会での作業に向けたロボットの訓練を、より実現可能な取り組みにすることができた。
「犬を飼ってきたので、ごほうびが効果的だと分かっています。それが、学習アルゴリズムを設計する際のインスピレーションになりました。」
「ここでの問いは、どうすればロボットにスキルを学習させられるか、というものでした」と、筆頭著者でジョンズ・ホプキンス大学の計算インタラクション・ロボティクス研究所に所属する博士課程の学生、アンドリュー・ハント氏は述べる。「犬を飼ってきたので、ごほうびが効果的だと分かっています。それが、学習アルゴリズムを設計する際のインスピレーションになりました。」
この研究は次の論文に掲載されている:IEEE Robotics and Automation Letters。
ロボットに学習させる
生まれながらに高度に直感的な脳を備えている人間や動物と異なり、コンピューターは白紙の状態であり、すべてをゼロから学習しなければならない。しかし真の学習は多くの場合、試行錯誤によって成し遂げられるため、ロボット工学者たちは、ロボットが失敗から効率的に学ぶ方法をまだ模索している。
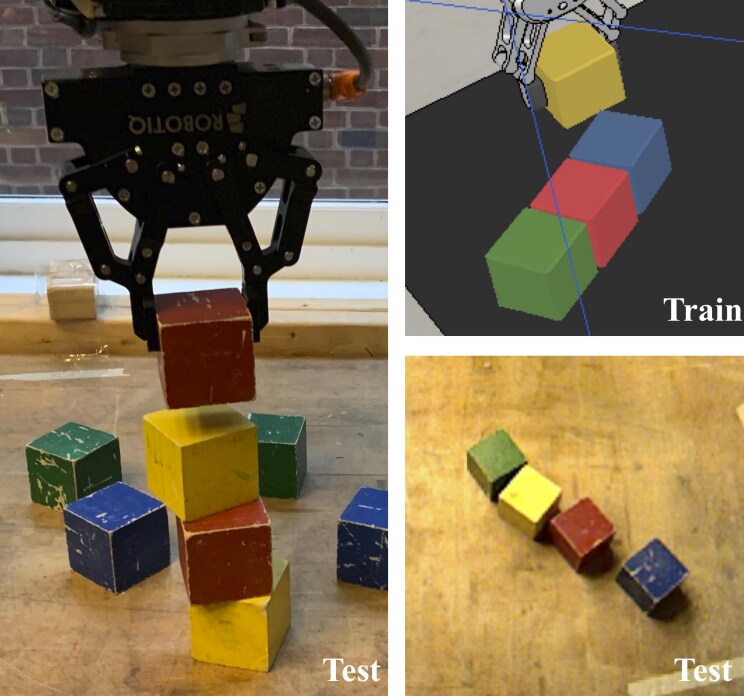
チームは、ロボットにとってのごほうびが犬にとってのおやつと同じように機能する報酬システムを考案することで、これを実現した。犬であれば、うまくできたときにクッキーをもらえるところを、ロボットは数値のポイントを獲得した。
ハント氏は、テリア系の雑種の子犬「リア」に、散歩中にリスを無視できるよう「やめて」という指示を教えた時のことを振り返った。使ったのは、通常のトレーニング用おやつと、チーズのようなさらに良いごほうびの2種類である。
リアが興奮しておやつのにおいをかぎ回っているときは、何ももらえなかった。しかし落ち着いてよそを向いたときには、良いものをもらえた。「そのときにチーズを与えて、『やめて! いい子だね、リア!』と言ったのです。」
同様に、ブロックを積み重ねるために、ロボットのスポットは建設的な動作に集中することを学ぶ必要があった。ロボットがブロックを探索する中で、積み重ねに正しい動作をすると高得点を得られ、誤った動作では何も得られないことをすぐに学習した。ブロックをつかまずに手を伸ばした場合は? ポイントなし。積み重ねを倒した場合は? 間違いなくポイントなし。スポットは、4段の積み重ねの最上部に最後のブロックを置いたときに最も多くのポイントを獲得した。
ハイスコア!
このトレーニング手法は効果があっただけでなく、かつては数週間かかっていたロボットへの指導が、わずか数日で済むようになった。チームはまず、テレビゲームに近い仕組みのシミュレーションロボットを訓練し、その後スポットでテストを行うことで、練習時間を短縮することができた。
「ロボットはより高いスコアを求めます」とハント氏は言う。「最良の報酬を得るための正しい動作を、すぐに学習するのです。実際、以前はロボットが100%の精度を達成するのに1か月の練習が必要でした。それを2日で実現できたのです。」
ポジティブ強化は、ロボットが自らブロックを積み重ねることを学習するのに役立つだけでなく、ポイント制によって、ロボットは同じくらい素早く他のいくつかの課題も学習した。シミュレーションのナビゲーションゲームのプレイ方法まで含まれる。あらゆる種類の状況で失敗から学べる能力は、新しい環境に適応できるロボットを設計する上で極めて重要である。
「最初、ロボットは自分が何をしているのか分かっていませんが、練習を重ねるごとにどんどん上達していきます。決して諦めず、積み重ねを試み続け、100%の確率で課題を完了できるのです」とハント氏は言う。
チームは、これらの知見が次のようなロボットの訓練にも役立つと考えている。家庭用ロボットによる洗濯や皿洗いなど、一般市場で人気が出る可能性があり、高齢者の自立生活を支援できる作業である。また、改良型の自動運転車の設計にも役立つ可能性がある。
「私たちの目標は、最終的に複雑な課題を現実世界でこなせるロボットを開発することです。製品の組み立て、高齢者のケア、手術などです」と、共著者でコンピューターサイエンスの教授であるグレゴリー・D・ハーガー氏は述べる。
「現時点では、そのような課題をどうプログラムすればよいかは分かっていません。世界は複雑すぎるのです。しかし、この種の研究は、ロボットが安全かつ効率的な方法で現実世界の課題を達成することを学習できるという考えに、希望があることを示しています」とハガー氏は言う。
出典:ジョンズ・ホプキンス大学




