AmazonのAlexa、GoogleのHome、AppleのHomePodなどの音声操作ガジェットの人気が高まっていますが、人々は次の分野の進歩について立ち止まって考えるべきです:機械学習。これにより、音声に含まれるさまざまな感情を理解するアプリケーションが生まれる可能性があります。
Googleの最高経営責任者(CEO)であるGoogleのサンダー・ピチャイ氏は、同社の検索の20%が音声による検索であり、モバイル端末経由で行われていると最近述べました。また、2017年末の米国市場の分析では、合計で4,400万台のAmazon AlexaおよびGoogle Homeデバイスが販売されたと推定されています。
この技術は、単語を認識する能力を着実に向上させていますが、音響学の専門家である私の見解では、言語によるコミュニケーションははるかに複雑です。何をどう言うかは、言葉そのものと同じくらい重要な場合があります。誰かが「大丈夫です」と言ったとき、声の調子から、その人の気分が本人の主張とは正反対であることが分かる場合があります。
スマートスピーカーやバーチャルアシスタントとも呼ばれる音声操作ガジェットは、言葉だけに注目し、話し方にはほとんど注意を払わないため、使いにくいことがあります。テクノロジー大手各社は、「Amazon Echo」などのデバイスの次の進化として、Amazon Echoが人の感情を検出することを期待しています。声から感情を読み取ることで、やり取りをより自然なものにする狙いです。

人の声からは、その人が誰であるか、どこの出身か、どのような気持ちでいるかといった情報が読み取れることがあります。見知らぬ人が話すと、人々はすぐにそのアクセントやイントネーションに気づき、その人の階級、経歴、学歴について推測を行います。
音声操作ガジェットがこうした情報を捉えられるようになれば、音声インターフェースは改善されるかもしれません。ただし、意図しない結果については注意が必要です。この技術は機械学習に依拠しています。機械学習は、大量のデータを与えられた機械が学習したアルゴリズムと統計を組み合わせる人工知能の一分野であり、そのため、その振る舞いは完全には予測できません。
未来は賢いのか、それとも愚かなのか。
研究は示しています、機械学習アプリケーションの訓練に用いられる音声の例がバイアスにつながる可能性が高いことを。この技術に関するこうした問題は、Google翻訳などの一般的なツールにおいても明らかになっています。
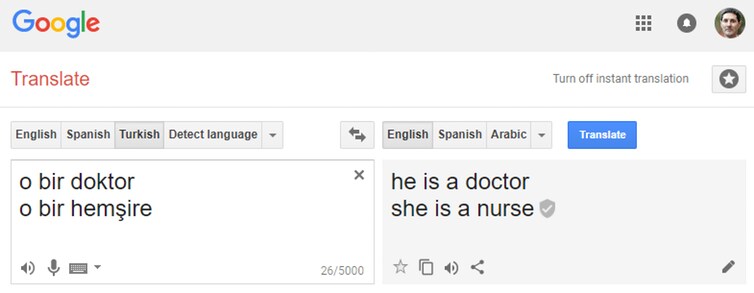
例えば、トルコ語の「o bir doktor」と「o bir hemşire」を英語に翻訳すると、Googleのサービスは「he is a doctor」および「she is a nurse」という結果を返します。しかし、トルコ語の「o」は性別に中立な三人称代名詞です。医師は男性、看護師は女性であるという前提は、文化的な偏見と医療職における性別の偏った分布を反映しています。
Google翻訳は、アルゴリズムの訓練に使われたデータに含まれていた人間の文化的偏見を取り込んでおり、その結果、性差別的な翻訳システムになっています。
機械学習は人間のステレオタイプを反映するため、こうした問題の解決は容易ではありません。人は声を聞くと、経験則を用いて、相手にどう応答すべきかを判断する作業を簡略化します。
研究によると、多くの文の末尾で語調を上げる女性の声を人々が聞いた場合、アップトークとして知られる話し方について、一般的には若いと想定されます。男性が低い声で話すと、体格が大きく強い人だと想定されます。音声に関するこうした単純化された想定は、偏見に基づく判断につながる可能性があります。
バーミンガム訛りの刑事被疑者は、ある研究によると、より中立的な訛りの人と比べて有罪と判断される可能性が高いことが分かりました。また、研究では、明らかにされていることに加え、母語話者ではない訛りの人は、より不誠実だと受け取られやすいことも分かっています。
話し声から、人が怒っているか、喜んでいるか、悲しんでいるかを判断することは、音声操作デバイスを使う人にとって非常に役立つ可能性があります。しかし、人が発する声の手がかりは、人によって、また言語や文化によって異なります。恋愛経験のある人なら誰もが認めるように、人間は必ずしも感情を正しく認識できるわけではありません。では、なぜ機械はより良い判断ができると期待されるのでしょうか。
人々の聴覚による「ゲイダー」の研究は――相手が同性愛者、レズビアン、バイセクシュアルであるかを直感的に見分けられると主張する一部の人々が使う俗語――は、曖昧で、さらには根拠のない手がかりの良い例です。例えば、聞き手は、ゲイの男性はより高い声で話すといった、その話し方について想定を立てますが、その想定はしばしば誤りです。観客の期待に応えるように、誤ったステレオタイプを誇張して演じる俳優がテレビ画面で一種の文化的な定型となりました。研究で示されている。
音声信号に固有で自然に含まれる曖昧さは、テクノロジー企業が自らの失敗から学ぶのでない限り、誤りにつながる可能性が高いです。この技術は取り込まれたデータからの学習に大きく依存しているため、人間の声を解釈しようとするアプリケーションには、根深い偏見が学習されてしまう可能性があります。
音声操作デバイスやサービスを開発する技術企業は、すでに音響学の専門家と話し合っているかもしれません。しかし、避けるべき落とし穴をより深く理解するためには、機械学習を人間の声の解読に適用する前に、警告に真剣に耳を傾ける必要があります。




