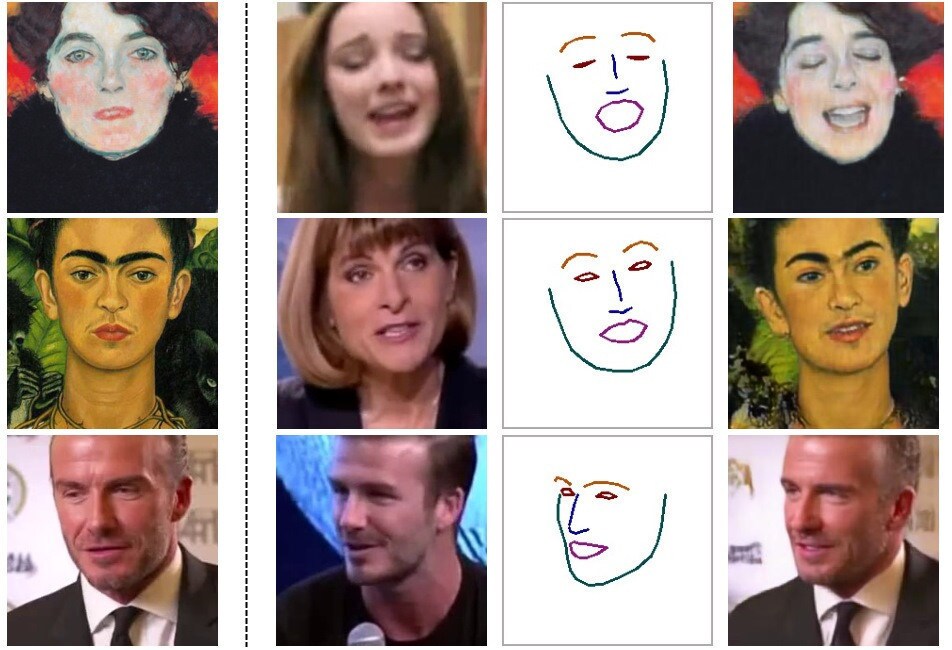
機械学習の研究者らは、人の顔の一枚の画像だけから生き生きとした動きを再現できるシステムを開発し、写真だけでなく絵画もアニメーション化できる可能性が開けた。完璧ではないが、うまく機能した場合、それは——近年の多くのAI研究と同様に——不気味で魅力的だ。
このモデルは、Samsung AI Centerが発表した論文で解説されており、こちらのArxivで読むことができる。これは、ソースの顔に顔のランドマークを適用し(どのような話す頭部でもよい)、それをターゲットの顔のデータに当てはめて、ターゲットの顔がソースの顔と同じ動きをするようにする新しい手法である。
これ自体は新しいものではなく、現在AI分野が直面している合成画像の問題全体の一部である(この件については、最近バークレーで開催した当社のRobotics + AIイベントで興味深い議論を行った)。ある動画の顔が、人物が話している内容や視線の方向という点で、別の動画の顔を反映させることは既に可能である。しかし、これらのモデルの多くは、分析のために例えば1~2分の動画など、かなりの量のデータを必要とする。
しかし、Samsungのモスクワ拠点の研究者らによる新しい論文は、人の顔の画像一枚だけを使って、その顔が振り向き、話し、通常の表情を見せる動画を生成できることを示している。忠実度は説得力があるが、完璧からはほど遠い。
この手法は、顔のランドマーク特定プロセスに膨大な量のデータを事前に読み込ませることで、ターゲットの顔のうちソースに対応する部分を見つけ出すモデルの効率を高めている。データが多いほど良いが、単一の画像でも可能であり、これは「単一ショット学習」と呼ばれ、それでも機能する。このおかげで、アインシュタインやマリリン・モンロー、さらにはモナ・リザの写真を撮り、それを本物の人間のように動かして話させることが可能になる。
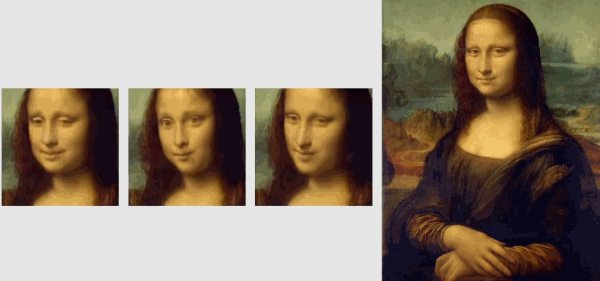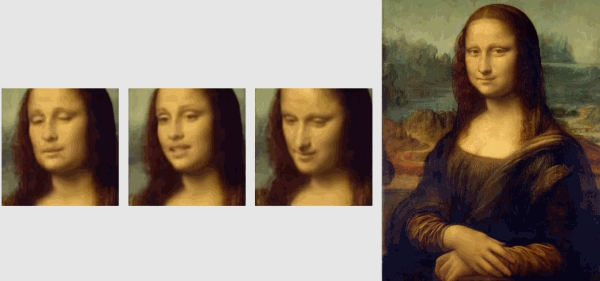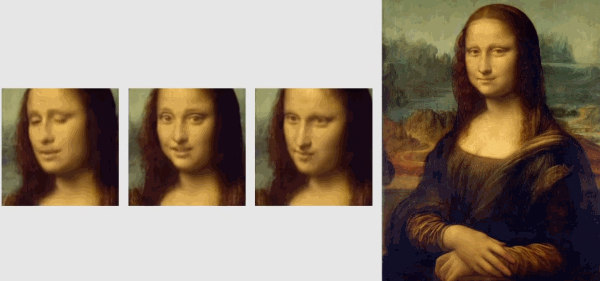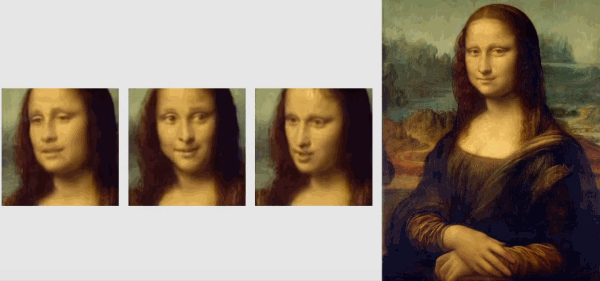
また、「敵対的生成ネットワーク(GAN)」と呼ばれる手法も用いられている。これは基本的に、2つのモデルを互いに競わせるもので、一方は作成したものが「本物」だと相手に信じ込ませようとする。こうした仕組みにより、結果は作成者が設定した一定水準のリアリズムを満たすことになる。「識別器」モデルは、処理を継続するために、これが人間の顔であることを例えば90%の確信度で判定しなければならない。
研究者らが提供した他の例では、偽の話す頭部の品質や不自然さは大きく異なる。ケーブルニュースから撮影された人物を再現しようとしたものの中には、画像下部に表示されるニュース速報テロップも再現され、そこが意味不明な文字列で埋められているものもある。また、何に注意すべきかが分かっていれば、いつもの滲みや奇妙なアーティファクトがどこにでも見られる。
とはいえ、ここまでうまく機能することは注目に値する。ただし、これは顔と上半身にのみ有効であり、モナ・リザに指を鳴らさせたり踊らせたりすることはできない点に注意が必要である。少なくとも今のところは。




