知る必要があるのに知らないことは何でしょうか。また、自分が知らないとどうすればわかるのでしょうか。それを検索エンジンに入力して、一貫した答えが返ってくると期待する場面を想像してみてください。私たちが求める答えは、発見と学習の核心にあります。複雑で急速に変化する世界において、必要性や喜び、仕事の喪失、あるいはリーダーシップをめぐる不確実性が、その動機となります。人間であれ機械であれ、学習を助ける役割を担うには、自分自身と世界について詳しく知る必要があります。
ウェブ検索、専門家や同じ関心を持つ人々との議論、読書、教育課程への取り組み、動画チュートリアルを使ったオンライン学習、オンラインのニュースチャンネルやアグリゲーターを流れる膨大なコンテンツの吸収を通じて、スキルや知識の不足を補えます。こうした学びの一部は体系的ですが、多くは暗闇の中を手探りで進むように、偶然の発見を受け入れることでもあります。
機械学習が、いま支援に乗り出しています。人々が学べるよう、何を知っていて何を知らないかを取り込み、モデル化し、より的を絞った情報を提供します。Google、LinkedIn、Amazonなどのプラットフォーム企業が目指しているのは、私たちと私たちのニーズをデータで表すアルゴリズムの構築です。生涯学習は、私たちについて十分な情報を把握し、推奨を行い、変化する状況に適応するプラットフォーム主導のマッチング技術によって支えられるようになるでしょう。ここに、人間の学習と機械学習の接点があります。
プラットフォームによるマッチング
この機会の中心にあるのは大量のデータと、それをマッチング用の比較行列に変換する方法を知るアルゴリズムです。Amazonは長年、この手法で商品を推薦してきました。「この商品を購入したお客様は、こちらの商品も購入しています……」。Tinderでは、マッチングアルゴリズムがあるプロフィールのデータをほかのプロフィールと比較し、候補の一覧を提示します。Facebookでは、広告のターゲティングにマッチングが使われています。実質的に、あなたのデータは特定の目的に沿ったあなた自身の表現になりつつあります。アルゴリズムが順位付きの選択肢を提示するには、あなたとあなたの希望について十分に知る必要があります。この手法は単純で広く普及しており、驚くほど強力です。しかし、こうしたアルゴリズムの用途は次に読む本を選ぶことをはるかに超えており、その可能性は開かれたばかりです。
LinkedInのエコノミック・グラフは、「世界経済をデジタルでマッピングし、大規模に人材と機会を結びつける」ものです。これにより、仕事の性質の変化、特定の職務を構成するスキルの種類、転職の前兆となる仕事関連の行動について、深い洞察が得られます。また、キャリアを前進させる前に埋める必要のあるスキルギャップも認識できます。人々のスキルギャップを把握し、それを埋める支援をすることを考えれば、コンテンツ集約アプリ「Pulse」を2013年に、オンライン学習サイト「Lynda.com」を2015年に買収し、LinkedIn Learningを2016年9月に立ち上げたことは、理にかなっています。
今後数十年の皮肉の一つは、機械学習が契約法務や秘書業務などの知識労働をますます奪う一方で、新たに生じた知識の不足を埋めて次の仕事に就けるよう、学習機会を見つけて推奨することです。
個人の学習から組織の学習へ
今後数年で、こうした革新を支えるのと同じ技術が、あらゆる種類の企業に広く普及するでしょう。データ駆動型の企業や文化は以前から語られてきましたが、実際に目指すべきは知識駆動型になることです。部門やチームは縦割りで、知識は各人の頭の中に閉じ込められています。社内プロセスは最適化されず、職員研修はほとんど存在しないこともあります。取締役会は社内の動きをほとんど把握できず、CEOも会社の収益を脅かす破壊的な脅威が迫っていることを学んでいないかもしれません。
組織内の不満、透明性の崩壊、人材活用の非効率は、音楽を選ぶときに使われるものと同種の推薦アルゴリズムから恩恵を受けられます。「この問題を解決した同僚は、こちらにも相談しました……」「このノウハウを持たなかったCEOは、これも欠いていました……」「このサービスを必要とした企業は、こちらも必要としていました……」。少し冗談めかして言えば、これがどこへ向かうかはおわかりでしょう。
機械学習と人工知能への関心がいま急速に高まっていますが、私たちが個人の学習の道筋を理解できるまでの距離は、コペルニクス以前に地球が太陽の周りを回っていると理解できなかった時代と同じくらい遠いままです。機械学習に支えられた知識基盤の革命がビジネス界を襲い、企業の組織構造や相互連携のあり方にパラダイムシフトをもたらすでしょう。企業は、学習し、最適化し、進化するために、新たな、広く利用可能になったテクノロジー主導の手法を活用するようになります。
行列に潜む偏り
機械学習に基づく推薦がウェブプラットフォームや電子商取引サイトの収益を押し上げていますが、その洗練度はまだ十分ではありません。情報の行列を大まかな統計手法で比較し、選択肢を提示しているにすぎない場合がほとんどであるにもかかわらず、驚くほどうまく機能しています。これは格子であって、判断ではありません。
こうした機械学習システムの最も弱い部分は、しばしば開発者とその企業にあり、アルゴリズムの不適切なモデル化や近道を選ぶ思考が偏りを持ち込みます。Amazonで靴を一足買うと、まったく同じ靴の広告が何週間も表示されることがあります。アルゴリズムは、すでに購入したことを把握していないようです。親や友人のために本を買った場合などに起こる個人データの汚染も問題です。すると突然、アルゴリズムはそれをあなたの好みだと考えます。また、人気によるフィルターバブルが生じると、一覧の上位を人々がクリックする自己強化のループを通じて、記事が読書リストの上位にとどまり続けることがあります。広告費によって、ある項目が別の項目より優先されます。現在私たちは、選挙期間中の人々の認識を損なう「フェイクニュース」の問題を目の当たりにしています。ソーシャルメディア上での情報の拡散速度は、推薦アルゴリズムの中で簡単に歪んだシグナルとなり、多くの人には事実と虚偽を見分けるための確認手段がほとんどありません。
これは、関連性エンジニアリングの機会を示しています。私たちの学習アルゴリズムは、まだ十分に進化していません。今も主に類似性の原則で動いています。つまり、これに似ているから、もっと同じものを提示するという仕組みです。個人の学習体験に意味のある情報を与えるには、スキル間の依存関係や知識領域間の相補的な関係をモデル化する必要があります。
コンテンツがデータになる
2015年、TEDはwatson.ted.comをIBM Watsonとの共同プロジェクトとして公開しました。TEDトークの全アーカイブがカタログ化され、Watsonに取り込まれました。何千時間にも及ぶ動画に閉じ込められていた洞察が、機械学習による分析のために解き放たれたのです。音声テキスト化サービスが動画を文章に変換し、自然言語処理によって概念、人、場所、物事を抽出し、トピックごとに分類しました。
このプロセスでは、これまで文字起こしの中で構造化されていなかった言葉から、知識構造を作り出します。コンテンツはデータになりました。これは、機械学習があなたの読んだ本をすべて、そして読んでいない本もすべて読み、あらゆるコンテンツを比較して推薦を行うのと同じです。大規模な計算です。Facebook IDでTEDにログインすると、ソーシャルメディアへの投稿履歴にも同様の処理が行われます。システムはあなたとあなたの知人をかなり深く知るようになり、あなた個人の学習の楽しみに合わせて動画のリストを作成できます。これははるかに強力で有用であり、より正確である可能性もあります。
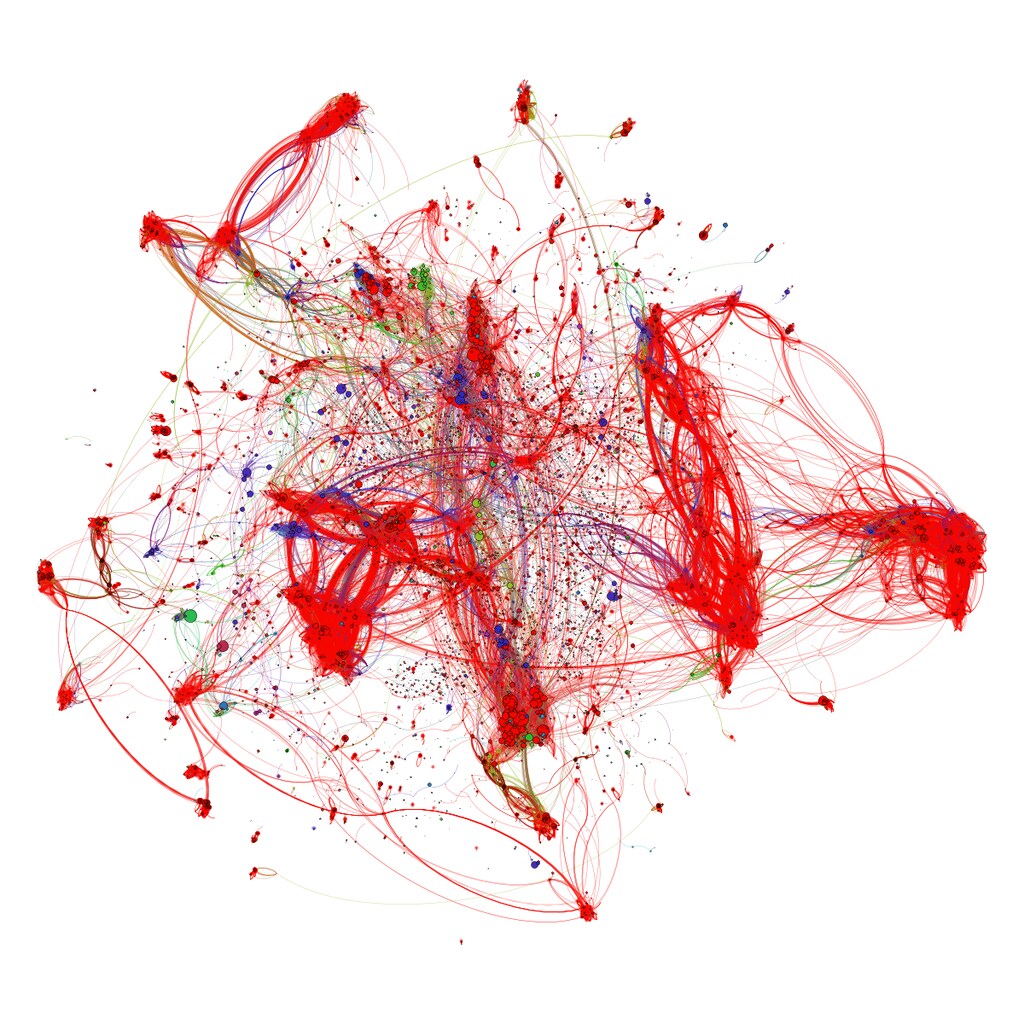
注:この画像は、記事「100万件の宿題を採点する半自動手法」に掲載されたスタンフォード大学のプロジェクトの可視化です。Courseraの機械学習コースに提出された約40,000件の学生課題を可視化するために用いられた手法の概要は、Jon Huangのサイトに掲載されています。
この種のアプローチに伴うリスクと見返りは明らかです。コンテンツチャンネルが量で市場を満たして競争優位を保とうとする中、人々は情報に圧倒されています。による調査では、エコノミストは、この現象によって世界の経営幹部の5分の3が混乱を感じており、ソートリーダーシップのコンテンツは過密状態となって価値を失っていることを確認しました。量に頼る方法が機能しなくなり、知識の流れが滞っています。人々に必要なのは、ネットワーク化された知識、個人に合わせた知識、そして学習のフィルターです。現状では、利用するコンテンツチャンネルを厳選することでしか実現できません。将来は、あなたを知る個別化されたアルゴリズムによって可能になるでしょう。データとして自分の情報を少し提供すれば、信頼に基づいてデータが尊重される形で使われる限り、パーソナライズされた情報をたくさん受け取れます。
新たな知識認識
世界経済フォーラムの『仕事の未来』レポートは、2015年から2020年の間に中核スキルの35%が変化すると指摘しています。同様に、フォレスターのレポートは、自動化可能な仕事の25%が4年以内にロボットに置き換えられると予測しています。この変化はますます目に見えるものになるでしょう。例えば、セルフサービス式でレジのないAmazon Go店舗は2016年12月にシアトルで開業しました。Uberのタクシーはサンフランシスコの路上を走っており、完全自動運転を実現する準備が整っているものの、DMVの承認を待っています。これらは必ずしも人型のロボットではありませんが、世界を感知し、繰り返し可能なプロセスの手順に沿って動く機械です。
身の回りでこれほど変化が起きる中、学習はますます生活のリズムに組み込まれていくでしょう。機械学習は、私たちが関心を持つテーマと理解度を結びつける役割を果たします。機械学習が私たちの能力を拡張する時代が進むにつれて、学習データは複数のチャネルで利用でき、持ち運び可能なものにしたいと考えるようになります。そして、学習ニーズに合う相手を見つける、より洗練された推薦サービスを求めるでしょう。
専門家とニッチなアイデアを交換するため、会議で会う機会はこれからも求められるでしょう。評価基準や認定を備えた体系的なカリキュラムによって、注意を学習に向けたいという思いも変わりません。また、グループでアイデアを共有し、学ぶ人と教える人のコミュニティに属していると感じたいと思うでしょう。その初期の兆しは、edX、Coursera、Khan Academy、Lynda.comや、ほかの大規模公開オンライン講座(MOOC)にすでに見られます。こうした講座には、相互評価、ディスカッション掲示板、自動採点、インタラクティブな演習、学習分析機能があります。Udacityは、明日の仕事に必要なシリコンバレーのスキルを身につけるための法人向け講座やナノディグリーも提供しています。
生涯にわたる機械学習が私たちの未来です。個人データを通じて、自分自身の教師を訓練し、ハイブリッド型の学習者になる機会が得られます。学習が個人に合わせて設計されるほど、人間中心のものになります。機械はデータの中からパターンを見つけ、問いかけることで、あなたが知らないことや、競争し成功するために知る必要があることを明らかにします。ネットワーク化され、相互につながった知識は、新たな洞察や機会、そしておそらく新しい学び方さえももたらすでしょう。
この記事で述べられている見解は、著者個人のものです。
この記事は、もともとE 180 Magazineに掲載されました。




