MITのCenter for Brains, Minds and Machinesの研究者らは、人間が物理的な問題の解決に役立つ3つの重要な能力を必要とすることを発見しました。
それらには、類似の状況からの事前知識、自分の行動の効果を想像する能力、そして失敗した際に戦略を素早く更新する方法が含まれます。
研究チームは新たな課題であるVirtual Toolsゲームを考案し、道具使用の能力を引き出すとともに、人間とAIモデルの双方で試行しました。
人間は生まれつき創造的に道具を使う存在です。釘を打ち込む必要があるのに金づちがない場合、私たちは重くて平らな物、例えば石をその代わりに使えることにすぐに気づきます。テーブルがぐらついているときには、脚の下に紙の束を置いて安定させられることを素早く思いつきます。しかし、これらの行動は私たちにとってあまりに自然に思えるものの、偉大な知性の象徴と考えられています。問題を解決するために物を斬新な方法で使うことができる他の種はごくわずかしかおらず、人間ほど柔軟にそれを行える種は一つもありません。では、このように物を使う強力な能力を私たちに与えているものは何なのでしょうか。
新たな論文において、Proceedings of the National Academy of Sciencesに掲載された研究では、MITのCenter for Brains, Minds and Machinesで行われた研究の内容が説明されています。研究者のKelsey Allen、Kevin Smith、Joshua Tenenbaumは、このような即興的な道具使用の根底にある認知的構成要素を研究しています。彼らは新たな課題として、Virtual Toolsゲームを考案しました。これは道具使用の能力を引き出すもので、参加者は「道具」の集合から一つの物体を選び、二次元のコンピュータ上のシーンに配置して、ボールを特定の容器に入れるなどの目標を達成しなければなりません。このゲームのパズルを解くには、物体を発射させる、遮る、あるいは支えるなど、多くの物理的原理に関する推論が必要です。
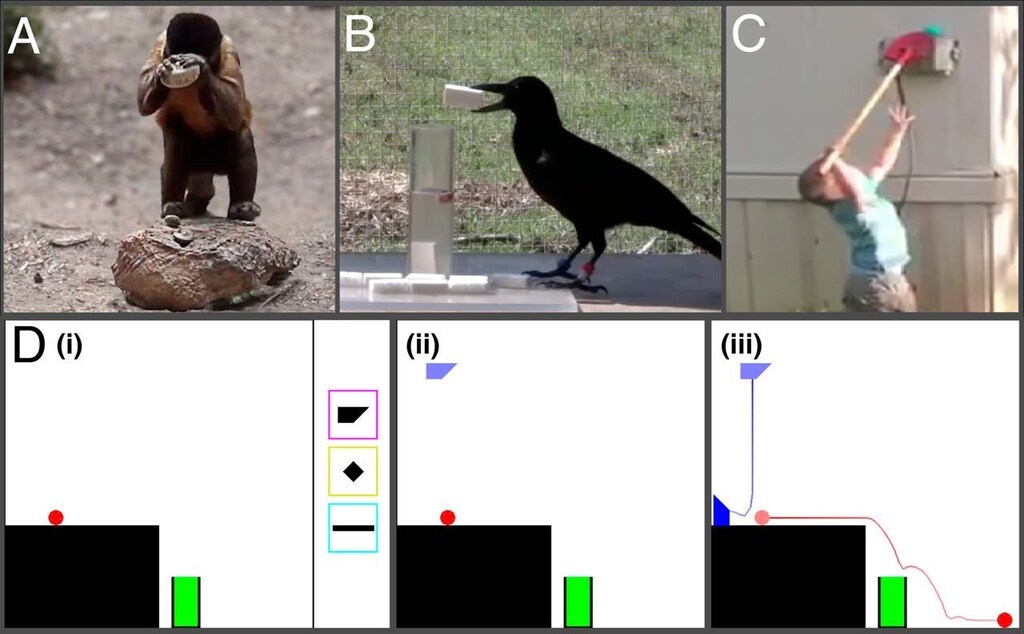
研究チームは、人々がこれらのパズルを解くために頼る3つの能力を仮説として立てました。それは、シーン内で効果をもたらす行動へと人々の行動を導く事前の信念、自分の行動の効果を想像する能力、そして、どの行動が解決策をもたらしやすいかについての信念を素早く更新する仕組みです。研究チームはこれらの原理を具体化したモデルを構築し、「Sample, Simulate, Update」、略して「SSUP」モデルと名付けて、人間と同じゲームをプレイさせました。その結果、SSUPは各パズルを人間と同程度の割合で、かつ同様の方法で解くことがわかりました。一方、Atariゲームをうまくプレイできる一般的なディープラーニングモデルは、物体や物理的構造を同様には備えていなかったため、直接訓練されていないパズルに知識を一般化することができませんでした。
この研究は、人間の道具使用を支える認知を研究し定式化するための新たな枠組みを提供するものです。研究チームは、この枠組みを道具使用の研究にとどめず、新たな問題に対して革新的な新しい道具をどのように生み出せるか、そして人間がこの情報をどのように伝達し、単純な物理的道具から、現在私たちの日常生活の一部となっているコンピュータや飛行機のような複雑な物へと発展させてきたのかについても拡張することを目指しています。
MITのComputational Cognitive Science Labに所属する博士課程の学生Kelsey Allenは、道具使用に関心を持つ他の認知科学者にとってVirtual Toolsゲームがどのように役立つ可能性があるかに期待を寄せています。「この領域にはまだまだ探求すべきことが山ほどあります。すでに複数の異なる機関の研究者と、ゲームを楽しいものにするとは何を意味するのかの研究から、身体性が身体を伴わない物理的推論にどう影響するかの研究まで、幅広いプロジェクトで共同作業を始めています。認知科学のコミュニティの他の方々にも、このゲームを物理モデルが意思決定や計画とどのように相互作用するかをよりよく理解するための道具として使っていただけることを願っています。」
MITの計算認知科学教授であるJoshua Tenenbaumは、この研究を、人間の認知と文化の重要な側面を理解するための一歩であるだけでなく、機械においてより人間らしい知能を構築する方法を理解するための一歩とも捉えています。「人工知能の研究者たちは、人間と同様に試行錯誤の経験から学習する強化学習(RL)アルゴリズムの可能性に大きな期待を寄せてきました。しかし、人間が恩恵を受ける実際の試行錯誤による学習は、今日のRLシステムのように数百万や数十億の経験ではなく、ほんのわずかな試行の中で展開されるものです」とTenenbaumは述べています。「Virtual Toolsゲームによって、人間におけるこの非常に迅速で、はるかに自然な試行錯誤による学習形態を研究することができます。そして、SSUPモデルが人間に見られる速い学習のダイナミクスを捉えられるという事実は、成功、失敗、そしてニアミスからも人間と同様に素早く柔軟に学習できる、RLへの新たなAIアプローチへの道筋を示している可能性があることを示唆しています。」




