人間にとって運転を学ぶことは、新たな状況や交通規則、技術に適応し、問題が起きたときの教訓を学ぶ、継続的なプロセスだ。
しかし、自動運転車はどのように運転を学ぶのだろうか。特に、何か問題が起きたときには?
先月、Uberに向けられたのは、まさにこの問いだ。先月の事故がアリゾナ州で起きた後のことだ。車内には同社のエンジニア2人が乗っており、自動運転車の1台が180度回転して横転した。
Uberは警察の捜査を待つ間、試験車両群を走行から引き揚げたが、数日後、車両は再び走行を開始した。
衝突、回転、横転
この事故に関する調査について、テンプル警察署がまとめた報告書は、EE Timesが入手し、何が起きたかを詳述している。
報告書によると、Uberのボルボ(下の図では赤色)は、制限速度40mph(64km/h)の区間を南向きに38mph(61km/h)で走行中、西向きに側道へ曲がろうとしていたホンダ(図では青色)と衝突した(地点1)。
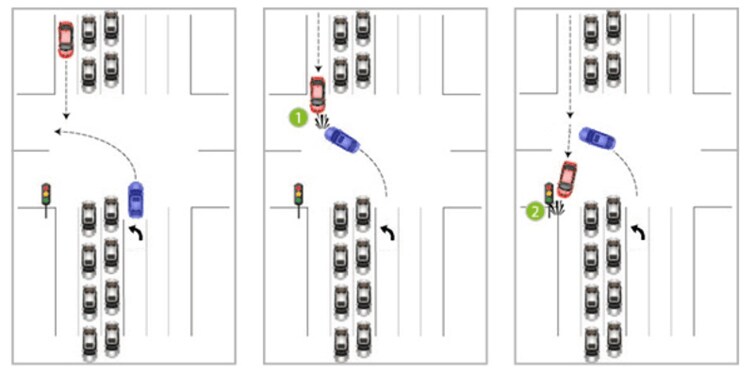
進路を外れたUberのボルボは交差点の信号機に衝突し(地点2)、その後、回転して横転しながら別の車両2台に損傷を与え(地点3、4)、横向きのまま滑って停止した(地点5)。
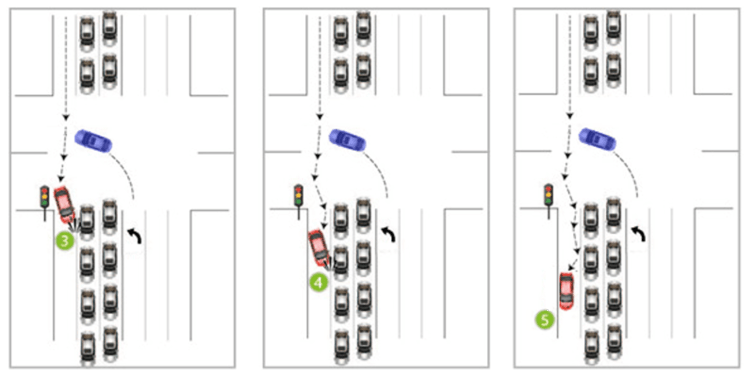
Uber車の事故―その後の衝突。テンプル警察署の報告書に基づく Alex Hanlon / Sean Welsh
幸い、けが人はいなかった。警察はホンダの運転手が「道を譲らなかった」(優先車両に譲らなかった)と判断し、違反切符を交付した。Uber車に過失はなかった。
疑問、また疑問
しかし、マイク・デムラー氏は、技術コンサルティング会社リンリー・グループのアナリストとして、EE TimesにUber車にはもっと適切な対応ができたはずだと語った。
見通しのきかない交差点を時速38マイルで進むのは、まったくもって不注意で愚かなことだ。
デムラー氏は述べた。車両が中央車線と最も左側の車線で交通が停止しているのを「見て」いたのに、制限速度をわずかに下回る速度で交差点を通過した理由を、Uberは説明する必要がある。
EE Timesの報道によると、Uberはこの事故について「沈黙を守っていた」。しかし、Uberは自動運転車の制御に「ディープラーニング」を使っているため、たとえ答える意思があったとしても、デムラー氏の質問に答えられるかどうかは明らかでない。
ディープラーニングでは、減速しないという判断を下す実際のコードは、ニューラルネットワーク内の複雑な状態であり、「交差点で視界が遮られていたら減速する」といった単純なルールを定めたコード行ではない。
ディープラーニングのデバッグ
この事例は、技術面で根本的な問題を提起している。ディープラーニングに基づく自動運転車の制御システムを、どうデバッグすればよいのか。隣を走る人間の運転手が誤った判断をしたとき、自動運転車が衝突して横転するリスクをどう減らせばよいのか。
デムラー氏の指摘は、見通しが遮られた交差点で慎重を期して減速することを、Uber車が「学習」していなかったという点にある。ほとんどの人間の運転手なら、停止車両によって視界が遮られている交差点に近づくと、自然に警戒して速度を落とすだろう。
「深層強化学習」では、方策を適用した結果として生じる状態を評価するために、「価値関数」が用いられる。
価値関数とは、ある状態を評価する数値だ。チェスでは、白の強い序盤の一手、たとえばポーンをe7からe5へ動かす手には高い値がつく。一方、ポーンをa2からa3へ動かすような弱い序盤の一手には低い値がつく。
価値関数は、コンピューターにとっての「痛い!」のようなものになり得る。強化学習という名称は、心理学における正と負の強化に由来する。
Uber車が何かに衝突し、ディープラーニングの価値関数が「その方策に従った結果、横向きになり、車体が壊れ、進行方向も間違えた。痛い!」というデジタル版の記録を残すまでは、Uberの制御システムはリスクを適切に数値化できないかもしれない。
何かに衝突した今、願わくば、手痛い経験を通じて教訓を学んだことだろう。今後、同様の交通状況にある似た交差点では、Uber車はより適切に対応できるはずだ。
形式論理のデバッグ
ディープラーニングに代わる方法として、形式論理で表現した明示的なルールを使う自動運転車がある。
この方法を開発しているのはnuTonomyで、シンガポール当局と協力して自動運転タクシーの試験運行を実施している。
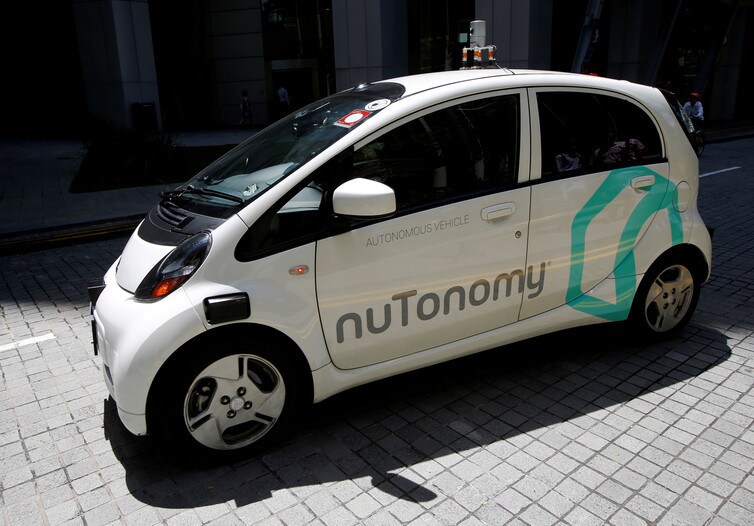
NuTonomyの自動運転車制御方式は、ルールの優先順位に基づいている。最優先されるのは「歩行者にぶつからない」といったルールで、次に「他の車両にぶつからない」「物体にぶつからない」が続く。
「安全なときは速度を保つ」「センターラインを越えない」といったルールの優先度は低い。一方、「乗り心地を快適にする」といったルールは、緊急事態が起きた際に最初に破られる。
NuTonomyは多くの用途に機械学習を使っているが、規範的制御、つまり車が何をすべきかを決めるためには使っていない。
昨年10月、NuTonomyの試験車両が事故に巻き込まれた。低速で接触してへこみができたものの、回転や横転はしなかった。
同社の最高執行責任者、ダグ・パーカー氏は、IEEE Spectrumに語った。
必要なのは、後から振り返って、「あの状況で私たちの車は正しいことをしたのか。正しく判断できなかったとすれば、なぜか」と言えることです。形式論理なら、それはとても簡単です。
形式論理の主な利点は、正しさを証明でき、比較的デバッグしやすいことだ。機械学習のデバッグはより難しい。一方、機械学習なら、複雑なルールの階層をコードにする必要がない。
自動運転車に運転を教える方法としてどちらが優れているかは、時がたてば分かるだろう。今のところ、どちらのシステムにも学ぶべきことは多い。




