Appleが最近開催した 世界開発者会議では、目玉の一つとして、モバイルOSの最新アップデートである iOS 9に、パーソナルアシスタントアプリSiriの音声認識機能が追加された。
今では、Siriに「明日、ケビンの誕生日を思い出させて」と頼む代わりに、誕生日のFacebookイベントを見ながら、文脈に頼って「これを思い出させて」と尋ねるだけでよい。Siriは意味を理解する。
Googleの端末にも、少し前から同様の技術が存在している。 OK Google のおかげで、文脈を認識する音声認識にますます近づいている。
しかし、これはどのように機能するのだろうか。なぜ文脈が重要で、音声認識とどう結びつくのだろうか。
この問いに答えるには、音声認識の仕組みと、もう一つの重要分野である自然言語処理との関係を振り返る価値がある。
音声認識の簡単な歴史
音声認識は長い間、世間の関心を集めてきた。キーボードをたたく代わりに、自然な言葉でコンピューターに話しかけ、言うことをすべて理解してもらえたら、どんなにいいだろうか。
1960年代のオリジナル版『スター・トレック』シリーズで、カーク船長がUSSエンタープライズのコンピューターと会話して以来(そして後年のオリジナルシリーズ映画の一作で、スコッティが20世紀のコンピューターに話しかけようとして 失敗した試み 以来)、私たちはこれがどのように実現するのかを夢見てきた。
より近年を舞台にした映画でさえ、音声認識の向上というアイデアを取り上げてきた。テクノロジーを主題とする1992年の映画 『スニーカーズ』 では、ロバート・レッドフォードが幹部の声の断片を苦労して集め、テープレコーダーでコンピューターに再生し、システムへの音声アクセスを得る。
しかし、SF作品で描かれる単純さの裏には、音声認識技術の複雑な処理が隠れている。コンピューターは、あなたの意図を理解する以前に、あなたが何を言ったかを理解できなければならない。
これには、音声サンプリング、特徴抽出、そして個々の音を認識してテキストに変換する実際の音声認識を含む、複雑な処理が伴う。
研究者たちは長年、この技術に取り組んできた。人間の耳と似た方法で特徴を抽出し、人間が発話の一部として発する音素や音として認識する手法を開発してきた。ここでは、 人工ニューラルネットワーク、 隠れマルコフモデル など、人工知能という広い分野に属するさまざまな考え方が用いられている。
こうしたモデルによって、音声認識率は向上してきた。Googleは 今年、 誤り率が8%未満になったと報告した。
しかし、こうした進歩を遂げても、音声の認識は戦いの半分にすぎない。コンピューターがこの処理を終えた時点で得られるのは、あなたが言ったことを再現したテキストだけだ。しかし、あなたは何でも言えたはずだ。
次の段階は自然言語処理だ。
要点はつかめただろうか?
機械は話した内容をテキストに変換した後、実際に何を言ったのかを理解しなければならない。この処理は「自然言語処理」と呼ばれる。人間の言語には文脈や意味が豊富に含まれており、自然言語を認識する処理を難しくするため、これは音声認識よりも難しいと言える。
初期の音声認識システムを使ったことがある人なら、これがいかに難しいか証言できるだろう。初期のシステムは語彙が非常に限られており、コンピューターにコマンドを確実に理解させるには、決められたとおりの言い方をする必要があった。
これは音声認識システムだけでなく、テキスト入力システムにも当てはまった。そこでは語順や特定の単語の有無が、システムによるコマンド処理に大きく影響した。初期の言語処理システムは、固定的なルールや決定木を使ってコマンドを解釈していたため、コマンドから少しでも外れると問題が生じた。
しかし、より新しいシステムは、音声認識で使われる隠れマルコフモデルに似た機械学習アルゴリズムを用いて語彙を構築する。こうしたシステムにも学習させる必要はあるが、使われた個々の単語の重み付けに基づいて、より柔軟な判断を下せる。そのため、使う言葉を変えても問い合わせの内容は同じに保てる、より柔軟な質問が可能になる。
だからこそ、Siriには「午前9時にクリーニングを取りに行く予定をカレンダーに登録して」と尋ねても、「午前9時にクリーニングを取りに行く予定をカレンダーに入力して」と尋ねても、同じ結果を得られる。
では、声の違いにはどう対処するのだろうか?
こうした進歩にもかかわらず、この分野にはまだ課題が残っている。音声認識では、アクセントや発音が依然として問題を引き起こすことがある。
システムの仕組み上、音素の発音が異なると、システムが発話内容を認識できないことがある。これは特に、ある単語の音素が(その土地の人でない者には)発音とまるで結びつかないように見える場合に当てはまる。たとえば英国の都市「Leicester」や「Glasgow」だ。
オーストラリアの都市「Melbourne」でさえ、一部のアメリカ人を戸惑わせるようだ。オーストラリア人にはMelbourneの発音はごく明らかだが、アメリカでは音素の使い方が異なるため、しばしば誤って発音される(地元びいきの耳にはそう聞こえる)。
GPSシステムがIpswichを「eyp-swich」と誤って発音するのを聞いたことがある人なら、逆方向でも同じことが起きると分かるだろう。これを避ける唯一の方法は、単語のさまざまな発音をシステムに学習させることだ。しかし、アクセントの違い(さらには同じアクセント内の発音の違い)を考えると、これはかなり大規模で複雑な作業になりうる。
言語処理の側では、主な問題は文脈にある。冒頭の例は、文脈を踏まえた言語処理の最先端を示している。しかし、会話に数分間注意を向けるだけで、機械に追加の文脈を与えるために、私たちが話し方をどれほど変えているかに気づくはずだ。
たとえば、誰かにこう尋ねることはどれくらいあるだろう。
私のメール、届いた?
しかし、実際に言いたいのはこういうことだ。
私のメール、届いた?届いていたら、読んで、質問への返答として返信してもらえますか?
最初の質問に続けて質問を重ねるなど、機械と会話しようとすると、さらに複雑になる。たとえば「マーティンの番号は?」と尋ねた後に、「彼に電話して」あるいは「彼にメッセージを送って」と続ける場合だ。
機械は文脈の理解を向上させているが、まだ道のりは長い!
自動翻訳
ここまで来るために、私たちはさまざまな分野で大きな進歩を遂げてきた。しかし、アクセントの認識、言葉に含まれる含意、会話の文脈には、なお課題が残されている。つまり、『スター・トレック』のコンピューターのように、私たちの言うことをすべて解釈する機械が実現するまでには、まだしばらくかかるかもしれない。
しかし、心配はいらない。私たちは少しずつ近づいている。Microsoftによる最近の 自動翻訳 の進歩は、うまく実現できれば、非常に興味深い結果になりうることを示している。
Googleは最近、画像認識または音声認識、自然言語処理、スマートフォンのカメラを組み合わせ、一つの言語から別の言語へ、看板や短い会話を自動翻訳する技術を公開した。看板が英語になっても同じように見えるよう、フォントまで合わせようとする。
もうイタリア語のメニューを前に悩んだり、英語を話さないウェイターにどう注文するか迷ったりする必要はない。Googleに任せればよい。USSエンタープライズにはまだ及ばないが、確実に近づいている!
この記事は The Conversationとの協力により掲載されています。 元の記事を読む。掲載は、世界経済フォーラムが見解を支持することを意味しません。
アジェンダの最新情報を受け取るには、 週刊ニュースレターに登録してください。
著者:Michael Cowlingは、セントラル・クイーンズランド大学のモバイルコンピューティング&アプリケーション担当上級講師兼分野リーダー。
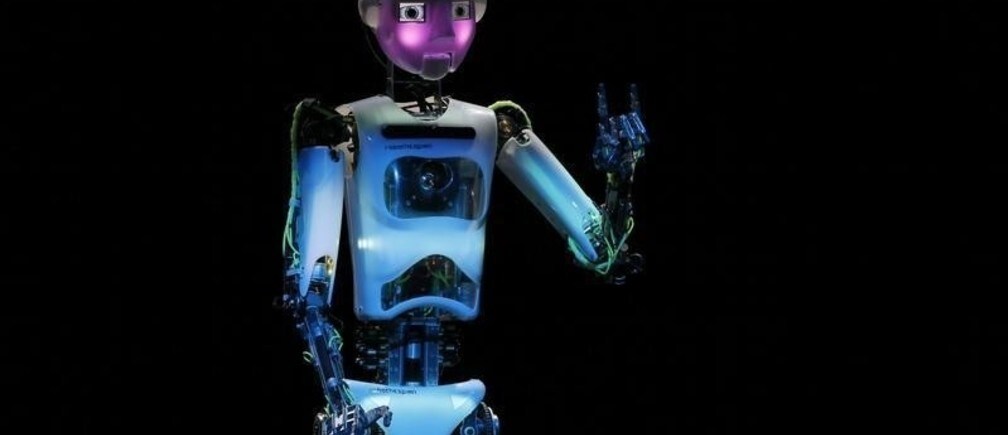
画像:英国企業RoboThespianのヒューマノイドロボットが、ハノーバー技術見本市の開会式で「頬を赤らめる」。REUTERS/Wolfgang Rattay


