AnyScale Learning For All(ALFA)グループ は MITコンピューター科学・人工知能研究所(CSAIL) に所属し、一般的な分析の範囲を超える問いなど、最も困難なビッグデータの問題の解決を目指している。ALFAは、最新の機械学習と進化計算の概念を応用し、高次元性を伴う非常に複雑な問題に取り組む。
「今、人々には実に多くの異なるチャネルからデータが届いています」と、CSAILの主任研究科学者でALFAディレクターのウナ=メイ・オライリーは語る。「私たちは、そうしたチャネル間のデータをつなぎ、結び付ける支援をしています。」
ALFAグループは、風力発電所の配置から、血圧データに含まれる拍動を調査・分類して低下や急上昇を予測することまで、幅広い課題に取り組んできた。また、MOOCでの学習行動を予測するために膨大な記録済みクリックデータを分析し、IRS(米国内国歳入庁)が高額な脱税スキームを防ぐ支援も行っている。
ALFAは、情報源から直接得られる未加工データを扱う課題を好む。その後、さまざまな手法でデータを調査するが、その大半にはスケーラブルな機械学習と進化計算アルゴリズムが関わる。
「機械学習は、データを過去にさかのぼって調べ、将来を予測するのにとても役立ちます」とオライリーは語る。「進化計算も同じように使えますし、特に非常に高次元の大規模問題に適しています。」
過去には、予測モデルや分類ラベルを推論するのに十分なデータがないことが、機械学習の課題だったとオライリーは言う。「今ではデータが多すぎるため、膨大な量のデータ事例を処理しようと、スケーラブルな機械学習を活用しています」と彼女は語る。「また、極めて高次元の問題に伴う追加の変数に機械学習が対処する能力も高める必要があります。」
オライリーは、ALFAのもう一つの主要なツールである進化計算に特に関心を寄せている。「集団ベースの適応や遺伝的継承といった進化の考え方を取り入れ、計算モデルに持ち込むことは非常に効果的です」と彼女は言う。「工学では、最適化に共分散行列適応のような進化アルゴリズムや、離散値アルゴリズムをよく使います。また、進化アルゴリズムは驚くほど簡単に並列化できるため、最新のデータ知識発見問題の多くに対処できます。」
進化分野の中で、オライリーがとりわけ関心を持つのは遺伝的プログラミング、彼女の定義によれば「プログラムの進化」だ。「遺伝的プログラミングのアルゴリズムを多数のノードに分散させ、データをノード間で分割します」と彼女は説明する。「並列に計算できる独立した解をすべて集めて統合します。次に、弱い解を取り除き、より強い解をまとめて融合し、アンサンブルを作ります。アンサンブルベースのモデルは、すべてのデータに基づく単一モデルより精度が高いことを示してきました。」
風力発電所の配置
ALFAの最も成功したプロジェクトの一つは、風力発電所の設計を支援するアルゴリズムの開発だ。特に数百基の風力タービンが関わる場合、非常に高次元の問題になるとオライリーは言う。
「タービンの配置を最適化すれば、大きな効率向上が見込めますが、非常に複雑な問題です」と彼女は言う。「まず、タービン自体のパラメーターがあります。発電量、高さ、そして近接円錐です。その場所にどれだけの風が必要かを把握し、風がどこから、どの程度の量で吹いてくるかについて、より詳細な情報を得なければなりません。土地の地形条件と、風がその上を吹き抜ける様子も考慮する必要があります。」
オライリーによれば、最も難しい変数は、あるタービンが後方のタービンに及ぼすウェイク効果だ。「各タービンの背後で生じる損失を計算できるよう、非常に複雑な流体モデリングを行う必要があります。」
ALFAは、1,000基を超えるタービンを備えた風力発電所にも対応できるよう、スケールアップ可能な並列化進化アルゴリズムの適用方法を見いだした。「これまで誰も実現したことのない規模で、タービンを配置できるようになりました」とオライリーは語る。
最近、ALFAは立地設計のための生成テンプレートを構築している。「今は、進化の概念を使って、どんな場所にも、どんな一組のタービンでも配置できるプログラムを開発しています」と彼女は言う。「場所そのものを設計するのではなく、設計プロセスを構築しているのです。」
GigaBEATS:血圧データを読み解く
風力発電所の配置に使われる進化と機械学習の概念の多くは、臨床データから知見を引き出すことにも応用できる。ALFAは、医療センサーから収集される生理データの増加する量から、有用な情報を引き出そうとしている。データには、睡眠パターンから心電図(ECG)、血圧まで、あらゆる測定値が含まれる。
「臨床医がこれほど大量のデータを理解するのは困難です」とオライリーは語る。「信号レベルの情報を取り出し、機械学習と組み合わせて、より優れた予測を行うことに関心があります。」
研究者は、少数のサンプルから少量のデータを集め、18か月を超える期間を要する研究を行う傾向があるとオライリーは言う。「その18か月を数時間に短縮したいのです」と彼女は語る。
ALFAは、非常に大規模な生理データの集合から知識を抽出するGigaBEATSというプロジェクトに取り組んでいる。当初、このプロジェクトでは集中治療室の数千人の患者から得た血圧データを研究してきた。
「私たちは一拍ごとの微細な特徴を調べています」とオライリーは語る。「最終的には、それらの特徴を過去の区間ごとに集約し、血圧の急上昇を予測できるようにします。」
ALFAグループはBeatDBというデータベースを作成した。波形の拍動だけでなく、「一拍ごとの特性や特徴の集合」も収集するとオライリーは言う。BeatDBにはすでに、5,000人を超える患者から得た血圧の拍動特徴が10億件保存されている。
「一拍ごとに、形態的特徴の時系列データを記述します」とオライリーは説明する。「信号に関する基礎データの確かな集合を確立すれば、その上にサービスとして技術を提供し、新たな拍動を追加して処理できるようになります。」
BeatDBでは拍動を区間ごとに集約できるため、医師は予測にどれだけの履歴データが必要かをより適切に判断できる。「15分先の血圧低下を予測するには、患者の数時間分のデータが必要かもしれません」とオライリーは語る。「BeatDBのデータは整理され、機械学習アルゴリズムを活用しているため、医師がこれを何度も計算する必要はありません。必要なデータ量や予測リードタイムを試し、モデルの精度を確認できます。」
最近、オライリーはこの技術を心電図(ECG)データの探索に使い始めた。「クオンティファイド・セルフの文脈で収集される可能性のあるデータを調べたいと考えています」とオライリーは語る。これは、フィットネス用ブレスレットを身に着け、自分の体内データを追跡する新たな実践を指す。
「Fitbitを身に着けて、疲れているか、どれだけよく眠れているかを知らせてもらうなど、自分自身に計測機器を装着する人が増えています」とオライリーは語る。「こうした身体信号を解釈することは、GigaBEATSプロジェクトと似ています。これらの信号を解釈するため、BeatDBのようなデータベースとクラウドベースの設備を構築できます。」
この記事は MIT News との協力のもと掲載されています。掲載は、世界経済フォーラムが見解を支持することを意味するものではありません。
Forum:Agendaの最新情報をお届けします。 週刊ニュースレターに登録。
著者:エリック・ブラウンはMIT Newsのゲスト寄稿者です。
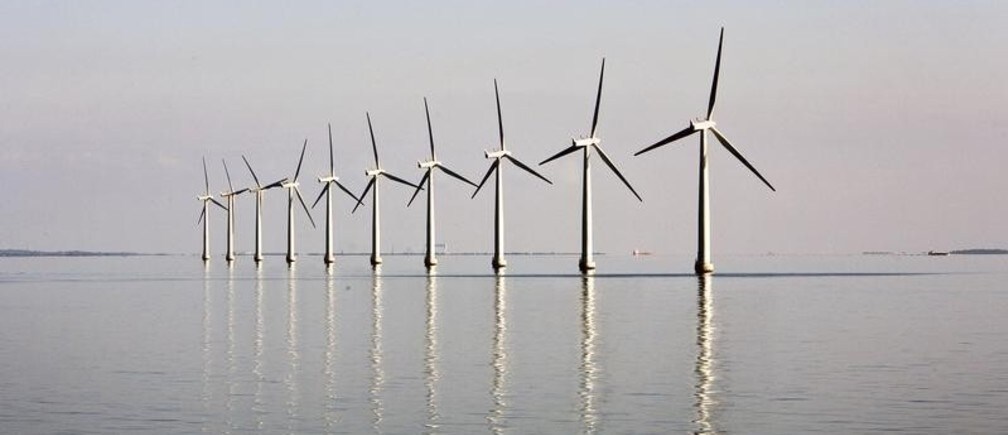
画像:2008年5月19日、デンマークのサムソ島近くの海上に立つ洋上風力発電所。REUTERS/Bob Strong。


