がんの患者を正確に診断し、がんの具体的な種類を特定することは、患者の治療を成功させるうえで極めて重要です。
現在、医師は類似する十数例ほどの症例や、ガイドラインをまとめた分厚い書籍を参考にするかもしれません。しかし、検査結果と病歴を、類似データを何百万件も分析したコンピュータープログラムに入力できるとしたら、どうでしょうか。
そうした未来がますます現実味を帯びているのは、MITの コンピューター科学・人工知能研究所 (CSAIL)の研究者たちのおかげです。マサチューセッツ総合病院(MGH)のチームと協力し、博士課程の学生であるYuan LuoとMIT教授のPeter Szolovitsは、過去の病理報告書から何千ものデータ項目を学習し、がんの診断候補を自動的に提示することを目指す計算モデルを開発しました。この研究は、 今月、 Journal of the American Medical Informatics Associationに掲載されました。
リンパ腫の診断精度向上
研究者たちは、50を超える明確なサブタイプがあり、互いの見分けが難しいことも多い一般的ながん、リンパ腫のうち、最も多く見られる3つのサブタイプに焦点を当てました。MGHのリンパ腫センター所長で論文の共著者でもあるEphraim Hochbergによると、リンパ腫症例の5~15%超が当初、誤診または誤分類されています。リンパ腫の種類によって必要な治療計画が大きく異なるため、これは重大な問題になり得ます。
たとえばHochbergは最近、リンパ腫は治癒不能だと誤って告げられた患者を診ました。彼が正確に診断し、積極的な治療計画を立てていなければ、がんの進行を食い止めるには手遅れになっていたかもしれません。
リンパ腫の分類は、病理医や臨床医の間で長年議論の的となってきました。2001年に世界保健機関(WHO)が合意に基づく分類を発表するまで、少なくとも5種類のガイドラインがありました。WHOは2008年、運営委員会の8人と世界各地の病理医・血液専門医130人超が関わる、労力を要する過程を経てガイドラインを改訂しました。さらに、50のサブタイプを網羅するために検討されたのは、欧州と北米の約1,400症例に限られていました。そのため、平均すると、各サブタイプの診断基準は限られた人数に起きたことだけを根拠としていました。
一方、MGHのような大規模医療機関は、数十年分の病理報告書を保管していることがよくあります。MITの研究者たちは、こうした資料を活用して、医師がリンパ腫の診断方法をより深く理解する助けとなる自動化ツールを開発できないかと考えました。
「分類ガイドラインが最新であり、多数の患者症例を正確に要約したものとなるようにすることが重要です」と、論文の筆頭著者であるLuoは述べます。「私たちの研究では、詳細な医療症例を精査し、医師がリンパ腫間の微妙な違いをより包括的に捉えられるよう支援します。」
医師にとって理解しやすいモデル
Luoは、こうした機械学習モデルは正確であるだけでなく、臨床医が解釈できるものでなければならないと強調します。WHOガイドラインの基準は、腫瘍細胞や表面抗原などの医療概念間の関係を表す検査結果のパネルを通じて示されています。そうした関係を捉えるため、研究者たちは病理報告書の文をグラフ表現に変換しました。グラフのノードは医療概念、エッジは構文上・意味上の依存関係を表します。 以前の論文で説明したとおり、次に、検査結果に関わる関係を示す、頻繁に現れる部分グラフを収集しました。
「臨床医の診断推論は、複数の検査結果を同時に基にしています」とLuoは述べます。「そのため、検査結果のパネルに対応するように、部分グラフを自動的にグループ化する必要があります。これにより、他の多くの機械学習モデルについて臨床医がよく不満を述べるようなブラックボックスではなく、臨床医が解釈できるモデルになります。」
この研究の中核的な貢献は、Subgraph Augmented Non-negative Tensor Factorization(SANTF)と呼ばれる手法を用いることです。SANTFでは、800件ほどの医療症例データを三次元の表に整理します。各次元は、患者の集合、頻出する部分グラフの集合、そして報告書に記載された各データ項目の中およびその周辺に現れる単語群に対応します。この方式では、各次元の関係を使って他の次元の関係を制約しながら、これらの次元を同時にクラスタリングします。得られたクラスターを調べることで、研究者たちは検査結果のパネルをリンパ腫のサブタイプと結び付けられます。
「Luoの研究を非常に大規模なデータセットに適用した場合に期待されるのは、クラスターの特定に役立つ基準によって、リンパ腫の幅広い種類と、それらの臨床上の相互関係をどう理解すべきかを医師に伝えられることです」とPeter Szolovitsは述べます。
「臨床報告における自然言語処理の多くは、重要な語句や属性の特定に重点を置いており、より難しい、関係性や概念を認識する課題には取り組んできませんでした」と、ユタ大学生物医学情報学部門長のWendy Chapman教授は説明します。「長年の経験を持つ医療専門家は、単語だけでなく、その奥にある含意も理解できます。この研究は、そうした理解力を実現できる堅牢なコンピューターモデルの開発に一歩近づくものです。」
さらに、SANTFモデルはラベル付きの訓練データを必要としないため、知識発見のプロセスを自動化できます。Szolovitsは、チームのモデルが、より包括的な根拠に基づいて医師がリンパ腫をより正確に診断するのに役立ち、将来のWHOガイドラインに組み込まれる可能性さえあると確信しています。
「私たちの究極の目標は、数百万件規模の非常に大量のリンパ腫データに、これらの技術を適用できるようにすることです」とSzolovitsは述べます。「それが実現し、異なるサブタイプに固有の特徴を特定できれば、医師の仕事を容易にし、ひょっとすると患者の寿命を延ばすうえでも、大きく前進するでしょう。」
この記事は、 MIT Newsとの協力により掲載されています。掲載は、世界経済フォーラムが見解を支持することを意味するものではありません。
Agendaの最新情報を得るには、 週刊ニュースレターにご登録ください。
著者:Adam Conner-Simonsは、MIT Newsの寄稿ライターです。
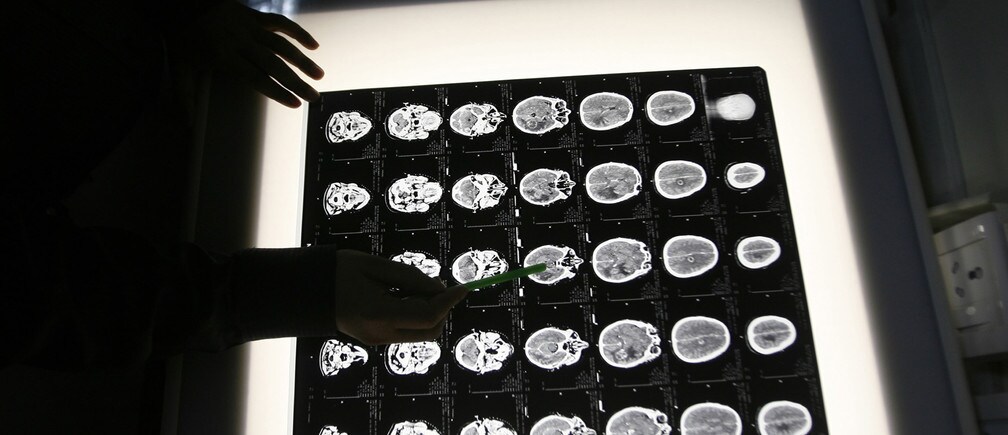
画像:North Bengal Oncology Centerで、がん予防のための健康診断を受けた患者の脳のX線画像を放射線科医が確認している。REUTERS/Rupak De Chowdhuri。