世界では今も17億人が正規の銀行口座を持てずにいます。
AIなどのデジタルイノベーションは、金融包摂の拡大に役立っています。
適切なインフラ、データ共有の環境、倫理的な枠組みがあれば、AIは金融サービスの民主化を実現できます。
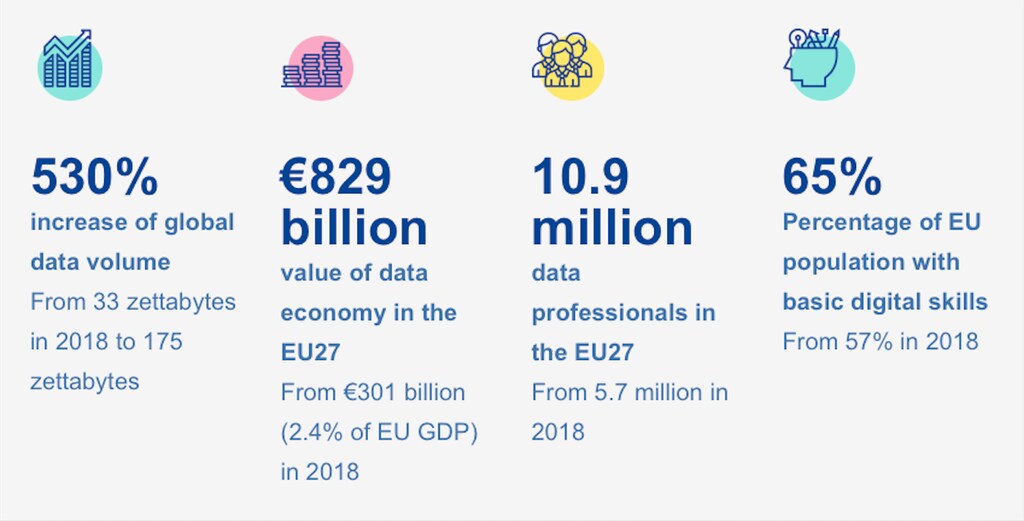
世界で生成されるデータ量は、2018年の33ゼタバイトから、2025年には175ゼタバイトへと、530%もの大幅な増加が見込まれています。AIには、このような膨大なデータを金融包摂につなげる力があります。本稿では、比較的新しい技術であるAIがもたらすリスクを抑えつつ、その可能性を活かすために、官民が取り得るさまざまなガイドラインを提言します。
金融包摂のためのデジタル識別システム
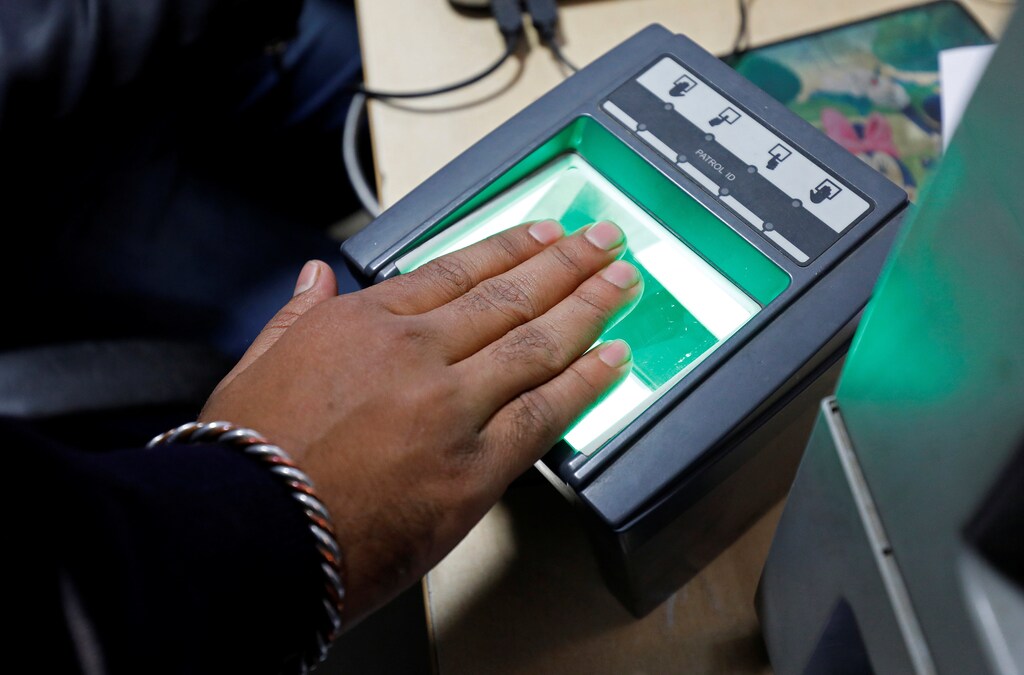
政府や規制当局は、ラストマイルの利用者に届けるためのコストを削減する新たなデジタル識別インフラの構築で協力してきました。インドは「インディア・スタック」と呼ばれる基盤的なデジタル基盤の構築により、この分野を先導してきました。代表的な例として、インド政府が発行する12桁の固有IDであるAadhar(アドハー)と、インド中央銀行が規制する、相互運用可能でモバイルを基本とした決済システムであるUPI(Unified Payments Interface)があります。
Aadharは、13億人に信頼できるIDを提供することで銀行口座へのアクセスを可能にし、UPIは、プラットフォームを越えた即時決済を初めて実現しました。これらのアプリケーションを合わせることで、取引コストを大幅に削減し、利用者データを大規模に取得・共有できるようになり、金融イノベーションが促進されてきました。
インドのフィンテック・エコシステムは世界で最も活発なものの一つですが、オープンで自由な市場を可能にするこれらの中核的なデジタル基盤がなければ、今のような姿にはなっていなかったでしょう。
データポータビリティと、融資・金融分野への応用
インフラが整備されると、データは金融サービス事業者がその価値を最大限に引き出すための燃料となります。この燃料がなければ、フィンテックは遠くへ進むことができず、データポータビリティがなければ、燃料はほとんど得られません。データポータビリティとは、個人データを一つの組織から別の組織へ容易に移行できる利用者の権利を指します。実際には、データがもはや特定の組織の囲い込みの中に保存されないことが求められます。むしろ、データは利用者が所有し、他のサービス事業者と共有できるものであるべきです。このデータ共有の枠組みの根底にある原則は、利用者が生成したデータは公共財であり、単一の事業者による競争優位の源泉ではなく、競争の源泉となり得る、またそうあるべきだということです。
このデータ共有の原則は、インドではアカウント・アグリゲーター(AA)の枠組みを通じて実践されています。AAは「同意管理者」として設計されており、利用者が同意に基づき、銀行や保険会社などの他の規制対象事業者とデータを共有できるようにします。このアプローチは、特に資金調達が不足している中小企業(SME)分野にとって、融資・金融分野に有益です。
フォーラムは、政府が責任を持ってAI技術を導入できるよう、どのように支援しているのでしょうか。
同国の中小企業のおよそ90%が正規の融資を受けられずにいます。AAの枠組みにより、小規模事業者は必要な書類を貸し手が利用できるようにすることができ、貸し手はそれに基づいてより適切に審査を行い、小規模事業者にサービスを提供できるようになります。慎重に設計されたシステムを通じて、AAの枠組みは同意に基づく利用者データの共有を可能にし、取引コストを抑え、金融包摂を促進します。
倫理的なAIを開発するためのガイドライン
インフラやデータと同様に重要なのは、AIの能力そのものがフィンテックの普及度を左右するということです。大量のデータは新たな機会を開きますが、その恩恵を受けられるのは、データが利用可能な人々に限られます。取り残されている人々が十分に代表されていない場合や、基盤となるアルゴリズムに偏りがある場合、AIは社会的な偏りを再生産してしまう可能性があります。現状ではAIアルゴリズムを規制する法律が存在しないため、この可能性はさらに高まっています。こうした状況において、民間セクターの関係者には、規制を待つのではなく自ら率先して行動し、AIの適用が公平なものとなるよう取り組むことを強く求めます。この目的に向けて、三つのヒントを提示します。
1. 偏りのリスクを減らすために、チームの多様性を高める
コロンビア大学の研究者は、偏った予測の最大の原因は偏ったデータであるものの、エンジニアの属性も一因となることを明らかにしています。個々の人物はそれぞれほぼ同程度の偏りを持っていましたが、均質なチームでは個人の偏りが増幅されていました。したがって、チームの多様性が高いほど、偏りを発見し、減らす能力が高まります。
2. AIアルゴリズムが、専門家や一般の人々を含む他者にとって説明可能であることを確保する
オックスフォード研究所の研究者は、「反事実」という概念を提唱しています。完全な説明ではなく、反事実は、別の判断につながっていたであろう最小限の条件を示します。これらの条件を把握することで、利用者が現在の状態を変えるために必要な情報を得られるようになり、包摂への道筋が開かれます。
3. 専門家を起用してアルゴリズムを監査する
倫理を開発サイクルに組み込みたい人々を支援するための枠組みは、さまざまなものが存在します。一から作り直すのではなく、これらのツールの開発者や専門家を取り込みましょう。専門家の関与が難しい場合は、意思決定から人間による介入を完全に排除しないようにしてください。AIアルゴリズムは向上しつつありますが、人間の判断力は依然としてより洗練されており、より公平なアルゴリズムを監査・設計するために活用されるべきです。
適切なインフラ、データ共有の環境、倫理的な枠組みがあれば、AIを活用して、より多くの人々、特に最も貧しい人々に金融サービスを届けることができます。この可能性を現実のものにしなければなりません。
詳細については、こちらをご覧ください:corporate.payu.com




