世界経済フォーラムの週刊ポッドキャスト「Radio Davos」は、生成人工知能(AI)に関する特別シリーズを配信しています。
第1話では、AIが突如として見出しを独占している理由を探り、IBMのAI倫理責任者と上級AI教授の見解を紹介します。
AIは「強力な野生の獣」なのか――人類の利益のために飼いならすことはできるのか?
AIポッドキャストシリーズ:
第1話:AI:誰もがこの「強力な野生の獣」の約束とリスクについて語っているのはなぜか
第2話:共通の利益?私たちがまもなく皆使うことになるAI製品を作る企業
第3話:責任あるAI:哲学はより良い技術づくりにどう役立つか?
第4話:「AIは私たちと競争するか、私たちを補完するか」――では、どの道を選ぶべきか?
第5話:AI:利害関係者を結集し、AIを全員のために機能させる
ボーナス回:AI――何がうまくいかない可能性があるのか:スチュアート・ラッセル教授
「世界中の人々が初めてAIシステムを利用し、対話できるようになりました。誰もがAIシステムの能力を体験できるため、まさにゲームチェンジャーです。」
IBM Researchの倫理責任者であるフランチェスカ・ロッシは、ChatGPTについて語っています。まだ生成AIツールを使ったことがなくても、少なくとも耳にしたことはおそらくあるでしょう。昨年末の登場以来、ChatGPTは史上最も急成長した消費者向けアプリとなりました。
ChatGPTや他の「大規模言語モデル」の爆発的な普及により、AIの可能性が人々の意識に浸透し、倫理や機会に関する多くの疑問が生じ、多くの規制当局は対応に苦慮しています。
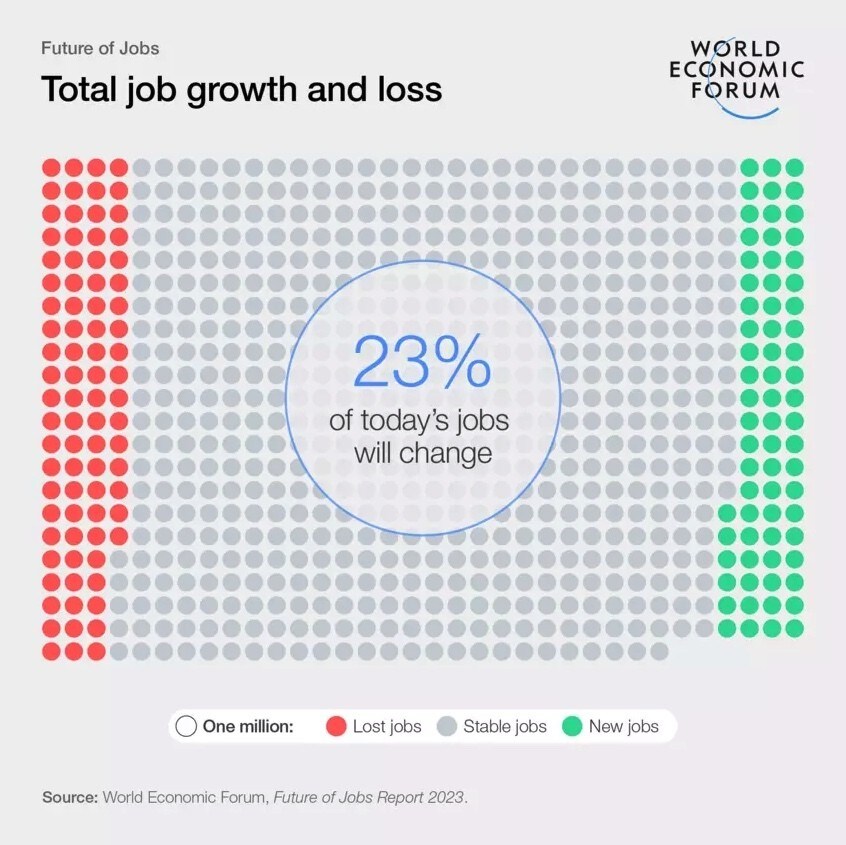
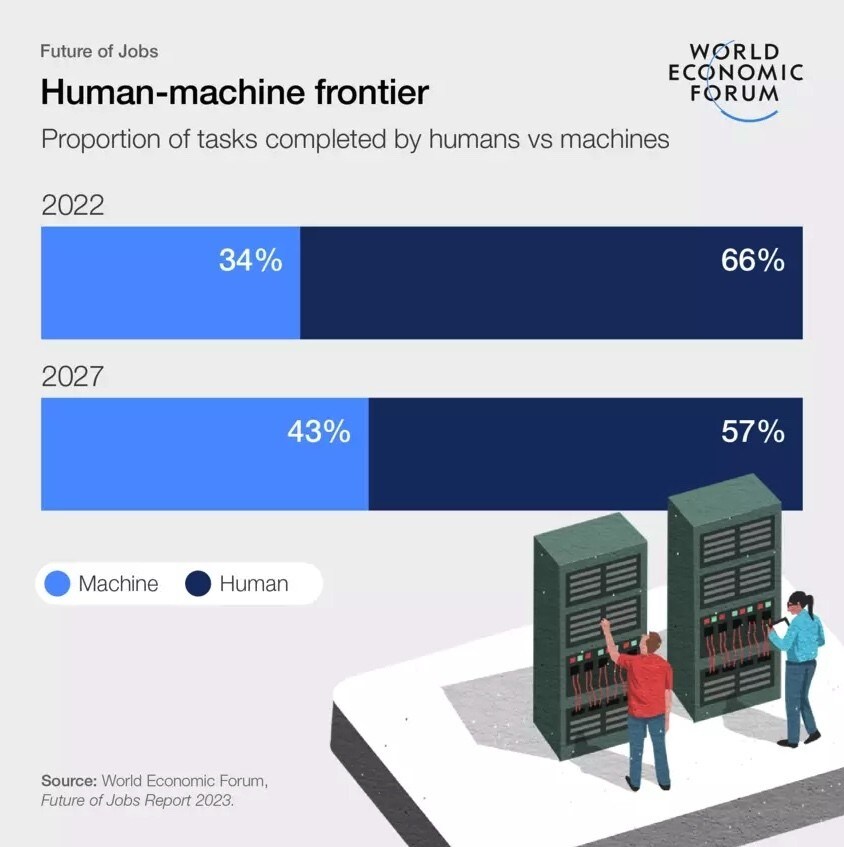
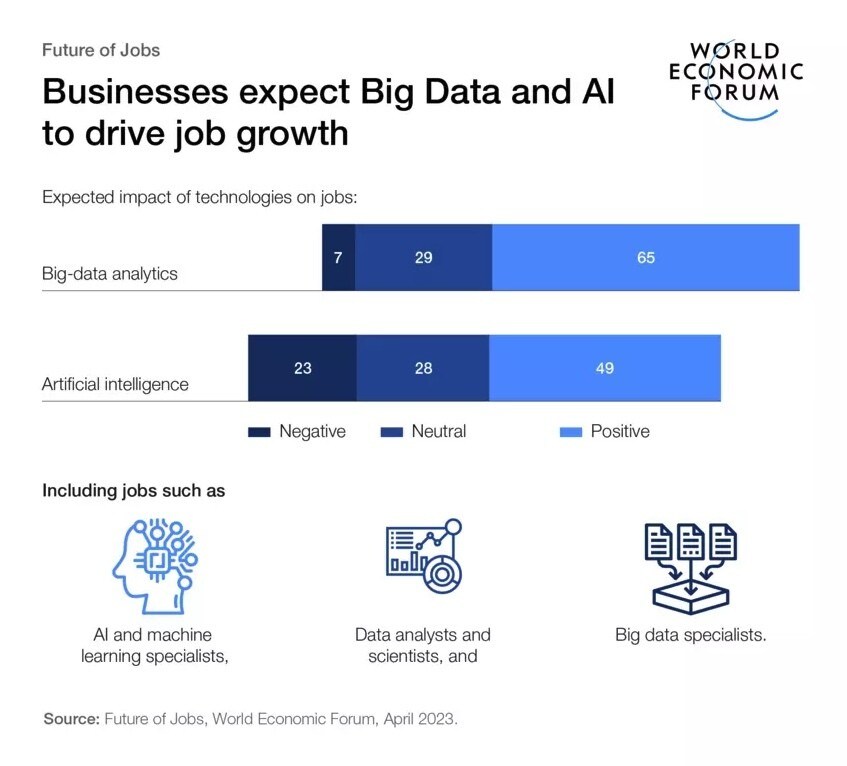
世界経済フォーラムの最新の『Future of Jobs Report』によると、雇用主はほぼ4分の1の仕事がテクノロジーの影響を受けると予測しています。また、職場で必要とされるスキルの44%が5年以内に変化し、認知能力、複雑な問題解決、テクノロジーリテラシーの重要性が高まっていくとされています。
これらの課題を深く掘り下げるため、世界経済フォーラムの週刊ポッドキャスト「Radio Davos」は全6回のシリーズを開始し、専門家や有識者と対話しながら、最大の課題の一部とそれへの対処法、またAIが私たちの生活や仕事の在り方を変える可能性について聞いています。
第1話では、ロッシと、香港科技大学のコンピュータ工学教授でAI研究センター所長のパスカル・フン(Pascale Fung)と対話します。以下は、その対話を編集したものです。
シリーズでは、AIに関する専門用語の解説も行います。本エピソードでは、世界経済フォーラムのAI・データ・メタバース部門責任者キャシー・リーが「大規模言語モデル」(LLM)を次のように定義します:
大規模言語モデルAIとは何ですか?
キャシー・リー:簡単に言えば、大規模言語モデルとは、人間のような言語を理解し生成できる賢いコンピュータプログラムです。ディープラーニングと呼ばれる人工知能の一種を用いて動作し、書籍、記事、ウェブサイトなどの膨大なテキストデータで訓練され、単語や文の間のパターンや関係性を理解して学習します。
訓練中、モデルはテキストデータを分析し、文中の前に来た単語に基づいて次の単語を予測しようとします。
言語モデルとやり取りする際、あなたは a にプロンプトや質問を与えます。「モニター」は学習した知識を使い、あなたが伝えようとしている文脈に当てはまる、最も可能性の高い単語や文を予測することで応答を生成します。
小規模言語モデルと大規模言語モデルの間には明らかに違いがあり、その閾値は実際には予測できないことがあります。しかし、これらの科学者は、ある閾値を超えると予測可能性の能力が指数関数的に跳ね上がるのを観察しており、それと同時に、これまで見たことがなく、以前は予測できなかった驚くべき創発的特性も確認しています。
会話型AIとは何ですか?
パスカル・フン:技術的に言えば、会話型AIシステムには2種類あります。基本的に、それはユーザー(人間のユーザー)と機械との対話です。
1つ目は、オープンドメインのチャットボットです。通常、どんな話題についても話すことができ、それゆえオープンドメインと呼ばれ、望む限り何についても会話を続けることができます。
もう1つの会話型AIシステムは、タスク指向型対話システムと呼ばれます。バーチャルアシスタント、スマートフォンのアシスタント、コールセンターのバーチャルアシスタント――これらはすべて、ユーザーの問い合わせに答えたり、タスクを達成したりするための対話システムや会話型AIシステムです。
AIにおけるこれらの大きな進歩の背景には何があるのでしょうか?
パスカル・フン:生成AIはしばらく前から存在しています。深層学習やニューラルネットワークよりも前からあるのです。しかし、最近の生成AIモデルは、学習データ量が膨大で、パラメータ数も非常に大きいため、以前の世代よりもはるかに強力です。
そして、これらの生成AIモデル、特に大規模言語モデルは、会話型AIシステムを構築するための基盤モデルとして使われています。
ChatGPTは会話型AIシステムだという誤解がよくあります。技術的には、そうではありません。ChatGPTは、私たちが基盤モデルと呼ぶものです。つまり、多数のタスクを実行できる大規模言語モデルです。そこにチャットインターフェースがあります。これは、チャットを通じて基盤となる大規模言語モデルとやり取りするためのユーザーインターフェースのようなものです。
したがって、ChatGPTは、会話型AIシステムを含むがそれに限らない、他のシステムを構築するために使用できます。
フランチェスカ・ロッシ:大きな変化とは感じていません。数十年にわたる進化を見てきたのです。
しかし、私のAIの経験と比べて今が違うのは、これらの研究成果が、非常にシンプルなインターフェースを通じて、誰にでも利用可能になっていることです。
人々は、オンライン生活におけるほぼすべての行動で、すでにAIを使っていました。しかし、それはオンラインで使っているすべてのアプリケーションの中に、ある意味隠れていたため、人々はそれに気づいていませんでした。
今後、どのようなアプリケーションに期待していますか?
パスカル・フン:生成AIを活用したり制御したりできる解決策が見つかることを期待しています。
今日、これらの大規模言語モデルは、いわば強力な野生の獣のようなものですよね?そうした獣を飼いならし、人類の利益のために使うためのアルゴリズムや手法が必要です。
長期的には、たとえば医療分野など、より有益なAIが実現することを願っています。高齢者のための医療、高度な医療へのアクセスがない恵まれない人々のための医療です。AI技術によって、こうした医療を民主化することができます。
現在、ここからそこに至る道のりは不透明です。1年以内に到達できるかもしれません。あるいは、そこに至るためには別のパラダイムシフトが必要かもしれません。しかし、それこそが生成AIのこの分野の魅力です。これらのモデルに取り組む中で、私たちはほぼ科学的発見をしている最中であり、日々どのように活用するか、どのように共に働くかという新しい方法を学んでいるのです。

人々はなぜそれを懸念しているのですか?
フランチェスカ・ロッシ:前の世代のAIにも問題はありました。偏り、説明可能性、透明性、頑健性、プライバシーなどの問題については、私たちはすべて熟知していました。しかし現在もこれらの問題は残っており、さらに、コンテンツを生成する能力に関連する新たな問題もあります。
例えば、誤情報の拡散の可能性、著作権の問題、プライバシーに関連する問題などです。
誤用が起こりうることも事実です。プロンプトは何でもあり得るため、大規模言語モデルには、適切に応答する仕組みを組み込まなければなりません。
今後は、大規模言語モデルを構築した後のフィルターではなく、モデルの構築そのものに組み込まれる、より効果的な手法を見つける必要があると考えています。
パスカル・フン:意図しない害も大いに気がかりです。善意から、患者が様々な病気の治療法を見つける手助けとなるシステムを構築しようとしている人々がいます。AIに基づくWebMDのようなものです。そして、こうしたシステムが人々の健康情報へのアクセスを助けると考えています。しかし、これらの生成AIシステムが与える回答の中には誤ったものもあることを、彼らは知らないのです。
この分野には今非常に多くの投資が集まっており、生成AIとChatGPTだけを使って立ち上がる何千ものスタートアップがあります。そのため、多くの人々がChatGPTの限界を理解せずに、ある機能を果たすと主張しながら実際には別のことをしている、意図した目的とは異なるアプリケーションを構築してしまうのではないかと懸念しています。
AIの開発が速すぎるリスクはありますか?
パスカル・フン:そのリスクはすでに存在しています。人々が生成AIを、意図されていない方法で使っているのを、すでに目にしています。
上流の研究で進展が見られ、AIの害を軽減する方法の開発も含め、大変心強く感じています。
私が懸念しているのは、その影響を100%理解していないシステムを展開しているため、展開が速すぎることです。展開するAIシステムについて、利用するすべての人に細部まで説明する必要は必ずしもありませんが、システムを世に出す前に、害を軽減できるという確信を持つ必要があります。
フランチェスカ・ロッシ:AIモデルの構築、リリース、展開という、バリューチェーンの異なる段階を区別すべきだと考えます。
研究開発を促進し、さらにスピードアップさせたいと考えています。なぜなら、そこは課題をどう軽減すべきかを理解するのに役立つ分野だからです。
もちろん、展開や利用といったバリューチェーンの後段については慎重になる必要があります。だからこそ、政策や規制は、初期段階ではなく、そのバリューチェーンのその部分でより多く作用すべきだと考えています。
AIのグローバルまたは地域的なガバナンスの現状はどうなっていますか?
フランチェスカ・ロッシ:最も包括的な法制化の議論は、現在欧州で行われている欧州AI法案の提案をめぐるものだと考えています。まだ草案の段階で、修正案も多数ありますが、近いうちに欧州議会で承認される見込みです。
その規制の好ましい点は、リスクベースであることです。リスクは、AIが適用されるシナリオに関連付けられています。規制には「高リスクの用途」のリストがあり、たとえば人事への応用として、誰を採用するか、誰を昇進させるかなどを決定するものが含まれます。それが高リスクの応用分野の1つです。
現在、この規制に生成AIや大規模言語モデルに関する内容も含めるにはどうすべきかについて、多くの議論が行われています。
私の望みは、リスクベースの枠組みの焦点を、応用分野からテクノロジーそのものへと移すことにはならないことです。なぜなら、どこに適用されてもこれらのモデルはリスクがあるという議論もあるからです。
それは大きな誤りだと思います。
AIに関連するリスクの一部を軽減するために、他にどのような方法がありますか?
パスカル・フン:リスクの軽減は、多様な利害関係者が関わり、多国間で取り組むべき仕事であり、私たちはシステムを構築する人々についてあまり議論していません。
まず、私たちが行動規範を遵守することから始まり、研究エンジニアもこの行動規範を遵守しなければなりません。
同時に、人間の価値観に整合するようアルゴリズムを設計する必要があります。

すべてのポッドキャストはwef.ch/podcastsでご覧いただけます:




