汎用知能
AIは特定のタスクをこなす能力をかなり高めてきたが、人間や動物と同じように世界を理解するための汎用知能を身につけるには、まだ長い道のりがある。
汎用知能の重要な要素の一つは、抽象的な推論力だ。これは、「今ここ」にとらわれず、より繊細なパターンや関係性を見いだし、複雑な思考を行う能力を指す。水曜日の11日、人工知能を専門とするGoogle傘下のDeepMindの研究者たちは、さまざまなAIの抽象的推論能力を測定する試みを詳述した論文を発表した。その測定には、人間の能力を測る際に使われるのと同じテストが用いられた。
人間のIQ
人間の抽象的推論力は、比較的単純な視覚式IQテストで測定する。よく知られたテストの一つ、レーヴン漸進的マトリックスでは、複数の画像が並ぶ列がいくつか示され、最後の列では最後の画像が欠けている。受験者は、完成した列のパターンをもとに、次に来るべき画像を選ぶ。
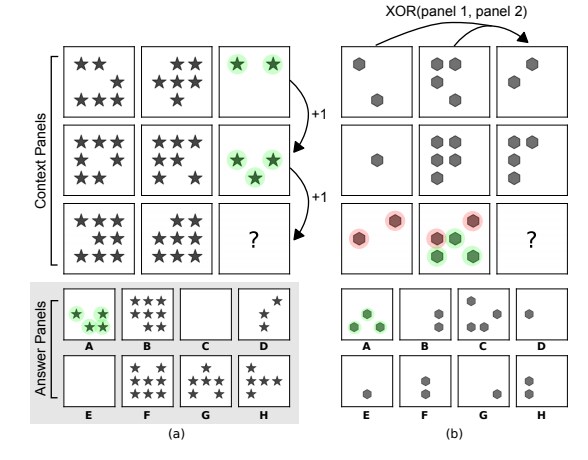
このテストでは、画像のどこに注目すべきかを受験者に明示しない。変化の規則は、各画像に含まれる物体の数や色、配置に関係しているのかもしれない。抽象的に推論する力を使って、自分で規則を見つける必要がある。
このテストをAIに適用するため、DeepMindの研究者たちは独自のマトリックス問題を生成できるプログラムを作成した。そして、さまざまなAIシステムに、これらの問題を解く訓練を行った。
最後に、研究者たちはシステムをテストした。訓練用データと同じ抽象的要素を含む問題を使う場合もあった。たとえば、各画像の図形の数を考慮する必要がある問題で、AIを訓練し、テストするというものだ。一方、訓練用データとは異なる抽象的要素を取り入れた問題をテストに使う場合もあった。たとえば、AIに図形の数を考慮する問題を訓練させた後、正解を見つけるために図形の位置を考慮する必要がある問題でテストする、といった具合だ。
次回に期待
テストの結果は芳しくなかった。訓練問題とテスト問題が同じ抽象的要素に焦点を当てた場合、システムの成績はまずまずで、問題の75%に正解した。しかし、テスト用データが訓練用データと異なると、AIの成績は非常に悪かった。違いがわずかな場合でも同様だった(たとえば、暗い色の物体が描かれたマトリックスで訓練し、明るい色の物体が描かれたマトリックスでテストした場合)。
結局のところ、チームが開発したAI向けIQテストは、今日最先端とされるAIでさえ、解くよう訓練されていない問題には対応できないことを示している。つまり、汎用AIの実現にはまだ長い道のりがありそうだ。それでも、進歩を測るための分かりやすい方法ができた。




