私はほぼ10年にわたり誇りを持って同時通訳者として働いてきましたが、確かに華やかな仕事ではないことは認めます。私たちは会議室の片隅の小さなブースに身を潜め、声をひそめて話す、世界経済における多言語を操る目立たない存在です。
ただし、ロボットに私たちの仕事の功績を奪わせないでください。すると、私たちは騒がしくなります。
最近、上海の通訳者が、国際会議で「AIを活用した翻訳」という誤解を招く宣伝に抗議してソーシャルメディアに投稿したことで、不満の声が大きな叫びへと変わりました。実際には、その翻訳は人間の通訳者の仕事を音声からテキストに変換したものにすぎませんでした。その投稿は中国のソーシャルメディアで瞬く間に拡散し、誤ったラベルが付けられた技術の提供元であり、中国を代表するAI・自然言語処理(NLP)企業の一つであるiFlyTek(科大訊飛)をめぐるスキャンダルへと発展しました。
この反応は、この分野において機械が人間を凌駕していることが既に当然視されていることを明らかにしました。今日においても通訳には人間の専門家による実質的な知的労働が必要だという事実に、人々は本当に驚いているようです。
Google翻訳やSkype翻訳は、何年も前にこの問題を解決したのではないでしょうか。あるいは、いずれかの十数種 のウェアラブル 翻訳機器が市場に出回っており、自称する「次のバベルフィッシュ」になるとのことですか?
AIは人間より一貫して優れており、自動車の運転、がんの診断、フリースロー、そして農作物の収穫量の予測(チェスはもちろん、チェス、囲碁、ポーカー、そしてジェパディを含みます)。しかし、翻訳と通訳に関しては、地球上で最も高度な技術であっても、依然として人間の脳が圧倒的に優れています。
なぜでしょうか。理由は3つあります。
1. 言語は主観的である
人工知能は通常、客観的な現実に根差したタスクで優れた力を発揮します。データセットの中から捉えがたい信号パターンを特定する場合でも、複雑な道路状況を走行する場合でも、機械は意思決定を支配する明確な数学的または物理的規則に直面したときに最もよく機能します。
対照的に、自然言語は、人間同士がコミュニケーションをとるために人間の集団が生み出した主観的な構築物です。文法や活用などの規則的な振る舞いを示すことも多いのですが、それらの規則は客観的な現実ではなく慣習にのみ基づいており、絶えず変化し続けています。
人間は腫瘍の認識や信用リスクの判断において先行性を失ったかもしれませんが、自然言語において何が「自然」であるか、そうでないかについては、依然として最終的な権威を持っており、今後も持ち続けるかもしれません。この権威は、機械翻訳アルゴリズムを評価する際に選ばれる指標に反映されています。BLEU(bilingual evaluation understudy、バイリンガル評価の代替指標)は、人間の専門家による翻訳との類似度に基づいて候補翻訳を採点します。「機械翻訳は専門家による人間の翻訳に近いほど優れている」と、この枠組みの考案者たちは認めています。
人間の翻訳は基準を設定するだけでなく、必然的に基準そのものなのです。
2. ビッグデータにはユーモアのセンスがない
翻訳者に聞けば誰もが、ジョーク、言葉遊び、皮肉なほのめかし(そして微妙な文化的言及)が言語の壁を越える際に最も難しい要素の一つだと言うでしょう。しかし、それらがなければ表現の質は大きく低下します。通訳者の立場から見ると、声の調子やボディランゲージも話者の意図を直接伝えるものであり、正確に分析し、翻訳先の言語でも伝えなければなりません。
これは人間にとっても難しいことですが、機械には現時点では不可能です。
統計的なフレーズベースの機械翻訳からニューラルネットワークへの移行は、全体的な品質の大幅な向上をもたらしました。しかし、ニューラル機械翻訳は前身のモデルよりもさらに大量の学習データに依存しています。利用可能な最大の二言語データセットは政府文書や宗教文書の公式翻訳であるため、これらのアルゴリズムはユーモア、言葉遊び、非言語的表現にほとんど触れていません。
最も厄介なのは、ニューラル機械翻訳はしばしば自らの誤りを認めないことです。むしろ、準備不足の小学生のように、それらを何とか取り繕おうとします。その例としてGoogle翻訳が聖書の預言を提供し始めた際、ガラクタの入力と引き換えに、専門家はその誤りを、ニューラルネットワークが正確さよりも流暢さを優先することに起因すると分析しました。
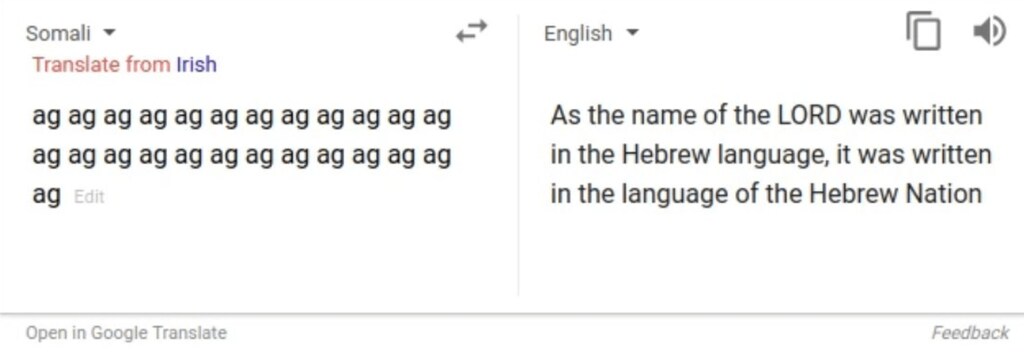
これらの「偽陽性」は、ぎこちなく目立つ誤りよりもはるかに厄介です。翻訳先の言語の聴衆は誤りが発生したことにすら気づかず、逸脱した翻訳の奇抜さを原文そのものに帰してしまうかもしれないからです。
3. 聞け、ボットたちよ
上記の課題だけでも、静的なテキストに対して機械翻訳を行うことは十分に困難です。コンピュータにライブの話し言葉を同時通訳させることは、さらにいくつもの複雑さを加えます。中でも最も明白なのは、自動音声認識(ASR)です。
はい、SiriやAlexaなどは、近頃かなり有能な会話相手になっているようです。しかし、ロボットとの機知に富んだやり取りは、通常、限られた文脈と条件、すなわち管理された環境で有限の語彙を用いる短い指示型のやり取りに限定されています。一方、ほとんどのライブの会議やビジネスの議論では、自発的で途切れがなく、文脈への依存度が高い発話が用いられます。こうした特徴は、多くのASRプログラムの誤り率を大きく押し上げます。
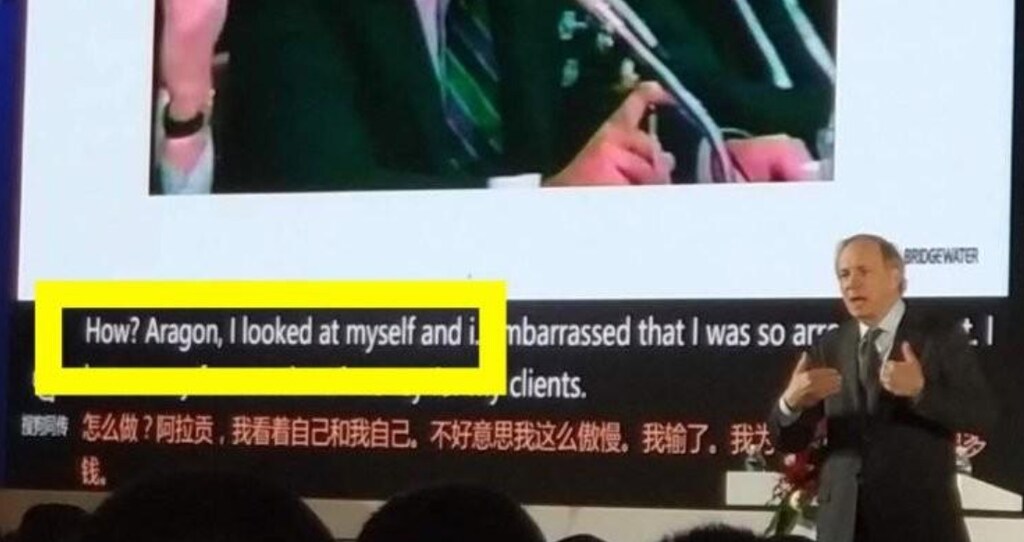
笑えるものも、屈辱的なものも、例は数多くあります。今年初め北京で講演したヘッジファンドの第一人者、レイ・ダリオは、若いトレーダーだった頃の予測の誤りを振り返りました。
「なんて傲慢だったのだろう!」と彼は会場に向かって声を張り上げました。「どうしてあんなに傲慢になれたのか?」
リアルタイムの字幕プログラムは、彼の修辞的な表現を果敢に再現しようと奮闘しました。
「どうして?」と字幕は尋ねました。「アラゴン、私は自分自身を見て、そして私は」。
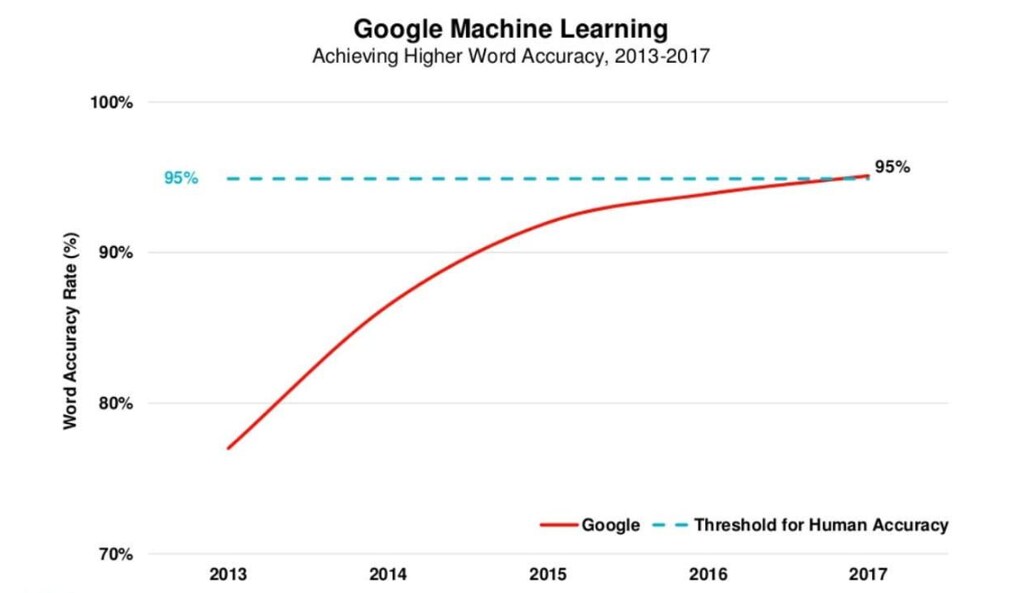
最近の進歩は、この分野で有望であり、多くの専門家は、ASRソフトウェアの単語誤り率が近い将来、人間の文字起こし担当者と同等の水準に達すると予測しています。ただし、単語誤りがすべて同じというわけではありません。「alright」を「all right」に誤変換することは取るに足らないミスかもしれませんが、「today」を「Tuesday」と混同すると、おそらく大きな混乱を招くでしょう。単語誤りが少なくても、機械は依然として、話者の意図した意味を誤って伝える意味的な誤りを、人間よりもはるかに犯しやすいのです。
人間ではなく、まだロボットでもない
人間は長い間、動物に対して、互いに対して、そして最近では機械に対して、自分たちが優れているという認識を振り返ることを趣味としてきました。確かにそれは暗い趣味であり、避けられない愚かなものでもあります。
コンピュータが人間のように自然言語を操る日が来ることを、私は疑っていません。また、いつの日か、通訳者や翻訳者が、コピーライター、編集者、ラジオのホストなど言語産業の他の専門家とともに、ロボットの標的になるかもしれないことも疑っていません。
しかし、その日は多くの人が考えるよりもずっと先のことです。言語の仕事は、常に一部が芸術で一部が科学であり、初期段階のこうしたAIに対して驚くほど持ちこたえられるものです。
他の多くの産業と同様に、私たち言語の専門家は、AI/NLP技術を活用して、労働の効率、品質、コスト競争力を高めることに注力すべきです。コンピュータ支援翻訳ツールは既にテキスト翻訳者の間で広く使われており、多くの人がこの提案に反発する一方で、同時通訳者も音声認識と翻訳メモリ技術を組み合わせることで恩恵を受けられることは間違いないでしょう。少なくとも当面の間、これらのツールは人間の成果の代替ではなく、補完として機能するでしょう。
そして、通訳ブースに人間がいる限り、彼らにふさわしい評価を与えるだけの礼儀を持ちましょう。




