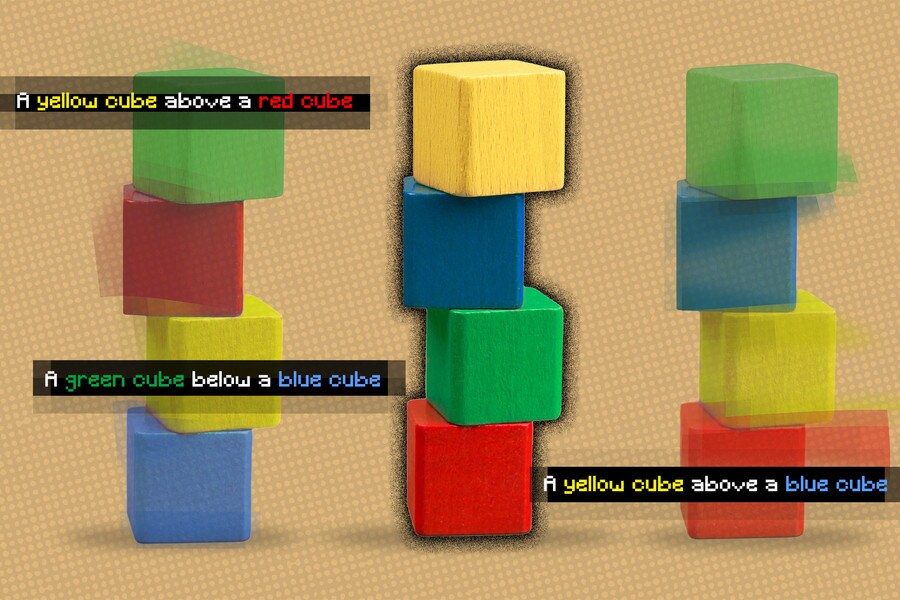
MITの研究者らは、場面内の物体間にある根本的な関係を理解するモデルを開発した。
このモデルは、個々の関係を一つずつ表現し、その表現を組み合わせて場面全体を描写する。
これにより、場面に複数の物体が含まれ、それらが互いに異なる関係で配置されている場合でも、テキストによる説明からより正確な画像を生成できる。
人間が場面を見るとき、物体とそれらの間の関係を認識する。机の上には、スマートフォンの左側にノートパソコンがあり、そのスマートフォンの前にコンピューターモニターが置かれているかもしれない。
多くのディープラーニングモデルは、個々の物体間に複雑に絡み合った関係を理解できないため、このように世界を捉えるのが苦手だ。こうした関係についての知識がなければ、キッチンで人を手助けするよう設計されたロボットは、「コンロの左側にあるへらを取り、まな板の上に置いて」という指示に従うのが難しいだろう。
この問題の解決を目指し、MITの研究者らは、場面内の物体間にある根本的な関係を理解するモデルを開発した。このモデルは、個々の関係を一つずつ表現し、その表現を組み合わせて場面全体を描写する。これにより、場面に複数の物体が含まれ、それらが互いに異なる関係で配置されている場合でも、テキストによる説明からより正確な画像を生成できる。
この研究は、倉庫で品物を積み上げたり、家電製品を組み立てたりするような、産業用ロボットが複雑で複数段階にわたる操作を行う場面に応用できる可能性がある。また、機械が人間のように環境から学び、環境と関わることを可能にするうえで、この分野を一歩前進させるものでもある。
「テーブルを見たとき、XYZ座標に物体がある、とは言いません。私たちの心はそのようには働きません。場面を理解するとき、私たちは物体間の関係に基づいて理解しています。物体間の関係を理解できるシステムを構築すれば、そのシステムを使って周囲の環境をより効果的に操作し、変えられると考えています」と、コンピューター科学・人工知能研究所(CSAIL)の博士課程学生で、論文の共同筆頭著者であるイールン・ドゥ氏は述べる。
ドゥ氏は、CSAILの博士課程学生である共同筆頭著者のシュアン・リー氏、イリノイ大学アーバナ・シャンペーン校の大学院生であるナン・リウ氏、さらに、脳・認知科学科の計算認知科学教授でCSAILのメンバーでもあるジョシュア・B・テネンバウム氏、および電気工学・コンピューター科学のデルタ・エレクトロニクス教授でCSAILのメンバーでもある上席著者のアントニオ・トラルバ氏とともに論文を執筆した。この研究は12月に開催される神経情報処理システム会議で発表される予定だ。
一つずつ関係を捉える
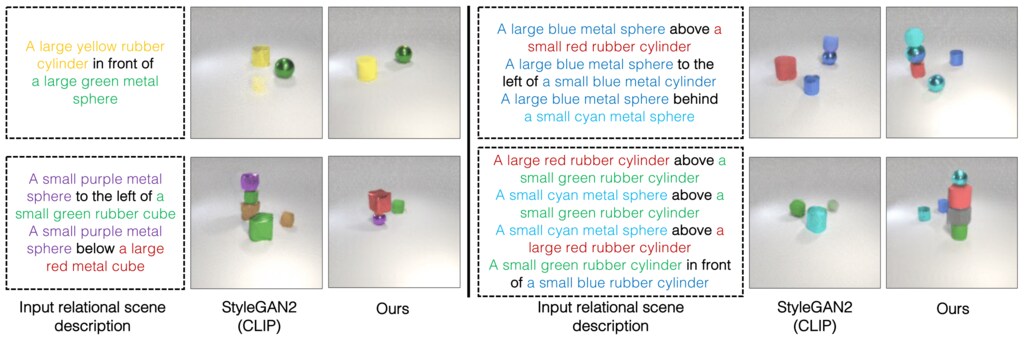
研究者らが開発した枠組みは、「青いスツールの左側に木製のテーブル。青いスツールの右側に赤いソファ。」のように、物体とその関係を記したテキストに基づいて場面の画像を生成できる。
このシステムは、これらの文を個々の関係を表す二つの短い部分(「青いスツールの左側に木製のテーブル」と「青いスツールの右側に赤いソファ」)に分解し、それぞれを別々にモデル化する。次に、それらの部分を最適化プロセスで組み合わせ、場面の画像を生成する。
研究者らは、場面の説明に含まれる個々の物体間の関係を表現するため、「エネルギーベースモデル」と呼ばれる機械学習手法を用いた。この手法では、関係を記した説明ごとに一つのエネルギーベースモデルで符号化し、それらを組み合わせて、すべての物体と関係を推定できる。
リー氏によると、文を関係ごとの短い部分に分解することで、システムはそれらをさまざまな方法で再結合できるため、これまで見たことのない場面の説明にも適応しやすくなる。
「ほかのシステムは、すべての関係を一体として扱い、説明文から一度に画像を生成します。しかし、関係がより多く含まれる説明など、分布外の説明ではそうした手法はうまくいきません。モデルは関係が増えた画像を一度に生成できるよう、本当に適応することができないからです。一方、個別の小さなモデルを組み合わせることで、より多くの関係をモデル化し、新しい組み合わせにも適応できます」とドゥ氏は述べる。
このシステムは逆方向にも機能する。画像を与えると、場面内の物体間の関係に一致するテキスト説明を見つけられる。さらに、このモデルを使って場面内の物体を並べ替え、新しい説明に合うよう画像を編集することもできる。
複雑な場面を理解する
研究者らは、テキストによる説明を与えられ、それに対応する物体と関係を示す画像の生成を課された他のディープラーニング手法と、自分たちのモデルを比較した。いずれの場合も、研究者らのモデルはベースラインを上回った。
また、生成された画像が元の場面の説明と一致しているかを人々に評価してもらった。説明に三つの関係が含まれる最も複雑な例では、参加者の91%が新しいモデルのほうが優れていると判断した。
「興味深い発見の一つは、私たちのモデルでは、関係の説明が一つの文から二つ、三つ、さらには四つへと増えても、ほかの手法が失敗する一方で、説明に正しく合った画像を生成し続けられることです」とドゥ氏は述べる。
研究者らは、モデルにこれまで見たことのない場面の画像と、それぞれの画像について複数の異なるテキスト説明を提示した。モデルは、画像内の物体間の関係に最もよく合う説明を正しく特定できた。
また、同じ画像を異なる方法で説明する二つの関係記述をシステムに与えたところ、モデルはその説明が同等であると理解できた。
研究者らは、特にこれまで遭遇したことのない説明に対してもモデルが頑健に対応できることに感銘を受けた。
「これは非常に有望です。人間の働き方に近いからです。人間はわずかな例しか見ないこともありますが、その少数の例から有用な情報を取り出し、それらを組み合わせて無限の組み合わせを生み出せます。私たちのモデルにも、少ないデータから学習しながら、より複雑な場面や画像生成へ一般化できるという特性があります」とリー氏は述べる。
こうした初期の結果は心強いものだが、研究者らは、背景が雑然としていたり、物体同士が重なっていたりする、より複雑な実世界の画像でモデルがどのように機能するかを確認したいと考えている。
また、将来的にはこのモデルをロボットシステムに組み込み、ロボットが動画から物体間の関係を推定し、その知識を使って現実世界の物体を操作できるようにすることにも関心を寄せている。
「私たちを取り巻く世界の構成的な性質に対処できる視覚表現を開発することは、コンピュータービジョンにおける主要な未解決課題の一つです。この論文は、画像に描かれた物体間の複数の関係を明示的にモデル化するエネルギーベースモデルを提案し、この課題を大きく前進させています。結果は本当に印象的です」と、今回の研究には参加していない、チェコ工科大学のチェコ情報学・ロボティクス・サイバネティクス研究所の特別研究員ヨゼフ・シヴィツ氏は述べる。
この研究は、レイセオン BBN テクノロジーズ社、三菱電機リサーチラボ、米国国立科学財団、米国海軍研究局、およびIBMトーマス・J・ワトソン研究センターの一部支援を受けている。




