人工知能は転換点を迎え、新たな職種、すなわちアーティストや知識労働者に影響を及ぼそうとしている。
これまでの技術革新は一部の職種を消滅させる一方、人々が新たなスキルを身につけるきっかけにもなってきた。OpenAIのChatGPTも同様のことをもたらす可能性がある。
現在のAIには限界も見られるが、望ましい結果を生み出すようAIを微調整する仕事が生まれる可能性がある。
ここではAI研究者5人が、この新たな技術がクリエイティブ産業で働く人々にどのような影響を及ぼす可能性があるかを論じる。
蒸気機関や電気から、コンピューターやインターネットに至るまで、技術の進歩は常に労働市場を揺るがし、一部の仕事を押し出す一方で新たな仕事を生み出してきた。人工知能という呼び名は、ある意味で誤解を招く。最も高度なコンピューターシステムでさえ、実際には何も理解していない。それでも、この技術は転換点を迎え、新たな職種、すなわちアーティストや知識労働者に影響を及ぼそうとしている。
具体的には、大量のテキストで学習するAIシステムである大規模言語モデルの登場により、コンピューターは人間らしい文章を生成し、描写的なフレーズからリアルな画像を作り出せるようになった。The Conversationは、これらのモデルがアーティストや知識労働者にどのような影響を及ぼす可能性が高いか、人工知能の研究者5人に話を聞いた。専門家らが指摘したように、この技術はまだ完璧にはほど遠く、誤情報から盗用まで、人間の労働者に影響するさまざまな問題を引き起こしている。

誰もが創造性を発揮できる一方で、スキルは失われるのか?
テネシー大学副学長補佐、リン・パーカー
大規模言語モデルによって、創造的な活動や知識労働が誰にでも可能になりつつある。インターネットに接続できる人なら誰でも、次のようなツールを使える。ChatGPTやDALL-E 2を使って自分を表現したり、たとえばテキストの要約を作成したりして、膨大な情報を理解したりできる。
とりわけ注目されるのは、大規模言語モデルが示す、人間のような専門知識の深さだ。初心者でもわずか数分で、ビジネスプレゼンテーション用のイラストを作成し、マーケティングの提案文を作成し、書けない状態を乗り越えるためのアイデアを得たり、新たなコンピューターコードを生成したりできる。いずれも、一般に人間の専門家に期待される水準の品質で、指定された機能を実現する。
もちろん、こうした新しいAIツールは人の心を読めない。人間の利用者が求める結果を得るには、テキストで指示を入力するという、これまでとは異なる、より簡単な形の創造性が必要になる。指示を繰り返し調整するのは、人間とAIの協働の一例だ。指示を書く人が結果に満足するまで、AIシステムは出力を段階的に生成する。たとえば、最近のコロラド州祭のデジタルアーティスト部門のコンテストで、AIツールを使った人間の優勝者は創造性を発揮した。ただし、それは筆や色彩、質感を見る目を必要とする種類の創造性ではなかった。
創造的な活動や知識労働の世界を誰にでも開くことには大きな利点がある一方、こうした新しいAIツールには欠点もある。第一に、今後も重要であり続ける人間のスキル、とりわけ文章を書くスキルの喪失を加速させるおそれがある。教育機関は方針を策定し、徹底する必要がある。大規模言語モデルの許容される使用方法を定め、公平な取り組みと望ましい学習成果を確保するためだ。
第二に、こうしたAIツールは知的財産の保護をめぐる疑問を提起する。人間の創作者は、建築物や他者の文章、音楽、絵画など、既存の作品から日常的に着想を得ている。しかし、大規模言語モデルが著作権保護対象またはオープンソースの学習データを適切かつ公正に利用しているかについては、未解決の問題が残る。現在も続く訴訟でこの問題が争われており、大規模言語モデルの将来の設計や利用に影響を及ぼす可能性がある。
社会がこうした新しいAIツールの影響に向き合うなか、世間は受け入れる用意があるようだ。チャットボットのChatGPTは急速に話題となり、画像生成ツールのDall-E miniなども同様だった。これは、創造性に大きな未開拓の可能性があり、創造的な活動や知識労働を誰もが利用できるようにすることが重要だと示している。
潜在的な不正確さ、偏り、盗用
コロラド大学ボルダー校コンピューターサイエンス准教授、ダニエル・アクーニャ
私はGitHub Copilotを日常的に使っている。これは人々のコーディングを支援するツールだ。また、ChatGPTや、AIが生成するテキストを作る同様のツールを何時間も試してきた。私の経験では、こうしたツールは、これまで思いつかなかったアイデアを探るのに役立つ。
モデルが私の指示を筋の通った文章やコードに変換する能力には感心している。自分の考えをより明確に表現する新しい方法を見つけたり、存在すら知らなかったソフトウェアパッケージを使って解決策を作ったりするのに役立つ。ツールが生成したものを見たら、その質を評価し、大幅に編集できる。全体として、創造的と見なされる水準を引き上げていると思う。
ただし、懸念もいくつかある。
問題の一つは、大小さまざまな不正確さだ。CopilotやChatGPTを使う際、考えが浅すぎないか、たとえば内容に乏しい文章や非効率なコードではないか、あるいは誤った類推や結論、動作しないコードなど、単純に間違った出力ではないかを常に確かめている。利用者がツールの出力を批判的に検討しなければ、潜在的に有害となる。
最近、Metaは科学分野の文章を生成する大規模言語モデルGalacticaを停止した。「事実」をでっち上げながら、非常に自信ありげな口調だったためだ。自信に満ちた口調の虚偽情報でインターネットを汚染しかねないことが懸念された。
もう一つの問題は偏りだ。言語モデルはデータに含まれる偏りを学習し、それを再現することがある。こうした偏りは、テキスト生成では見えにくいが、画像生成モデルでは非常に明白だ。ChatGPTを開発したOpenAIの研究者は、モデルが何に応答するかについて比較的慎重に対応してきたが、利用者は日常的にこうしたガードレールを回避する方法を見つけている。
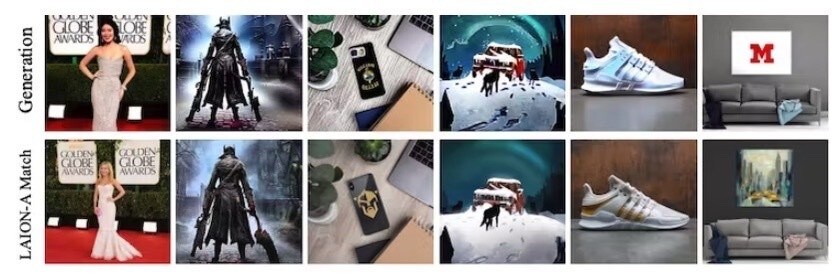
もう一つの問題は盗用だ。最近の研究では、画像生成ツールが他者の作品を盗用することが多いと示されている。ChatGPTでも同じことが起きているのだろうか。私たちには分からないと思う。ツールが学習データを言い換えている可能性がある。これは高度な形の盗用だ。私の研究室の研究によれば、テキストの盗用検出ツールは、言い換えの検出に関しては大きく後れを取っている。
こうしたツールは、その可能性を考えればまだ初期段階にある。現時点では、現在の限界に対処する方法があると考えている。たとえば、生成されたテキストを知識ベースと照合して事実確認を行い、大規模言語モデルから偏りを検出して取り除くための新しい手法を使い、より高度な盗用検出ツールで結果を調べることができる。
人間を超える時代にも、ニッチな仕事や「手作り」の仕事は残る
ミシガン大学コミュニティ情報学教授、トヤマ・ケンタロウ
私たち人間は、自分たちが特別な存在だと信じたがる。しかし科学と技術は、その確信が誤りだと繰り返し証明してきた。かつて人間だけが道具を使い、チームを作り、文化を伝えると考えられていたが、科学によって、他の動物もそれぞれこうしたことの すべてを行うことが分かっている。
一方、認知的な作業には人間の脳が必要だという主張も、技術によって次々と覆されてきた。最初の加算機は1623年に発明された。昨年は、コンピューターが生成した作品が芸術コンテストで優勝した。コンピューターが人間の知能に追いつき、上回る瞬間、すなわちシンギュラリティは目前に迫っていると考える。
機械が最も優れた人々より賢く、創造的になったとき、人間の知能や創造性はどのように評価されるのだろうか。おそらく、さまざまな段階があるだろう。コンピューターのほうがうまくできる場合でも、人間が行うことに価値を見いだす分野はある。IBMのディープ・ブルーが世界チャンピオンのガルリ・カスパロフを破ってから四半世紀が経つが、人間のチェスはそのドラマ性も含めて今もなくなっていない。
一方、人間のスキルが高くつき、余計なものに思える分野もある。イラストを例に挙げよう。たいていの読者は、雑誌記事に添えられた図版を人間とコンピューターのどちらが描いたかを気にしない。求めているのは、内容に合い、新鮮で、できれば楽しめるものだ。コンピューターが上手に描けるなら、クレジットにメアリー・チェンと書かれているか、システムXと書かれているかを読者は気にするだろうか。イラストレーターは気にするだろうが、読者は気づきさえしないかもしれない。
もちろん、この問題は白黒はっきり分けられるものではない。多くの分野は、人間のホモ・サピエンスが幸運なニッチを見つける一方で、仕事の大半をコンピューターが担うという混合型になるだろう。製造業を考えてみてほしい。今日、その多くはロボットが担っているが、機械を監督する人もおり、手作り製品の市場も残っている。
歴史を参考にすれば、AIの進歩によってさらに多くの仕事が消え、人間にしかできないスキルを持つクリエイティブ層は、人数が減る一方で豊かになり、創造的な技術を所有する人々は新たな超富裕層になることはほぼ確実だ。希望があるとすれば、まともな生計を立てられない人がさらに増えたとき、人々が格差の拡大を抑えるために政治的意思を結集するかもしれないことだ。
古い仕事は消え、新しい仕事が生まれる
フロリダ国際大学コンピューターサイエンス准教授、マーク・フィンレイソン
大規模言語モデルは、高度な系列補完マシンだ。単語の並びを与えると(「私は…を食べたい」)、続きとしてありそうな表現(「…リンゴ」)を返す。ChatGPTのように、記録的な数、すなわち数兆語のデータで学習した大規模言語モデルは、その補完がいかに現実的で、幅広く、柔軟で、文脈に応じているかによって、多くの人々、AI研究者を含む人々を驚かせてきた。
スキルを自動化する強力な新技術はどれもそうであるように、今回は、ある程度一般的ではあるものの筋の通った文章を生成する技術が、そのスキルを市場で提供する人々に影響を及ぼす。何が起きるかを考えるうえで、1980年代初頭にワープロソフトが導入された影響を思い起こすとよい。タイピストのような職種はほぼ完全になくなった。一方で、パソコンがあれば誰もが体裁の整った文書を簡単に作成できるようになり、生産性が広く向上した。
さらに、履歴書によく記載されるMS Officeのように、それまでは想像もされなかった新しい仕事やスキルが生まれた。高品質な文書制作の市場も残り、より高性能で、洗練され、専門性の高いものへと変わった。
大規模言語モデルにも、ほぼ確実に同じパターンが当てはまると思う。筋の通った一般的な文章を書いてもらうために、他の人に頼む必要はなくなるだろう。一方で、大規模言語モデルは新しい働き方を可能にし、これまで想像もされなかった新たな仕事も生み出す。
そのことを理解するために、大規模言語モデルが不得意とする点を3つ考えてみよう。第一に、望む出力を得られる指示を作るには、人間のかなりの工夫が必要になることがある。指示を少し変えただけで、出力が大きく変わることもある。
第二に、大規模言語モデルは、警告なしに不適切または意味不明な出力を生成することがある。
第三に、AI研究者に分かる限り、大規模言語モデルは抽象的で一般的な理解を持たない。何が真実か、何が正しいか、何が常識かを理解していないのだ。注目すべきことに、比較的簡単な計算もできない。そのため、出力が予期せず誤解を招くもの、偏ったもの、論理的に誤ったもの、あるいは単なる虚偽になりうる。
こうした欠点は、クリエイティブ職や知識労働者にとって機会となる。一般向けのコンテンツ制作であっても、人間のクリエイティブ職や知識労働者が判断し、機械に指示を出し、導き、取りまとめ、選別し、編集し、とりわけ出力を拡充することが、今後も必要になる。専門的で高度に技術的な言語の多くは、当面、機械には扱えないままだろう。また、特定の市場に向けた専門的な文章を生成するよう、社内の大規模言語モデルを微調整する事業など、新しい種類の仕事も生まれるだろう。
要するに、大規模言語モデルはクリエイティブ職や知識労働者に確実に変化をもたらすが、こうした強力な新ツールに適応し、仕事に取り入れる人には、今後も多くの価値ある機会がある。
技術革新は新たなスキルを生む
コロラド大学アンシュッツ医療キャンパス生物医学情報学教授、ケイシー・グリーン
技術は仕事のあり方を変える。知識労働も例外ではない。過去20年間、生物学と医学は、分子特性解析の急速な進歩によって変革してきた。たとえば、高速で低コストのDNAシーケンシングや、医療のデジタル化が進み、アプリ、遠隔医療、データ分析が広がった。
技術の進歩のなかには、他より大きな変化をもたらすものがある。ワールド・ワイド・ウェブが登場した初期、Yahooは人間のキュレーターを配置して、新たに登場するコンテンツを索引化した。ウェブ上のリンク構造に埋め込まれた情報を使って検索結果を優先表示するアルゴリズムの登場は、検索のあり方を根本から変え、今日の人々の情報収集方法を一変させた。
の公開はOpenAIのChatGPTが、もう一つの飛躍を示している。ChatGPTは、チャット向けに調整された最先端の大規模言語モデルを、非常に使いやすいインターフェースに組み込んでいる。人工知能が急速に進歩した10年分の成果を、人々が手軽に利用できるようにした。このツールは、ある程度使えるカバーレターを書き、利用者が指定した文体でよくある問題に対処する方法を案内することができる。
Googleの登場によってインターネットで情報を探すスキルが変わったのと同じように、言語モデルから最良の出力を得るために必要なスキルは、望む結果を生み出す指示や指示のテンプレートを作成することが中心となる。
カバーレターの例では、さまざまなプロンプトが考えられます。「仕事の応募用カバーレターを書いて」という指示では、「データ入力担当者の職に応募するためのカバーレターを書いて」という指示よりも、一般的な出力になります。ユーザーは、職務内容の説明や履歴書の一部を貼り付けたり、「細部への注意力を強調して」といった具体的な指示を加えたりして、さらに詳細なプロンプトを作成できます。
多くの技術革新と同様、広く利用できるAIモデルの時代には、人々の世界との関わり方が変わるでしょう。問われているのは、社会がこの機会を公平性の向上に生かすのか、それとも格差を深刻化させるのかということです。




