AIを活用した新世代の情報アクセスシステムが、従来のインターネット検索エンジンのあり方を一変させている。
これらのシステムは、大規模言語モデルを基盤としている。これは、ウィキペディアやPubMedの記事など、利用可能な大量のテキストを使ってパターンを学習する機械学習技術だ。
インターネット上の幅広く深い知識と組み合わせて、親しみやすく個人に合わせた回答を提供する一方、デメリットもあると情報科学者は警告する。
正確性や透明性に欠け、学習者の自立を損なう可能性もあるという。
検索エンジンが普及する前の主要な情報アクセスの形は、司書や分野・検索の専門家が関連情報を提供するものだった。対話的で、個人に合わせられ、透明性と信頼性があった。今日、検索エンジンは多くの人にとって情報にアクセスする主な手段だが、キーワードをいくつか入力し、仕組みの分からない関数で順位付けされた結果一覧を得るだけでは理想的とは言えない。
MicrosoftのBing/ChatGPT、Google/Bard、Meta/LLaMAなどを含む、人工知能を活用した新世代の情報アクセスシステムが、検索語を入力して結果を表示する従来の検索エンジンのあり方を一変させている。これらのシステムは、文章や段落を入力として受け取り、個人に合わせた自然言語の回答を生成できる。

一見すると、これは両方の良いところを兼ね備えているように思える。親しみやすく個人に合わせた回答と、インターネット上の幅広く深い知識の組み合わせだ。しかし、検索システムとレコメンドシステムを研究する研究者として言えば、少なくとも評価は一様ではない。
ChatGPTやBardのようなAIシステムは、大規模言語モデルを基盤としている。言語モデルとは、ウィキペディアやPubMedの記事など、利用可能な大量のテキストを使ってパターンを学習する機械学習技術だ。簡単に言えば、こうしたモデルは、単語の並びや語句を与えられたとき、次に来る可能性が高い単語を割り出す。その結果、文章や段落、さらにはページ全体を生成し、ユーザーの質問に対応できる。2023年3月14日、OpenAIはこの技術の次世代モデルGPT-4を発表した。GPT-4は、テキストと画像の両方を入力として扱える。またMicrosoftは、自社の対話型BingがGPT-4を基盤としていると発表した。
大量のテキストを使った学習やファインチューニングなど、機械学習に基づく手法のおかげで、この種の情報検索技術はかなり効果的に機能する。大規模言語モデルを基盤とするシステムは、情報に関する質問に応じて個人に合わせた回答を生成する。ChatGPTの結果は非常に印象的だと受け止められ、TikTokが同じ節目に達するまでにかかった期間の3分の1で、利用者数が1億人に達した。人々は答えを見つけるだけでなく、診断の生成、食事プランの作成、投資助言の作成にも利用している。
不透明さと「幻覚」
しかし、デメリットは数多くある。まず、大規模言語モデルの核心にあるものを考えてみよう。単語と、そこにあるとされる意味を結び付ける仕組みだ。これによって、知的な応答に見える出力が生まれることが多い。しかし、大規模言語モデルのシステムは、真に理解しているわけではなく、オウム返しに近い言葉を生成することが知られている。そのため、こうしたシステムの生成内容が賢そうに見えても、実際にはAIが適切な文脈で見つけた単語のパターンを反映しているにすぎない。
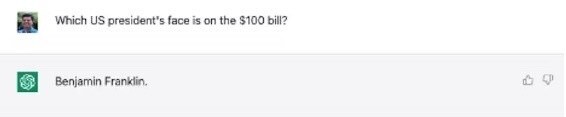
この限界により、大規模言語モデルのシステムは答えを作り上げたり、「幻覚」を起こしたりする傾向がある。また、質問の前提が誤っていることを理解できず、誤った問いにも答えてしまう。たとえば、100ドル紙幣に描かれている米国大統領は誰かと尋ねると、ChatGPTはベンジャミン・フランクリンと答える。フランクリンは大統領ではなかったことや、100ドル紙幣に米国大統領の肖像があるという前提自体が誤りであることに気付かない。
問題は、システムが間違えるのがたとえ10%だけでも、その10%がどれなのか分からないことだ。また、人々にはシステムの回答をすぐに検証する手段がない。システムには透明性がなく、どのデータで学習したのか、回答を導くためにどの情報源を使ったのか、回答をどのように生成したのかを明らかにしないからだ。
たとえば、ChatGPTに出典付きの技術報告書を書くよう頼むことができる。しかし、しばしば出典をでっち上げる。学術論文のタイトルだけでなく、著者名まで「幻覚」として作り上げるのだ。システムは回答の正確さも検証しない。そのため検証はユーザー任せとなり、ユーザーにはそれを行う意欲やスキルがなかったり、AIの回答を確認する必要性に気付かなかったりする可能性がある。
コンテンツとトラフィックの搾取
透明性の欠如はユーザーに害を及ぼしかねないだけでなく、システムが学習に使ったオリジナルコンテンツの著者、アーティスト、制作者にとっても不公正だ。システムは情報源を明かさず、十分なクレジットも示さないからだ。ほとんどの場合、制作者には報酬もクレジットも与えられず、同意する機会も与えられない。
これには経済的な側面もある。一般的な検索エンジンでは、検索結果に情報源へのリンクが表示される。それによって、ユーザーは回答を検証でき、情報源のクレジットも示されるだけでなく、それらのサイトへのトラフィックも生まれる。多くの情報源は、そのトラフィックを収益の頼りとしている。大規模言語モデルのシステムは直接回答を生成する一方で、参照元の情報源を示さないため、そうしたサイトの収益源は縮小する可能性が高いと私は考える。
学びとセレンディピティを奪う
最後に、この新しい情報アクセスの方法は、人々の力を弱め、学ぶ機会を奪う可能性もある。一般的な検索の過程では、ユーザーは情報ニーズに応えるさまざまな可能性を探ることができ、その結果、探しているものを見直すことも多い。また、どのような情報があり、さまざまな情報がどのようにつながって課題の達成に役立つのかを知る機会も得られる。さらに、偶然の出会いやセレンディピティも生まれる。
こうしたことは検索の非常に重要な側面だ。しかし、情報源を示さず、ユーザーを検索の過程に導くことなく結果を出すシステムは、そうした可能性を奪ってしまう。
大規模言語モデルは、自然言語でやり取りし、個人に合わせた回答を生成し、一般のユーザーには見つけるのが難しいことも多い答えやパターンを発見できるようにする、情報アクセスの大きな前進だ。しかし、学習や回答の構築方法に起因する深刻な限界もある。回答は誤っていたり、有害だったり、偏っていたりする可能性がある。
他の情報アクセスシステムも同様の問題を抱えることがあるが、大規模言語モデルを使ったAIシステムには透明性も欠けている。さらに、その自然言語による回答は、知識のないユーザーにとって危険になりうる誤った信頼感や権威性への思い込みを助長するおそれがある。




