既存の人間の偏見は、あまりにも頻繁に人工知能に引き継がれています。
ここでは、5種類の偏りとその対処法を紹介します。
年齢、性別、階級にかかわらず、誰もが優れた医療、栄養のある食料、その他の基本的な人間のニーズにアクセスできる、公正で公平な世界を想像できるでしょうか。人工知能やデータサイエンスといったデータ駆動型技術は、それを実現できるのでしょうか。それとも、現実世界の結果をすでに左右している偏りが、やがてデジタル世界にも及んでしまうのでしょうか。
偏りとは、個人または集団に対する不公正を意味します。技術は中立ではなく、それを開発する人々の良し悪しをそのまま反映するため、既存の人間の偏見の多くは機械に引き継がれる可能性があります。世界中の企業組織において、偏りがどのように偏見、不公正、不平等につながりうるかを説明するため、人工知能の偏りが特定され、倫理的リスクが軽減された実例を2つ取り上げます。
2014年、Amazonのソフトウェアエンジニアチームは、求職者の履歴書を審査するプログラムを開発していました。残念ながら、2015年、そのシステムが技術職において女性を差別していることに同社は気づきました。こうした差別と公平性の問題があったため、Amazonの採用担当者はこのソフトウェアを候補者の評価に使用しませんでした。一方、2019年にはサンフランシスコの議員が、顔認識技術の使用に反対する投票を行い、濃い肌の人や女性に使用した場合に誤りが生じやすいと判断しました。
米国国立標準技術研究所(NIST)は、東芝、インテル、マイクロソフトを含む189の組織に所属する約100の開発者による顔認識アルゴリズムを評価する調査を実施しました。その衝撃的な結論について、執筆者の一人であるパトリック・グローサーは次のように述べています。:「アルゴリズム間で一般化した記述を行うことは通常不適切ですが、調査したアルゴリズムの大半において、人口統計学的な差異が存在することを示す実証的証拠を確認しました。」
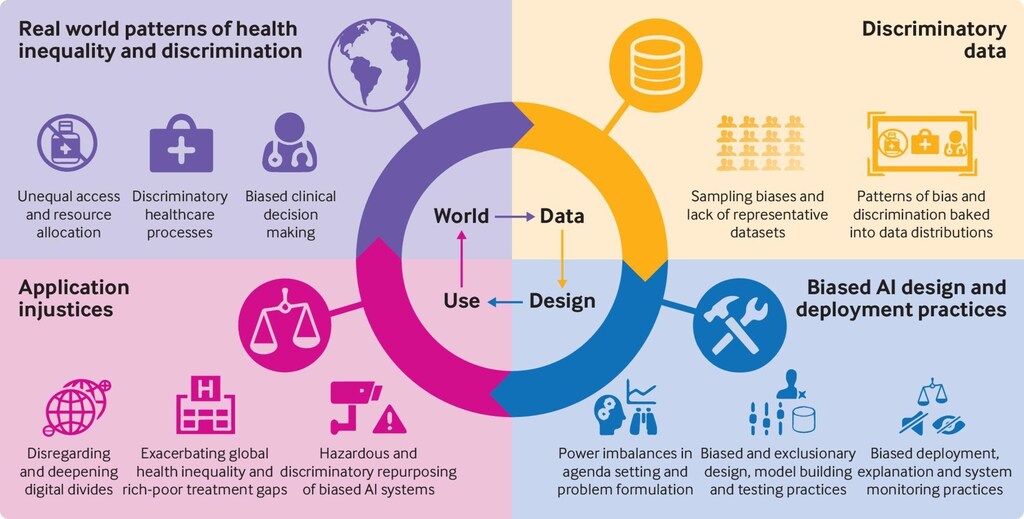
人工知能の利用における公平性と無差別のリスクの発生源をいくつか挙げると、暗黙の偏り、標本抽出の偏り、時間的な偏り、訓練データへの過適合、エッジケースと外れ値などがあります。
暗黙の偏り
暗黙の偏りとは、偏りを持つ本人が意識していない、個人または集団に対する差別や偏見を指します。本人が偏りに気づいていないため危険です。性別、人種、障害、性的指向、階級など、どのような理由に基づくものであってもです。
標本抽出の偏り
これは、母集団から無作為に選ばれたデータが母集団の分布を反映していないという統計上の問題です。標本データが、集団の特定の部分集合に偏っている可能性があります。
時間的な偏り
これは、時間に関する認識に基づくものです。現時点ではうまく機能する機械学習モデルを構築できても、モデル構築時に将来の変化を考慮しなかったために、将来には機能しなくなることがあります。
訓練データへの過適合
これは、AIモデルが訓練データセットから値を正確に予測できても、新しいデータを正確に予測できない場合に起こります。モデルが訓練データセットに過度に従いすぎて、より大きな母集団に一般化できない状態です。
エッジケースと外れ値
これは、訓練データセットの範囲外にあるデータです。外れ値とは、データの正規分布から外れたデータ点です。誤りとノイズはエッジケースに分類されます。誤りとはデータセット内の欠損値または不正確な値であり、ノイズとは機械学習のプロセスに悪影響を及ぼすデータです。
公平性と無差別のリスクを特定する方法
分析手法
分析手法では、標本抽出の偏りや、訓練データにおける集団の不均等な代表性について、訓練データを綿密に評価する必要があります。データセットの出所と特性を調査することができます。データのバランスを確認してください。例えば、ある性別や人種が他方よりも多く代表されていないでしょうか。訓練に十分な大きさのデータ量があるでしょうか。無視されている集団はないでしょうか。
住宅ローンに関する最近の研究では、融資の承認または否認に用いられる予測モデルが少数派に対して正確ではないことが明らかになりました。シカゴ大学の研究者であるスコット・ネルソン氏とスタンフォード大学の経済学者であるローラ・ブラットナー氏は、多数派と少数派の集団の間で住宅ローン承認に差が生じる理由は、低所得層と少数派の集団の信用履歴に記録されているデータが少ないためであることを突き止めました。データに対する綿密な分析がなければ、偏りの原因は発見されず、不明のままとなります。
さまざまな環境でモデルを検証する
データを訓練した環境が、より広い母集団に適していない場合はどうでしょうか。モデルをさまざまな環境や文脈にさらし、新たな知見を得てください。モデルがより広範なシナリオに一般化できることを確認する必要があります。
医療ベースのリスク予測アルゴリズムのレビューでは、米国市民約2億人に用いられたアルゴリズムに人種的な偏りがあることが示されました。このアルゴリズムは、追加の医療ケアを受けるべき患者を予測します。このシステムは、黒人患者よりも白人患者を優遇していることが判明しました。このアルゴリズムの開発上の問題は、導入前に主要な各人種で適切に検証されていなかったことです。
公平性と無差別のリスクを軽減するための戦略
包摂的設計と予見可能性
包摂的設計とは、設計プロセスにおける包摂を重視するものです。AI製品は、性別、人種、階級、文化などの多様な集団を考慮して設計されるべきです。予見可能性とは、AIシステムが現在および将来にわたって与える影響を予測することです。
米国医師会雑誌(JAMA)に掲載された最近の研究では、70本以上の学術論文をレビューし、臨床医学のいくつかの分野における医師の診断能力と、デジタル上の分身を比較しました。アルゴリズムの訓練に使用されたデータの多くは、マサチューセッツ州、カリフォルニア州、ニューヨーク州の3州のみから得られていました。このアルゴリズムは、より広い母集団にうまく一般化できるでしょうか。
多くの研究者が皮膚がん検出のアルゴリズムを懸念しています。大半のアルゴリズムは、主に肌の白い人々を対象に訓練されたため、肌の濃い人の皮膚がんの検出において十分に機能しません。皮膚がん検出モデルの開発者は、モデル開発において包摂的設計の原則を適用していませんでした。
ユーザーテストを実施する
テストは、新しい製品やサービスを構築する上で重要な工程です。この場合のユーザーテストとは、リリース前に、AI製品を利用する多様な集団の代表者にテストを依頼することを指します。
STEEPV分析
これは、外部環境の戦略分析を行う手法です。社会的(すなわち社会の態度、文化、人口動態)、技術的、経済的(すなわち金利、成長率、インフレ率)、環境的、政治的、価値観の頭文字をとったものです。STEEPV分析を実施することは、実際の公平性と無差別のリスクを検出する助けとなります。
世界経済フォーラムは、多様性、公平性、包摂性に関して何を行っていますか?
新経済社会センターは、経済と技術の変化が雇用、スキル、機会をどのように再編しているかを理解するため、リーダーをつないでいます。
センターは、共有された知見と協働を通じて、パートナーが移行期において人々と社会を支える包摂的な経済モデルを探求できるよう支援しています。
社会に存在する既存の偏見がアルゴリズムに引き継がれることは非常に容易です。機械学習において、人種や性別に基づく差別が容易に行われているのを目にします。企業組織は、生産性と業績の向上にAIを活用する中で、公平性と無差別を確保するためにより積極的に取り組む緊急の必要があります。考えられる解決策の一つは、開発チームにAI倫理の専門家を置き、多くの時間と費用を投じる前に、プロジェクトの早い段階で倫理的リスクを発見して軽減することです。




