OpenAIによる最新の研究では、機械学習エージェントを単純なかくれんぼのゲームに投入しました。エージェントたちは、姿を見るか見られるかという目標を達成するために、物体を予想外の方法で使い、工夫を凝らした競争を繰り広げました。この種の自己学習型AIは、現実世界でも役立つ可能性があります。
この研究は、研究者からの助言による干渉を一切受けずに、機械学習エージェントが現実世界に関連する高度な技術を学習する可能性を検証することを意図しており、実際にそれを成功裏に行いました。
写真内の物体の識別や、もっともらしい人間の顔の生成といったタスクは困難であり有用ですが、現実世界で人が取り得る行動を真に反映しているわけではありません。言わば、それらは高度に知的なタスクであり、その結果、コンピューターの外に出ることなく高い効果を達成できるのです。
一方で、ロボットアームを使ってカップをつかみ、ソーサーに置くようAIを訓練することは、想像以上にはるかに困難であり(非常に特定の条件下でのみ達成されています)、現実の物理世界の複雑さにより、コンピューター内に閉じた純粋に知的な学習によるタスクの習得は、ほぼ不可能になります。
同時に、現実世界を完全に反映しているわけではないものの、依然としてそれに関連しうる中間的なタスクも存在します。単純な例としては、関連する複数の物体や人物が提示された際に、ロボットが向きを変える方法が挙げられます。どちらも見えるように自身やカメラを回転させるか、両者を切り替えるなどの動作をするべきだと知るために、千回もの物理的な試行は必要ありません。
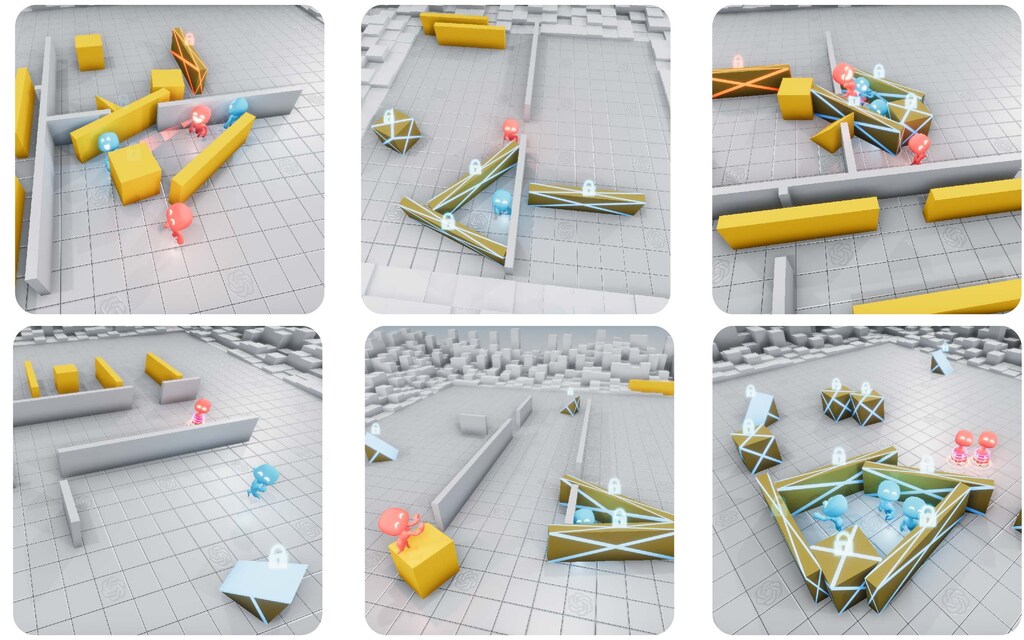
OpenAIが自社の幼い機械学習エージェントに課したかくれんぼの課題は、おおむねこのような方向性のものでした。単純なルールを持つゲーム環境(Polyworldと呼ばれます)であるにもかかわらず、現実世界に近い物理法則と入力を用いています。AIがこの簡略化された現実を自ら学習して進むことができれば、いくらかの修正を加えることで、その技能を本格的な現実世界に応用できるかもしれないという発想です。
実験の背景にある考え方はおおよそそのようなものですが、それ自体も十分に面白いものです。このゲームでは、小さな3D空間の中で2つのチームが互いに争います。そこには、ランダムに生成されたいくつかの壁や物体が配置されています。複数のエージェントが出現し、「隠れる側」は、環境に慣れて身を隠すために数秒間与えられます。また、物体と相互作用することもでき、物体を押したり、その場に固定したりできます。「探す側」が顔を上げると、隠れている者を見つけるまでに一定の時間が与えられます。
機械学習プログラムに知らされていたのは、基本的な感覚(各エージェントは世界を視覚的に捉え、近くの物体の位置を知るための一種の「ライダー」を持っています)と、物体を動かせるという知識だけでした。それ以外には、探す側または隠れる側のいずれであっても、任務に成功した場合にポイントが与えられるだけでした。それがエージェントの動機づけなのです。
こうした基本的な出発点から、非常に興味深い結果が生まれました。当初、チームは基本的にランダムに動いていました。しかし、何百万ものゲームを重ねるうちに、隠れる側は、ある特定の動き方(「やみくもに」逃げること)をすれば、より頻繁にポイントを増やせることに気づきました。こうして、競争が始まったのです。
隠れる側が逃げ回るようになったため、探す側はより構造化された追跡行動を発展させ始めました。そして、道具が登場したのです。
隠れる側は、フィールド上の物体を押したり引いたりできることに気づき、それらを使って砦を築き始めました。
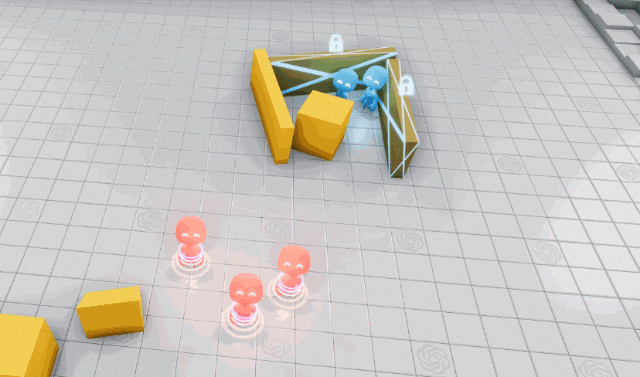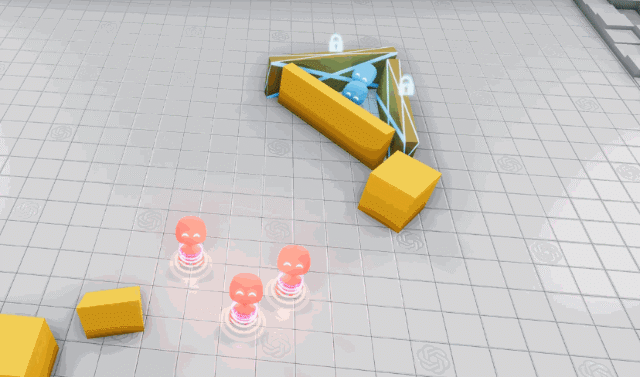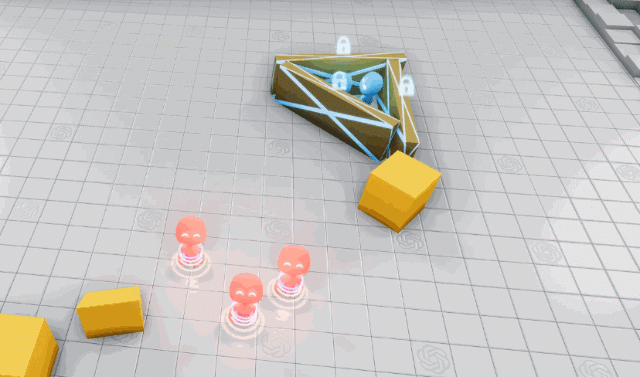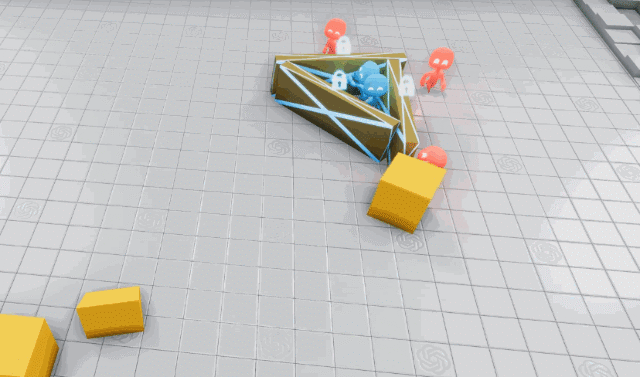
探す側は、フィールド上にあるスロープを使って物体の上に登り、砦を崩すことで対抗しました。
隠れる側は、探す側がまだ数えている間にスロープを探し始め、それを奪うか、その場に固定しました(この固定は敵チームのエージェントには解除できません)。興味深いことに、これにはある程度の分業が伴いました。両方の隠れる側がスロープを探しに行く時間が十分にないことが多かったため、一方が砦を準備し、もう一方がスロープの巡回に出る必要があったのです。
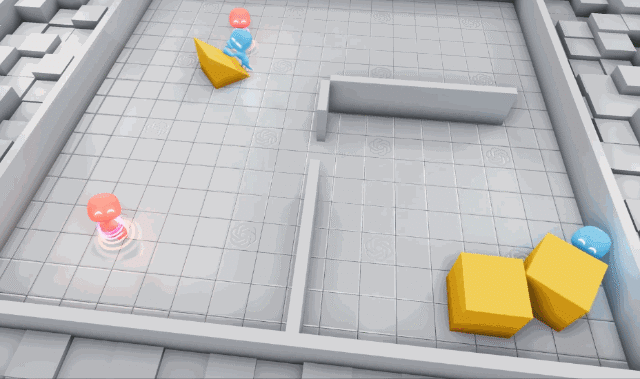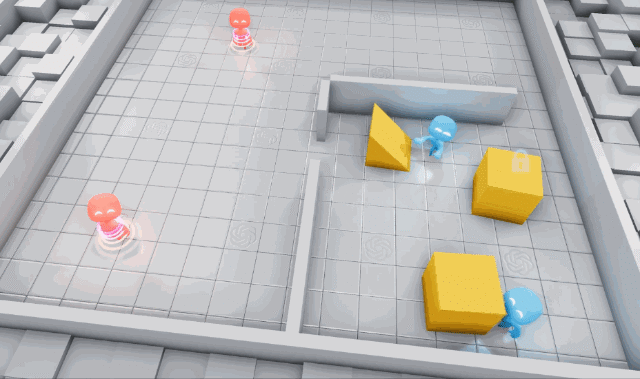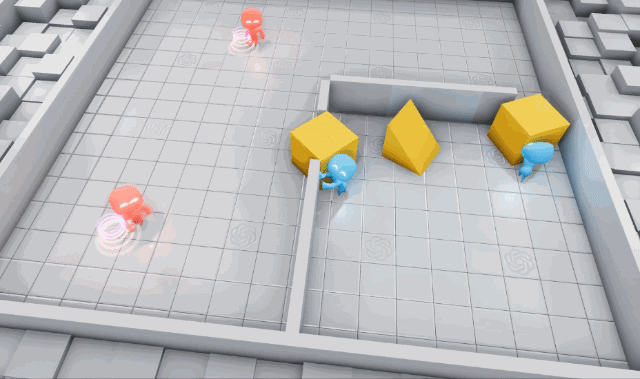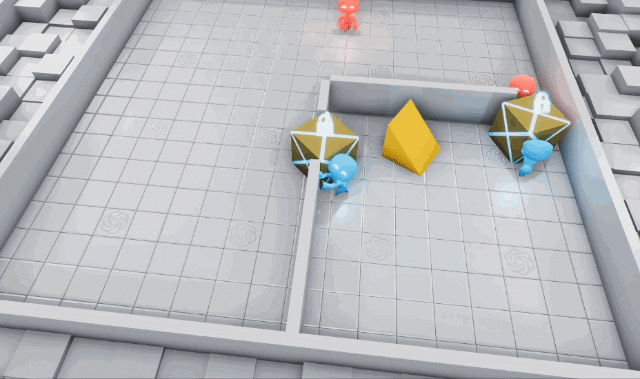
OpenAIのチームは、これで決着がついたと考えたかもしれませんが、探す側はゲーム世界の意図しない特徴を利用することを学びました。彼らは、箱の上に乗った状態で箱を「押す」ことができると発見したのです。これにより、箱をスロープの近くに置き、その上に登り、フィールド全体を「サーフィン」のように移動して、あの小賢しい隠れる側を見つけ出すことができました。

もちろん、隠れる側は、砦の建設に使っていないすべての物体をその場に固定することで対抗しました。そして、このゲームの戦略に関して、それが行き着く先のようです。
では、この研究の意義は何でしょうか。論文の著者が説明しているように、これは、私たちが辿り着いた方法のようなものです。
地球上の膨大な複雑さと多様性は、自然選択によって導かれた生物同士の共進化と競争によって進化してきました。新しく成功した戦略や突然変異が出現すると、隣接するエージェントが解くべき暗黙のタスク分布が変化し、適応のための新たな圧力が生まれます。こうした進化的な競争は、競合するエージェントが互いに新たなタスクを生み出し続ける、暗黙の自己カリキュラムを生み出します。
物理的な基盤を持ち、オープンエンドな環境において自己カリキュラムを誘導することは、最終的にはエージェントが人間に関連する無限の数のスキルを習得することを可能にするかもしれません。
言い換えれば、AIモデルを教師なしの方法で競わせることは、環境の探索率のような抽象的な数値を積み上げながら、単に自力でうろうろさせるよりも、有用で頑健なスキルを開発する、はるかに優れた方法かもしれません。
AIの能力のあらゆる側面を、パラメータ化して環境との相互作用を制御することによって、人間が指示することは、ますます困難か、あるいは不可能にさえなりつつあります。混雑した環境を移動するロボットのような複雑なタスクでは、考慮すべき要因が非常に多いため、人間が行動を設計しても、日常生活でエージェントが役割を果たすために必要な洗練さは決して生まれないかもしれません。
しかし、AIは互いに教え合うことができます。これはここで見たことや、GANsでも見られるとおりです。GANsでは、一対の対立するAIが、現実に近いメディアの生成または検出において、互いを打ち負かそうと競い合います。OpenAIの研究者は、他の方法では遅すぎたり、構造化されすぎたりする多くの状況において、「マルチエージェント型の自己カリキュラム」、すなわち自己学習型エージェントこそが前進の道であると提唱しています。研究者らは次のように結論づけています。
「これらの結果は、より開かれた多様な環境において、マルチエージェントのダイナミクスが極めて複雑で人間に関連する行動につながりうるという確信を与えてくれます。」
研究の一部はオープンソースとして公開されています。実験について記述した論文全文は、こちらからお読みいただけます。




