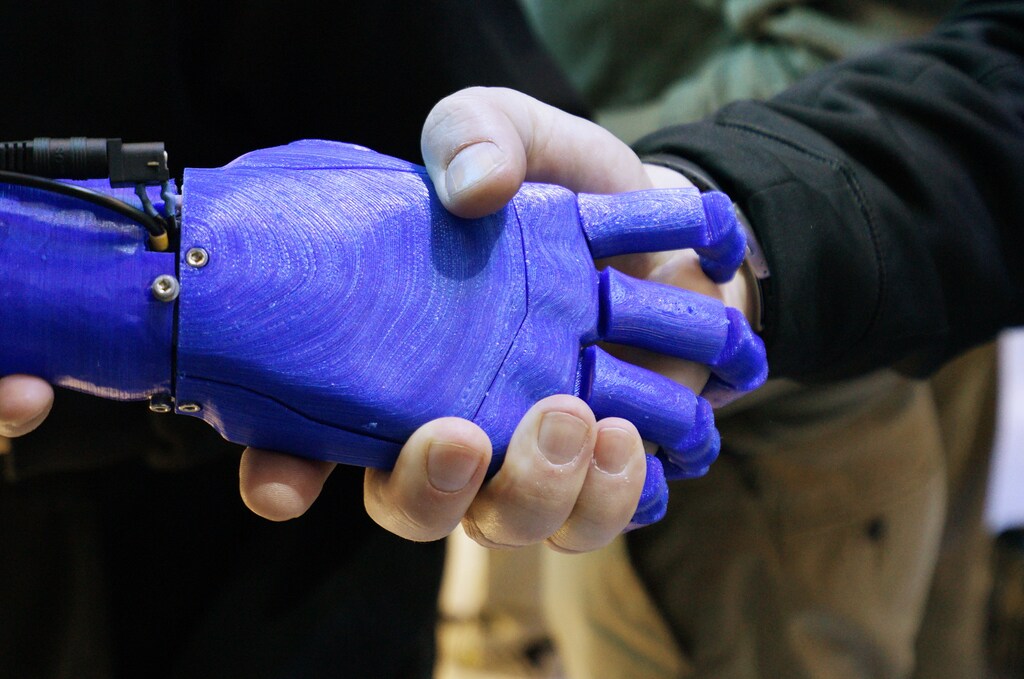
カナダの作家マーガレット・アトウッドの小説『盲目の暗殺者』では、」彼女は「触覚は視覚に先立ち、言語にも先立つ。それは最初の言語であり、最後の言語でもあり、常に真実を語る」と述べている。
触覚は物理的世界を感じ取る経路を私たちに与えるが、目は触覚信号の全体像を即座に理解する助けとなる。
見たり感じたりするようプログラムされたロボットは、これらの信号を完全に入れ替えて使うことはできない。この感覚のギャップを埋めるため、MITのコンピューター科学・人工知能研究所(CSAIL)の研究者らは、触れることで見る方法を学習し、見ることで感じる方法を学習できる予測型人工知能(AI)を開発した。
このチームのシステムは、視覚入力から現実的な触覚信号を生成し、その触覚入力から直接、どの物体のどの部分が触れられているかを予測することができる。研究チームは、MITの別のグループが設計した「GelSight」と呼ばれる特殊な触覚センサーを搭載したKUKA製ロボットアームを使用した。GelSight(MITの別のグループが設計)。
研究チームは、シンプルなウェブカメラを使用して、工具、家庭用品、布地などおよそ200点の物体に12,000回以上触れる様子を記録した。これら12,000本の動画クリップを静止画フレームに分割し、研究チームは300万枚以上の視覚・触覚のペア画像からなるデータセット「VisGel」を作成した。
「シーンを見ることで、私たちのモデルは平らな表面や鋭い縁に触れる感覚を想像することができる」と、システムに関する新たな論文の筆頭著者であるCSAILの博士課程学生Yunzhu Li氏は述べている。「周囲を手探りで触ることで、私たちのモデルは触覚のみから環境との相互作用を予測することができる。これら二つの感覚を組み合わせることで、ロボットの能力が高まり、物体の操作や把持を伴うタスクに必要なデータを減らせる可能性がある。」
ロボットにより人間に近い身体感覚を備えさせるための最近の研究としては、MITの2016年のプロジェクトがあり、ディープラーニングを用いて音を視覚的に示すことや、モデルが物体の物理的な力に対する反応を予測することなどがあるが、いずれも視覚と触覚の相互作用を理解するために利用できない大規模なデータセットを用いている。
研究チームの手法は、VisGelデータセットと、敵対的生成ネットワーク(GAN)と呼ばれる手法を用いることで、この課題を克服している。
GANは、視覚または触覚の画像を用いて、もう一方のモダリティの画像を生成する。「生成器」と「識別器」が互いに競合する仕組みで動作し、生成器は識別器を欺くために本物らしい画像を作り出すことを目指す。識別器が生成器を「見破る」たびに、その判断の内部的な理由を明らかにしなければならず、それによって生成器は繰り返し自己改善することができる。
視覚から触覚へ
人間は、物体を見るだけでその感触を推測することができる。機械にこの能力をより良く与えるため、このシステムはまず触れた位置を特定し、その後、その領域の形状と感触に関する情報を導き出す必要があった。
ロボットと物体の相互作用を伴わない参照画像は、システムが物体と環境の詳細を符号化するのに役立った。その後、ロボットアームが動作しているとき、モデルは現在のフレームを参照画像と単純に比較し、触れた位置と規模を容易に特定することができた。
これは、コンピューターマウスの画像をシステムに入力し、モデルが拾い上げるために触れるべきだと予測する領域を「見る」ようなものかもしれない。これにより、機械はより安全で効率的な動作を計画する上で大いに役立つ可能性がある。
触覚から視覚へ
触覚から視覚への変換では、触覚データに基づいて視覚画像を生成することがモデルの目的であった。モデルは触覚画像を分析し、接触位置の形状と素材を特定した。その後、参照画像に立ち返り、その相互作用を「幻覚的に」再現した。
例えば、テスト中にモデルに靴の触覚データを入力した場合、その靴が最も触れられやすい箇所の画像を生成することができる。
この種の能力は、例えば照明が消えている場合や、人が箱や未知の領域に手探りで手を入れる場合など、視覚データが存在しない状況でのタスク遂行に役立つ可能性がある。
今後の展望
現在のデータセットは、管理された環境での相互作用の例しか含んでいない。研究チームは、より非構造化された領域でデータを収集するか、MITが新たに設計した触覚グローブを使用することで、データセットの規模と多様性をさらに高めることを目指している。
モードを切り替えることで推測が難しい詳細も依然として存在する。例えば、物体に触れるだけで色を判断すること、またはソファを押さずにその柔らかさを判断することなどである。研究者らは、起こりうる結果の分布を拡張するため、不確実性に対するより堅牢なモデルを構築することで、これは改善できると述べている。
今後、このタイプのモデルは、特に物体認識、把持、より優れたシーン理解、支援や製造の現場におけるシームレスな人間とロボットの統合を助けることで、視覚とロボティクスのより調和的な関係の構築に役立つ可能性がある。
「視覚信号と触覚信号の間で説得力をもって変換できる初めての手法だ」と、カリフォルニア大学バークレー校のポスドク研究員Andrew Owens氏は述べている。「この種の手法は、『この物体は硬いか柔らかいか』や『このマグカップを取手で持ち上げたら、どれほどしっかり握れるか』といった問いに答える必要があるロボティクスにおいて、非常に有用となる可能性がある。信号が大きく異なるため、これは非常に困難な課題だが、このモデルは優れた能力を示した。」
Li氏は、MITのRuss Tedrake教授およびAntonio Torralba教授、ならびにMITのポスドク研究員Jun-Yan Zhu氏とともに本論文を執筆した。来週、カリフォルニア州ロングビーチで開催されるコンピュータービジョンとパターン認識に関する国際会議(The Conference on Computer Vision and Pattern Recognition)で発表される予定である。




