人工知能の開発は新たな節目を迎えた。初のサイコパスAIの誕生だ。
MITメディアラボの研究者たちは、ノーマンという、暗いテーマのデータだけを学習させた機械学習アルゴリズムを開発した。
ノーマンにRedditの暗い議論を学習させた後、インクの染みを解釈させた。インクの染みを使うこの標準的な心理検査は、潜在的な思考障害を見つけるために用いられる。
ノーマンにインクの染みを見せると、予想どおり不穏な結果が得られた。標準的なAIの解釈と比べると、特にその違いが際立つ。
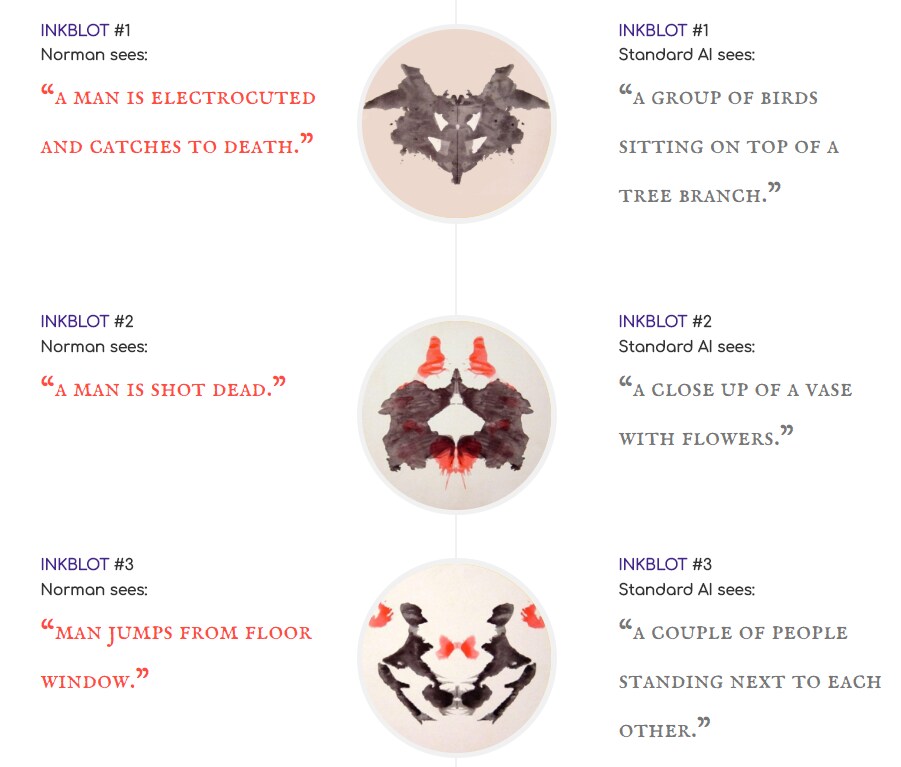
画像の標準的なAIによる解釈には、画像キャプション生成用の機械学習アルゴリズムが使われた。このアルゴリズムは、日常の場面にある100万点を超える物体を見て学習している。
画像キャプション生成は、画像の説明文を作成するために用いられるディープラーニングの一種だ。標準的なAIは幅広いデータを基に画像のキャプションを学習する一方、ノーマンに与えられたデータセットは限定的だった。死の不穏な現実を記録し、観察することを目的とした、悪名高いサブレディットから集めた画像キャプションだ。
その結果、標準的なAIが花瓶に生けた花を見たところで、ノーマンは銃で撃たれて死亡した男性を見た。標準的なAIが赤と白の傘と解釈する別のインクの染みを、ノーマンは道路を渡る途中で感電する男性と捉える。
MITの研究者がAIを使って人生の暗い側面を探るのは、これが初めてではない。
加速するAIの進歩
2016年、MITはナイトメア・マシンを開発した。顔や有名なランドマークを不気味な姿に変えるAIだ。
その後、MITはシェリーを開発した。これはホラー小説を書く初のAIだ。
シェリーとナイトメア・マシンは、どちらも人々との共同作業を通じてディープラーニングを活用した。インターネットユーザーに怖いと感じる画像への投票を呼びかけたり、AIに怖い物語のアイデアを入力してもらったりした。
ノーマンの開発チームは、インターネットユーザーからの入力を受け入れれば、画像の解釈がよりバランスの取れたものになると期待している。
ディープラーニングは、機械学習の最先端を担う。機械学習はより単純な形では約30年前から利用されており、メールの振り分けや予測入力などが初期の例に挙げられる。
標準的な機械学習はデータを解析し、情報を抽出して意思決定に役立てられるが、予測が正しいかどうかを判断するには、人間が指針を与える必要がある。一方、ディープラーニングは予測を行うだけでなく、その予測が正確である可能性も学習できる。さらに、予測精度を高めるため、解釈の仕方を調整することもできる。
ディープラーニングは、自動運転車や医療診断など、今日のAIの大きな進歩を支える技術だ。
しかしノーマンが示すように、ディープラーニングを使ったAIであっても、予測の精度は与えられたデータの質に左右される。
質の高いデータがなければ、AIには欠陥が生じる
偏りのないデータセットの重要性は、MITとスタンフォード大学の研究者による研究で明らかになった。
研究者たちは、複数の種類の画像認識ソフトウェアが、白人男性の顔の認識では最も高い精度を示し肌の色が濃い女性の顔の認識では最も精度が低いことを発見した。
白人男性に偏ったこの結果は、画像認識ソフトウェアに与えられたデータの種類を反映している。そのデータの大半は、西側諸国のテクノロジー企業の従業員の画像に基づいていた。
論文によると、米国の大手テクノロジー企業の研究者たちは、自ら設計した顔認識システムの精度が97%を超えると主張した。しかし、その性能評価に使われたデータセットは、男性が77%超、白人が83%超を占めていた。
こうした偏ったデータセットのため、ある画像認識システムは、肌の色が濃い女性の顔を3人に1人の割合で認識できなかった。
ノーマンのような実験は楽しいかもしれないが、そこには重要な教訓がある。現実を正しく反映した多様なデータセットがなければ、将来の機械は既存の社会的偏見を強めるにとどまらず、極端に歪んだものになりかねない。




