人工知能(AI)システムの開発には、偏りが生じ、深刻な問題を引き起こすことが少なくありません。最近では、黒人の一部をゴリラと分類したGoogleのAIアルゴリズムや、停止に追い込まれたMicrosoftのTwitterボット「Tay」が、わずか16時間で人種差別的な発言を学習した事例が示しています。
AIは数学的な計算に基づいているため客観的だというのは誤解です。AIシステムの構築は、本質的に人間が主導するプロセスです。そのようなシステムに偏りが含まれるのは避けられません。
上記の例のようにAIに明らかな偏りがある場合、それを修正できることは少なくありません。この修正の過程から、AIの核心はアルゴリズムではなく、それを操作する人間にあることが分かります。より微妙な偏りが生じている多くの場合、システムの修正ははるかに難しくなります。
AIアルゴリズムにおける一見ささいな選択が、結果を大きく変えうることを示す例を考えてみましょう。広く利用されている人気の高い人事データセットには、従業員が会社を辞める決断に影響した9つの要因について、15,000件の観測データが含まれています。要因には、従業員の満足度、担当しているプロジェクトの数、勤続年数などがあります。こうしたデータは、従業員の定着に向けて資源をどう配分するのが最善かを判断しようとする経営幹部にとって有用です。
従業員の定着を支援するためにAIを活用したい管理職は、人気の高い2つの機械学習手法、ロジスティック回帰とニューラルネットのどちらかを選ぶかもしれません。ロジスティック回帰アルゴリズムは、統計的に関連性のある変数群に基づいて、ある事象が起きるか(つまり、退職するか、在職し続けるか)を予測しようとします。一方、ニューラルネットは生物学に着想を得た手法で、変数(特徴量とも呼ばれます)間の重要な関係を明らかにするデータ内のパターンを見つけようとします。両方のアルゴリズムをこの人事データセットに適用すると、予測精度はいずれも94%となり、性能面ではどちらも優れているとはいえません。
しかし、下の表が示すように、両者は管理職にまったく異なる行動方針を提示します。表の緑色のセルは従業員の退職の背後にある可能性が最も高い要因を、赤色のセルは最も低い要因を示し、各割合はそれぞれの理由がどの程度ありそうかを表しています。
ロジスティック回帰を見ると、管理職は、従業員が担当するプロジェクトの数や、労働災害に遭ったことがあるかどうかに注目すれば、従業員の定着率を高められると考えるかもしれません。しかし、ニューラルネットでは給与が主要な要因となります。ロジスティック回帰では、給与が定着率に影響する可能性は低いと示されていたにもかかわらずです。
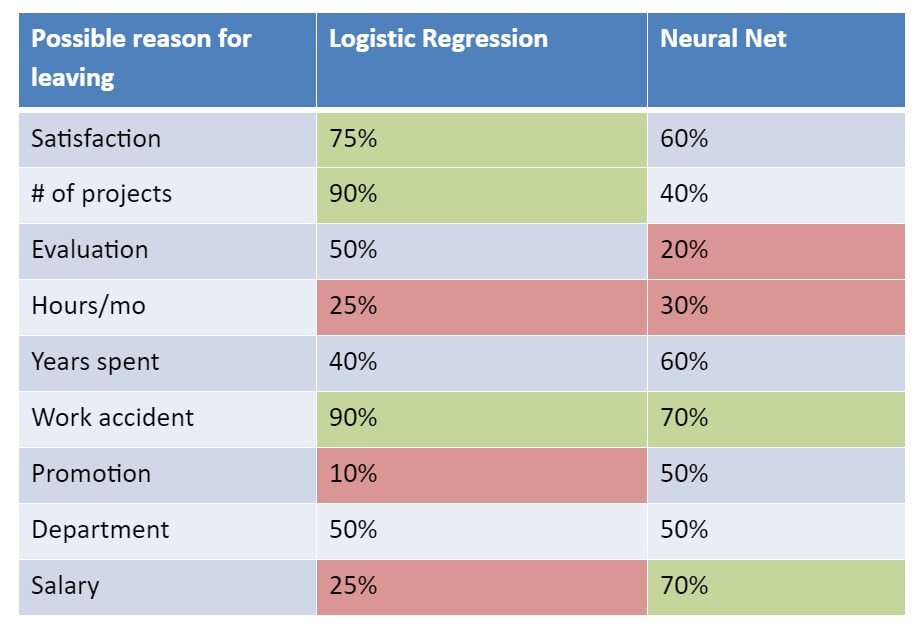
では、管理職はどちらのモデルを信頼すべきでしょうか。会社は仕事への満足度を高め、プロジェクトの数を減らし、労働災害を減らすために投資すべきでしょうか。それとも、給与を上げ、労働災害を減らすのが最善の策でしょうか。このケーススタディでは、アルゴリズムの選択(統計的にはどちらも同等に正しいことを思い出してください)が、会社の資源配分に大きな影響を与えることは明らかです。
アルゴリズムを選ぶ方法や理由には、妥当な根拠があることも多いものの、選択は、大学で何を学んだか(その内容は決して標準化されていません)や、上司が従業員に何を使わせたいか(上司自身が最もよく理解していることが多いため)に慣れているかどうかで決まる場合も少なくありません。さまざまな種類のデータ分析について、原則に基づく文書化された手法を整え、各手法の強みと限界を理解し、標準化された方法でその適用について従業員を教育すれば、企業のこうした取り組みを大きく後押しできるでしょう。しかし、こうした新たなAI部門やプロセスを立ち上げるのは、この分野で十分な有資格者の採用に苦労している企業にとって、大きな難題となる可能性があります。
適切な条件がそろえば、AIは驚くべき力を発揮します。大量のデータがあれば、AIアルゴリズムは、人間には認識できない関係性(医療画像に写った腫瘍など)や、人間よりもはるかに早く認識できる関係性(車が衝突しそうな状況など)を明らかにできます。しかし、AIは非常にもろい面もあります。作り手である人間が定義し、調整した比較的狭い条件の範囲を外れると、劇的な失敗を招くことがあります。さらに、音声認識などのAI応用では、結果が正しいかどうかを高い確度で判断できますが、人間の意思決定を推定しようとするAI応用では、同じことは言えません。
アルゴリズムは、さまざまな統計パラメーターをどう初期化するか(その選択にはある程度恣意的なところがあります)を決めるエンジニアやコンピューター科学者によって作られ、その後、望ましい結果を得るために特定のデータセットに合わせて調整されます。場合によっては、アルゴリズム全体の予測精度を高めるため、人間が指定したラベルを個々の事例に割り当てます。こうした主観が入りやすいパラメーターは、AIアルゴリズムの脆弱性につながり、予期しない条件下での失敗を招くことがあります。交通の流れにうまく合流する方法を理解できず、バスに衝突したGoogleの自動運転車が最近起こした事故は、まさにその一例です。
見過ごされがちなAIの偏りの原因の一つは、アルゴリズムの結果を人間が解釈することです。複雑なAIアルゴリズムは、『マトリックス』映画シリーズに登場する有名な数字の奔流を思わせる、確率の集合や数値のクラスターを生成します。統計的推論に詳しい人間の専門家は、これらの数値に文脈に即した意味を与え、その解釈方法を他の人間やコンピューターに指示しなければなりません。そうした指示は、しばしば組み込みアルゴリズムの形を取ります。この相互依存関係のため、AIシステムが特定の動作をした理由を再構成するのは非常に難しく、先行する人間の解釈レイヤーによって加えられた偏りが隠れてしまうことがあります。結果や、解決可能な範囲の限界を説明することも非常に困難です。
研究者たちはこうした難しさを認識し始めており、「説明可能なAI」と呼ばれる新たな分野が生まれています。研究者たちは、AIが依拠するアルゴリズムや確率的推論の大半が非常に理解しにくいことを踏まえ、原因と結果をより理解しやすくするため、AIアルゴリズムの推論をどのように設計、表現すればよいかを探っています。
産業界は、説明可能なAIに関する新たな要件を定めることで、この新興分野を支援できます。それにより、エンジニアやコンピューター科学者が、自分たちにしか理解できない巧妙な新しいアルゴリズムで競い合うのではなく、人間の意思決定者とアルゴリズムから成るAIシステム全体を重視するよう促せます。医療機器、自動車、航空機、列車といった安全性が極めて重要な用途に加え、金融取引やスマートホームにまでAIの活用が広がるなか、AI搭載システムがいつ、どこで失敗する可能性があるのかを伝える方法を見つけ、脆弱なシステムではなく、しなやかで強靭なシステムを開発することが不可欠です。




