世界中のいたずら好きな人々の注目を集めるニュースとして、今や、コンピュータープログラムによって、人が話す様子をリアルに再現した動画を作成できる。
ワシントン大学の研究者たちは、既存の音声と映像を組み合わせた、リップシンク動画を、バラク・オバマ元米大統領を題材に作成し、その技術を実証した。
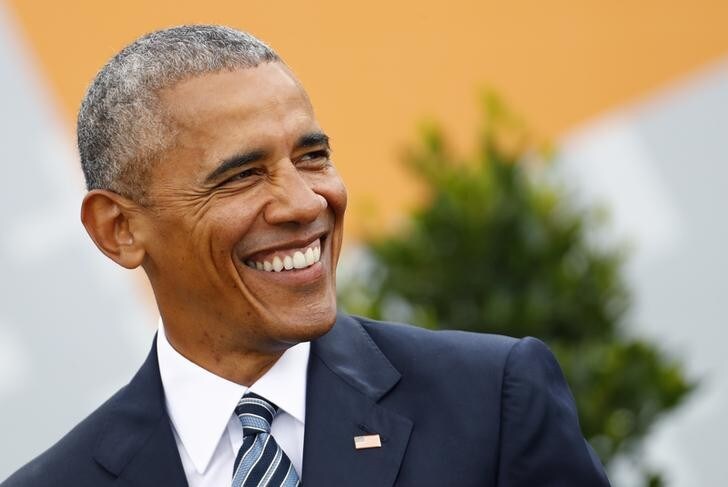
このプログラムは人工知能(AI)を使い、人の話し声の音声にリアルな口の形を合わせ、それを既存の動画に合成する。ストック映像の何百万もの動画フレームを分析し、口の形や音のパターンを調べることで、非常にリアルなシミュレーションを作り出せる。
映画業界での活用
研究者らによると、この技術は特殊効果に活用できる可能性がある。現在、音声を映像に変換するには、多くの人に同じ文章を話してもらって撮影し、音と口の形の相関を見つけようとする。手間と時間がかかるうえ、映像はかなりリアルでも、十分にリアルとは言えない「不気味の谷」の問題も生じる。説得力があるように見えるどころか、不気味に感じられがちだ。
この技術は、画質の悪いビデオ通話の体験を改善する可能性もあり、聴覚障害のある人が電話越しの音声から生成した映像を読唇できるようにするなど、応用が期待される。
研究チームはまた、プロセスを逆にすることで、つまり音声だけでなく映像をプログラムに入力することで、動画が本物か偽物かを検出するアルゴリズムを開発できる可能性があると見積もっている。
目指すのは、アルゴリズムを改良してさまざまな状況に対応させ、より少ないデータで人の声や話し方のパターンを認識できるようにすることだ。たとえば、現在は14時間分の映像が必要だが、学習に使う映像を1時間分にすることを目指している。
このプログラムで動画を作成できるのは、同じ人物が話した言葉をもとにする場合に限られる。まだ、自分の言葉を他人の口に語らせることはできない。




